あなたの言語を、AI に書き間違えさせない
7言語のネイティブ審査者を募集。AIがあなたの言語を正しく書けているか30枚ずつ確認し、名前入りで公開データセットへ。
アラビア語、日本語、中国語、英語、スペイン語、ポルトガル語、ドイツ語のいずれかをネイティブとして読める方に、手伝ってほしいことがあります。画像生成AIはいま、これらすべての言語で文字を書きます。なのに、その言語を実際に読める人で結果を確かめている人はほとんどいません。私たちはすべての画像とすべての判定を公開データセットで公開しています。どれが正しいかを教えてくれるネイティブの読み手が必要です。
1バッチは約30枚で、約10分で終わります。回答はあなたが選んだ名前でデータセットに入ります。参加するには、[email protected]にメールで、ネイティブとして読める言語を教えてください。
AIは何を間違えるのか
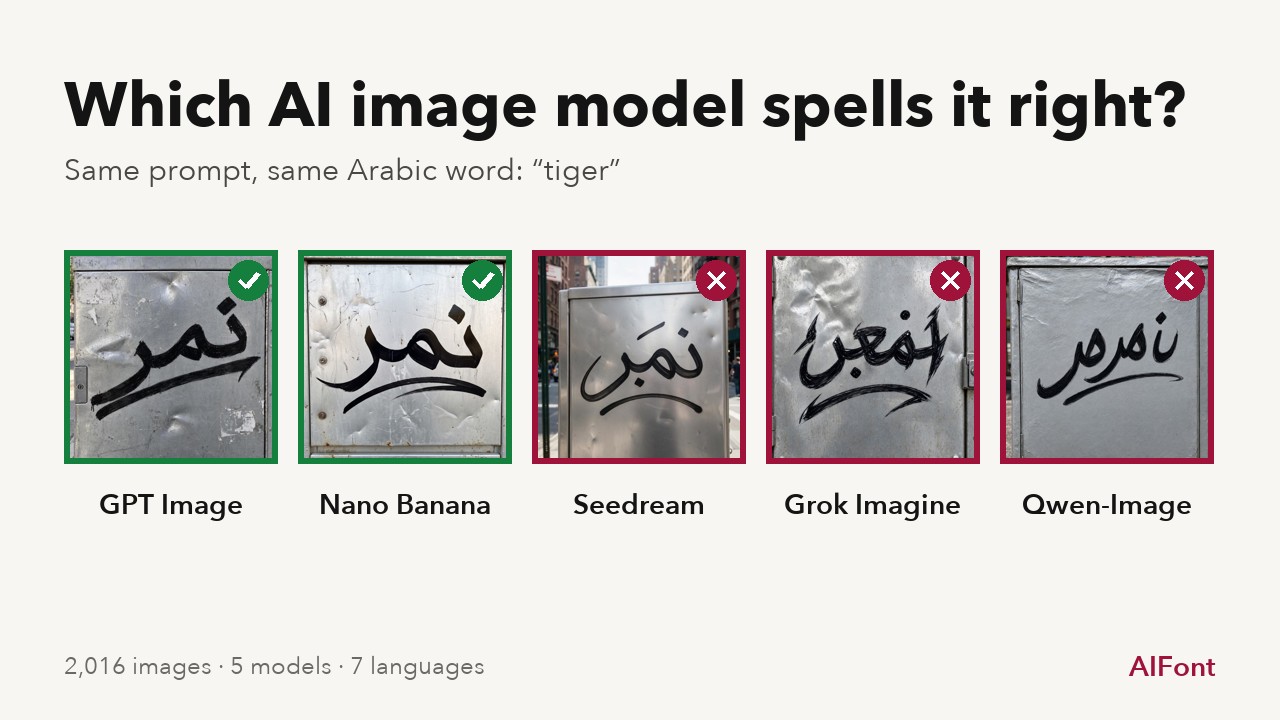
AIはいま、世界中の人の代わりに文字を書いています。ポスター、看板、グリーティングカード、スライド、さらにはアラビア書道まで。けれど画像モデルがきちんと練習してきたのは、ごく一部の文字だけです。5つの画像モデルを比べた私たちのテストでは、英語、ドイツ語、スペイン語、ポルトガル語、中国語の短い単語で、どのモデルも90%を超えました。
差が開くのはアラビア語です。各モデル57〜59回の初回生成のうち、正しく書けたのはGPT Imageが53語、Nano Bananaが55語、Grok Imagineが42語、Seedreamが54語中34語、Qwen-Imageが59語中8語でした。日本語は差が小さいものの、5モデル中3モデルは59語中7〜14語を間違えました。
間違いは小さなものです。点の位置がずれる、2つの文字のつながり方がおかしい、かなに濁点が付く(ばくはつがばくばつになる)。ぱっと見は本物の文字に見えます。でも点ひとつでアラビア語の単語は別の単語に変わり、それに気づけるのはアラビア語を読める人だけです。
なぜネイティブの読み手が必要なのか
テストの画像はすべて、まずAI審査者が読みます。アラビア語、中国語、日本語は拡大して確認します。次に、判定を誤りやすいものを人が見直します。アラビア語の画像は全部です。その人は私たちのメンバーで、これらの言語のほとんどはネイティブではありません。
2026年11月、アラビア語ネイティブの審査者が、私たちのテストで生成したアラビア語の初回生成291枚すべてを、バッチAR-001で審査しました。審査者に見えていたのは各モデルに書かせた単語だけで、モデル名や私たちの判定は伏せてありました。私たち自身の判定(人が見たものは人の判定、人が見ていないものはAIの判定)と比べた結果は次のとおりです。
| ネイティブの判定 | 枚数 |
|---|---|
| 私たちと一致 | 254 |
| 誤り(私たちは正しいと判定) | 11 |
| 正しい(私たちは誤りと判定) | 12 |
| 判断できない | 14 |
このうち41枚は、AI審査者と私たちの判定が分かれたため、正答率の表から外していた画像です。ネイティブの読み手はそのうち34枚に決着をつけました。私たちの判定が一致していたもののうち、審査者が確信を持てた243枚では、5枚の判定が覆りました。審査者が確信を持てたものは、いまはその判定が最終判定です。
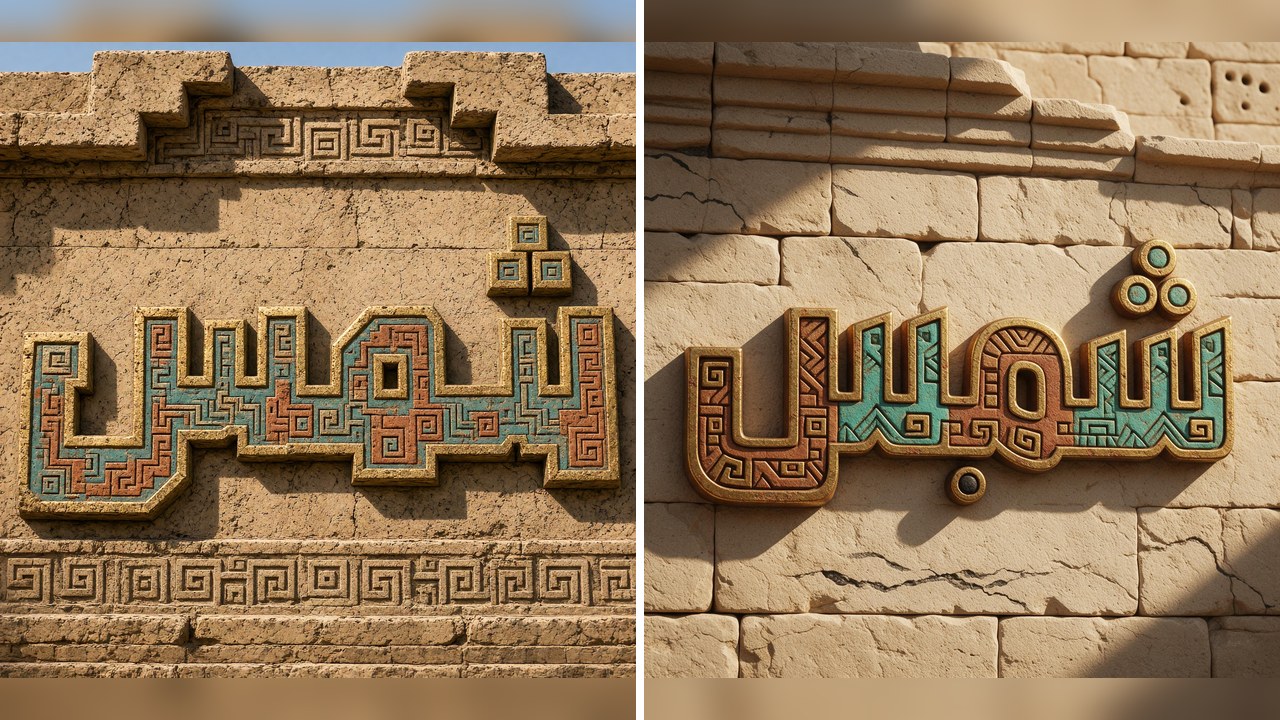
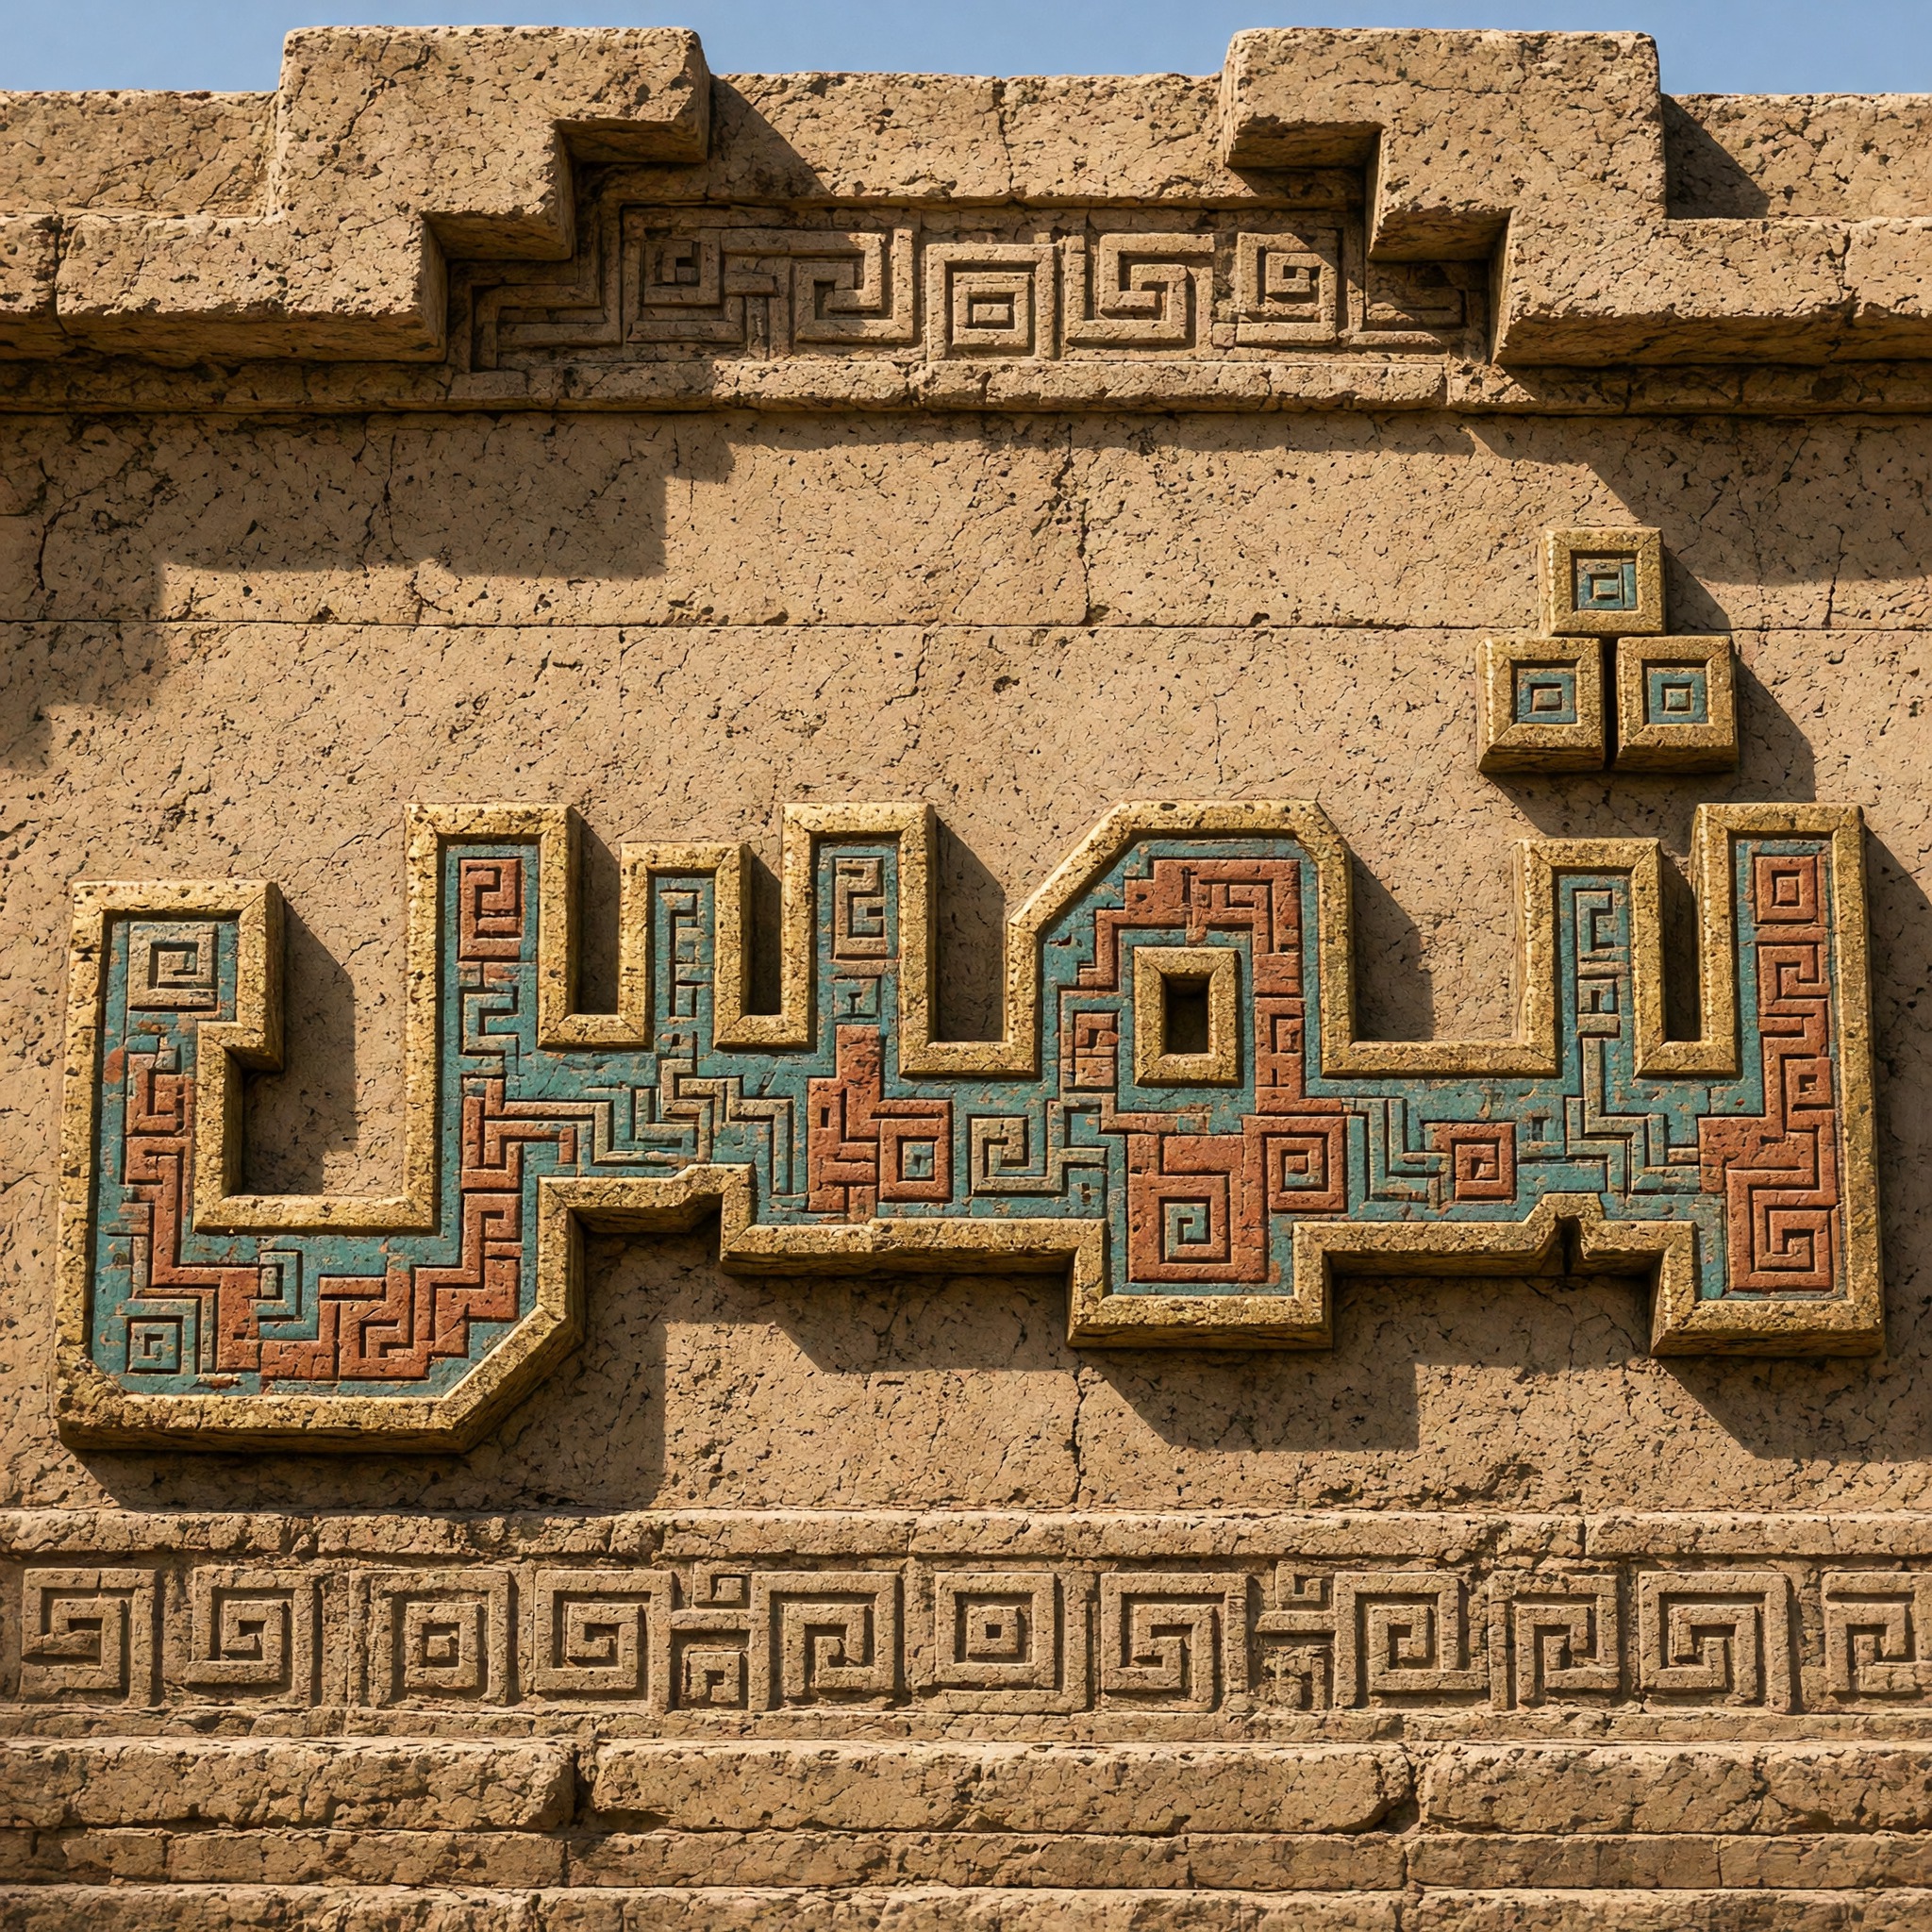
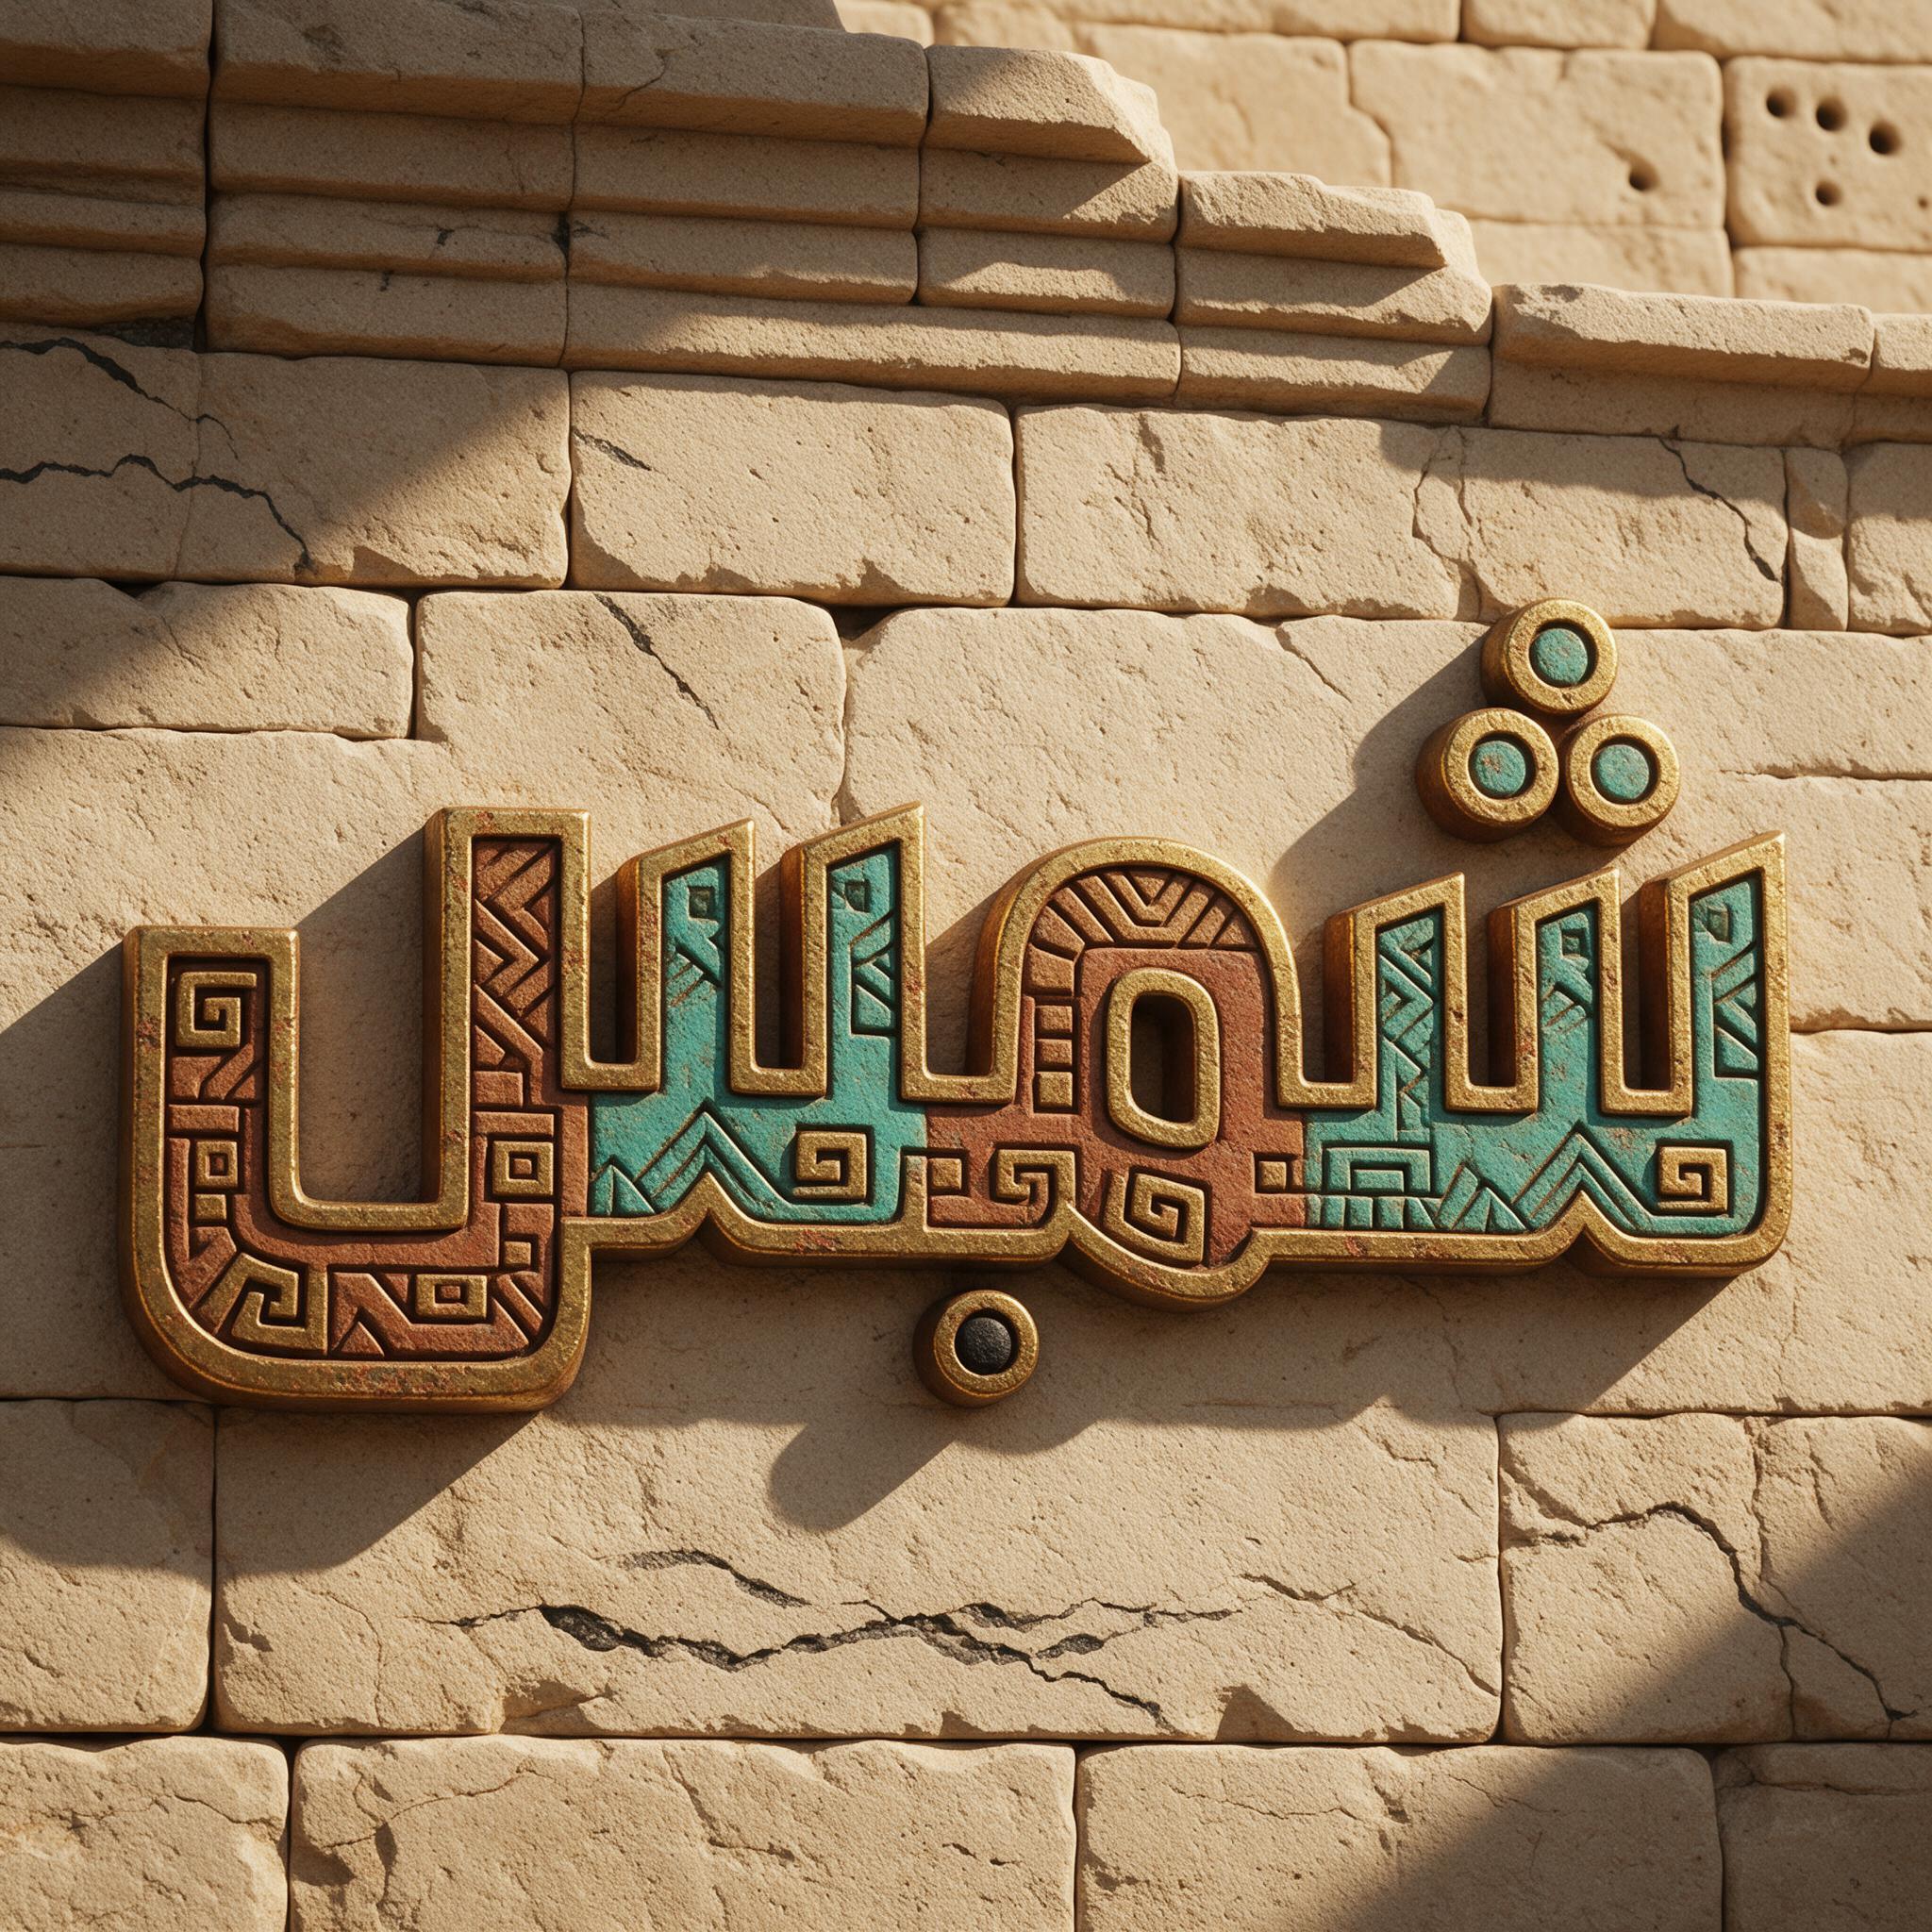
下の2枚を見ると理由がわかります。どちらのモデルにも同じアステカフォントのプロンプトを渡し、شمس(太陽)と書かせました。私たちは1枚目を合格、2枚目を不合格にしました。ネイティブの読み手の判定は逆でした。
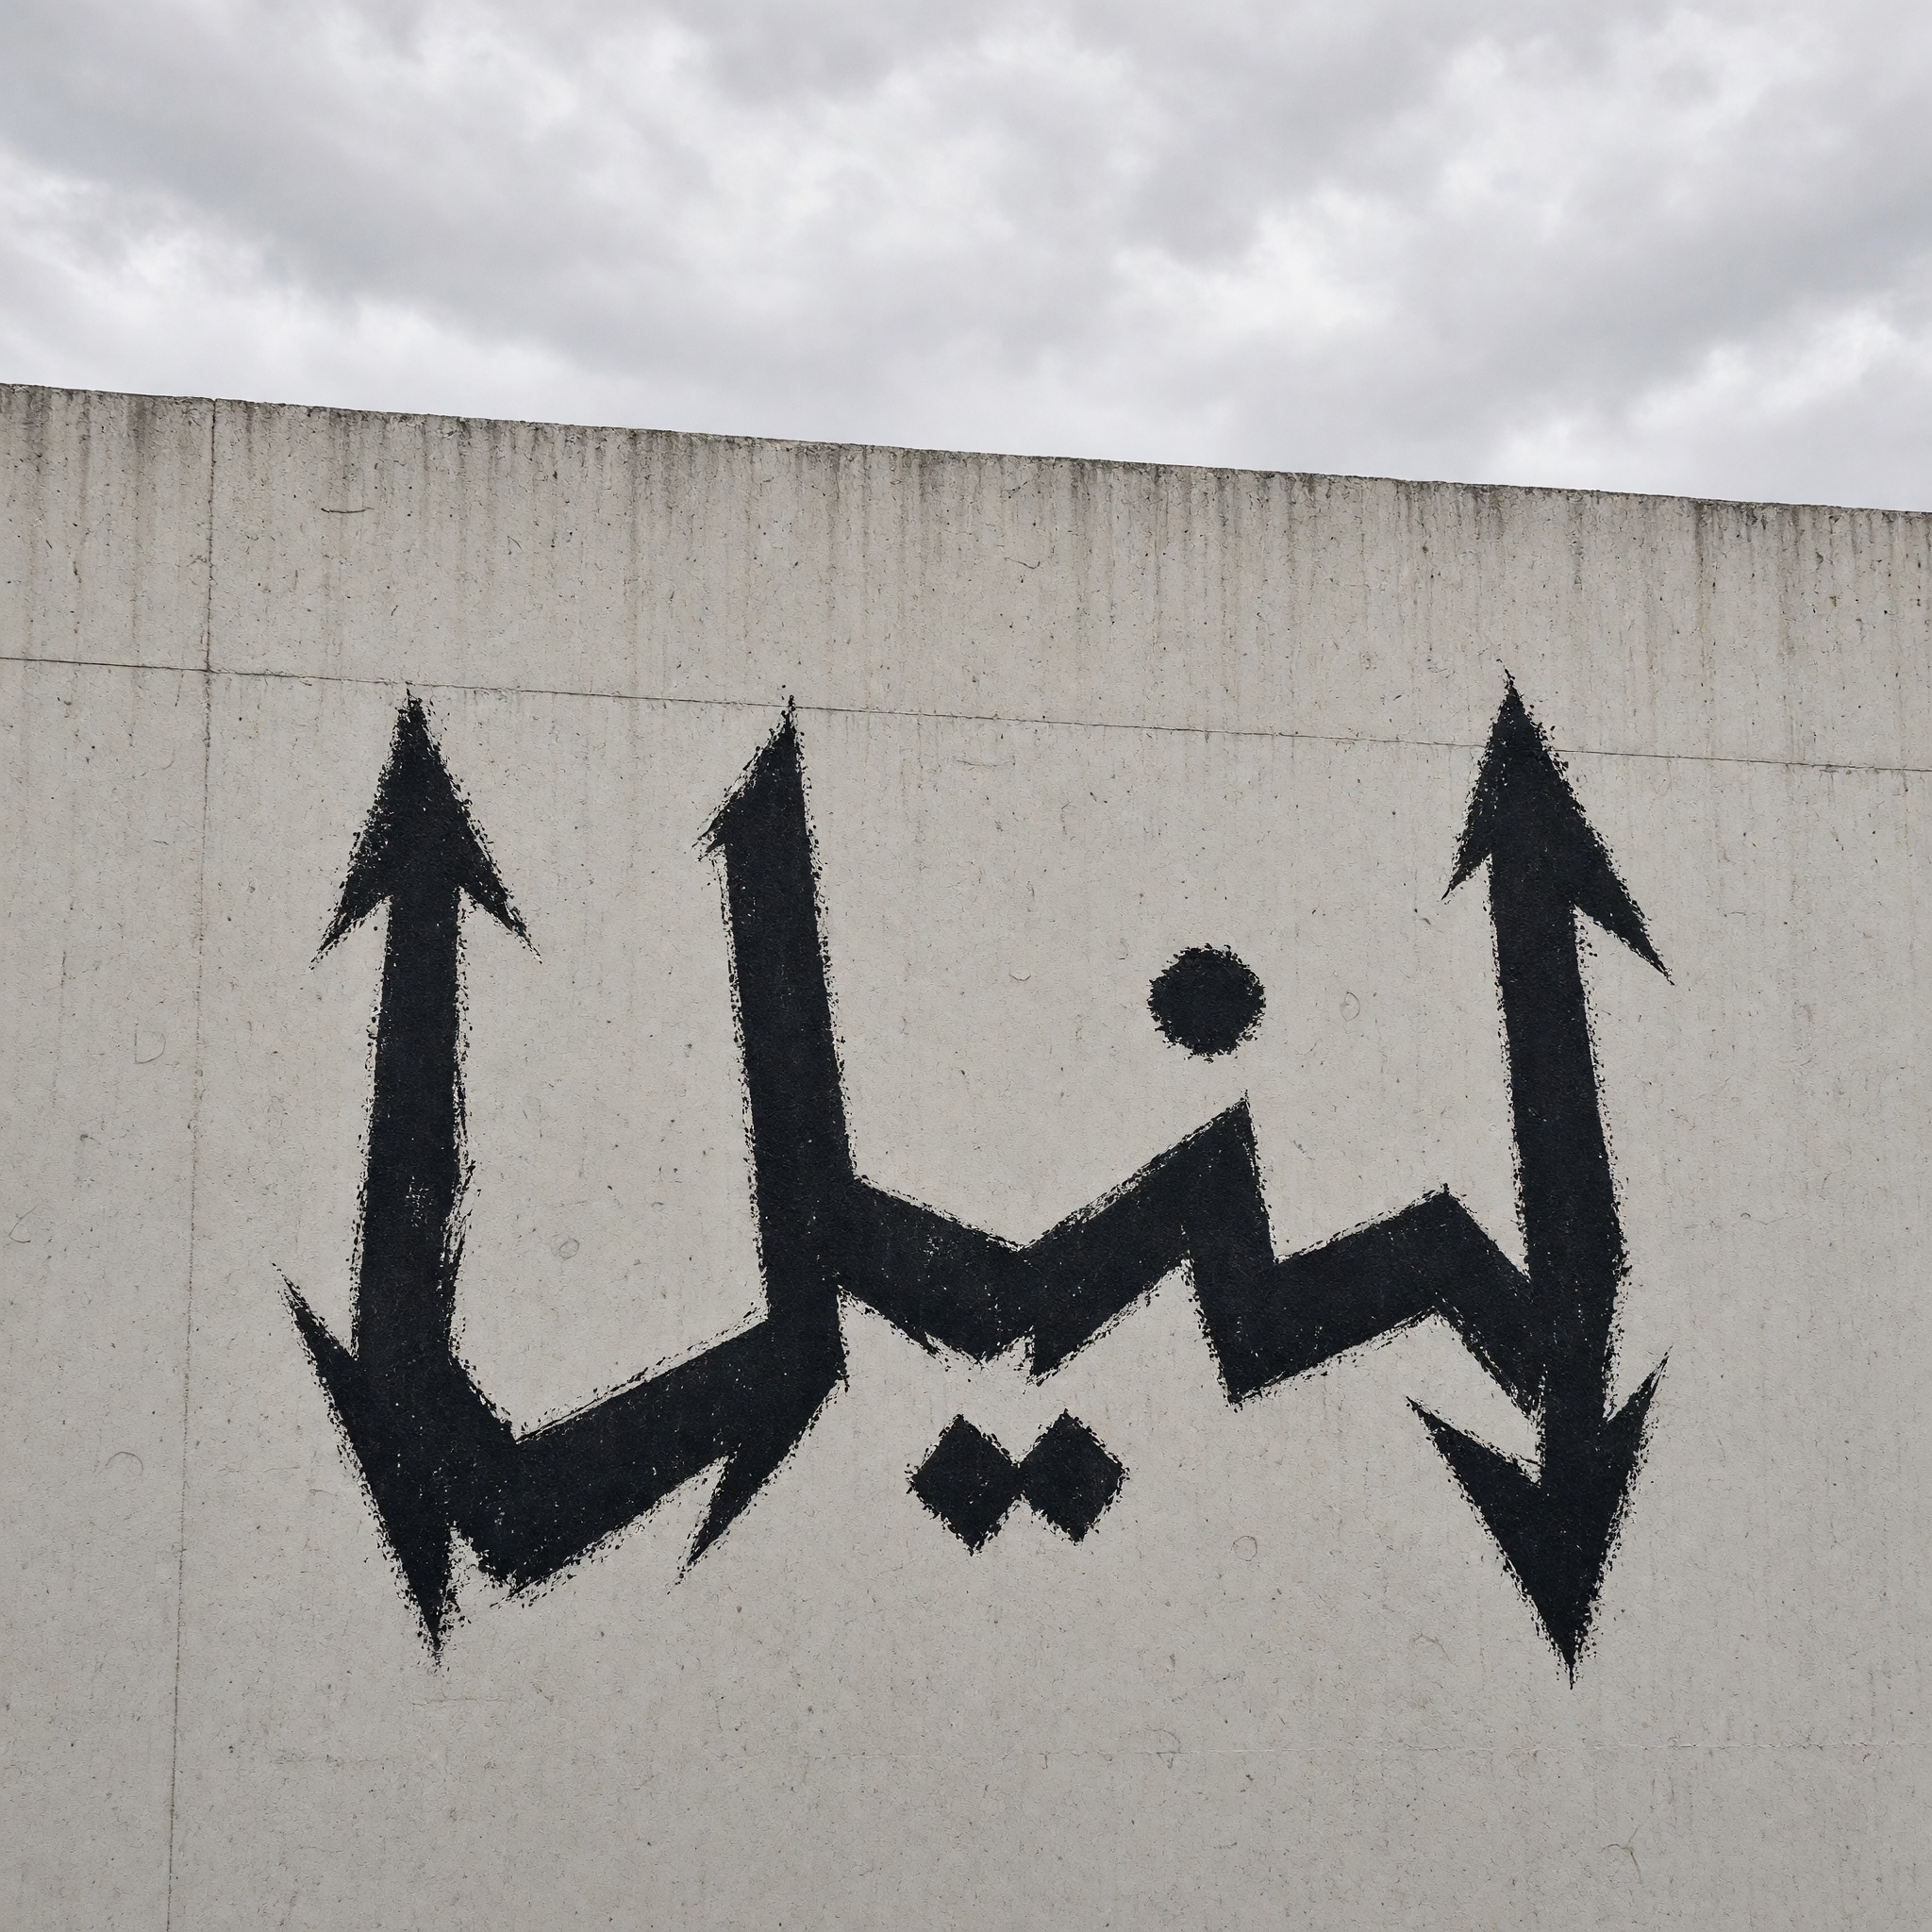
装飾が強いほど、判断は難しくなります。pichaçãoの壁のタグで、Grok Imagineが書いたこのليل(夜)は、私たちの2つのチェックでどちらも不合格でした。ネイティブの読み手は正しいと読みました。
アラビア語をよく読めないAIと、アラビア語のネイティブではない人は、同じ種類の間違いをします。単語ではなく形で判断してしまうのです。ネイティブの読み手は単語で判断します。リストにあるほかの言語でも同じです。
あなたの審査が果たすこと
私たちは文字ごとに一つずつテストし、すべての画像とすべての判定をAIFont文字レンダリングデータセットとしてGitHubで公開し、Zenodoにもアーカイブしています。ライセンスはCC BY 4.0です。各レコードには審査者ごとの判定を別々に残しているので、誰でもそれぞれを比べて重みづけできます。正答率の表はこのデータセットから再計算します。
こうした誤りは、モデルを作る側ではなかなか気づけません。その言語を読める人が確認した、どのモデルがどの単語を間違えたかという公開の記録は、モデルを作る人が見えて、無視できず、直せるだけの証拠になります。
あなたの判定の一つひとつが、同じ言語を話す人たちの声になります。判定はあなたが選んだクレジットで記録されます。実名、ペンネーム、匿名のどれでも選べます。
バッチの進め方
- 1バッチ1言語、約30枚、約10分。 AR-001では、審査者は1枚あたり平均11秒でした。
- 各画像について、モデルに書かせた単語が表示されます。 答えるのは3つです。つづりは正しいか。正しくなければ、どこが違い、画像には実際に何と書いてあるか。その文字は実在する単語か。
- モデル名とそれまでの判定は伏せてあるので、あなたの判定はほかに左右されません。
- 回答はその都度下書き保存されます。 バッチに署名して提出するまでは確定しません。
- 同じバッチを複数の審査者がそれぞれ判定できるので、答えを突き合わせられます。
アラビア語、日本語、中国語、英語、スペイン語、ポルトガル語、ドイツ語のバッチを公開中です。審査待ちの画像がいちばん多いのはアラビア語です。バッチはaifont.ai/native-reviewで誰でも見られます。
参加するには
[email protected]にメールで、ネイティブとして読める言語を教えてください。その言語の審査者アカウントを用意するので、その言語で公開中のバッチならどれでも受け取れます。貢献として参加してもらえたらうれしいですが、時間に対して報酬が必要な場合は、同じメールにその旨を書いてください。相談しましょう。
審査者はいまのところ招待制です。データセットの中で「ネイティブ」という言葉に意味を持たせるため、審査者は1人ずつ手作業で追加しています。
アカウントを作りたくない場合でも、画像1枚単位の訂正はできます。データセットのリポジトリにissueを立てて、レコードIDと、画像に実際に何と書いてあるかを書いてください。
これらの言語のどれかを読める知り合いがいたら、このページを送ってください。1言語に1人審査者がいるだけでも、違いは生まれます。
よくある質問
ネイティブ審査者には誰がなれますか?
アラビア語、日本語、中国語、英語、スペイン語、ポルトガル語、ドイツ語のいずれかをネイティブとして読める人なら誰でもなれます。言語学の知識は要りません。[email protected]にメールで、ネイティブとして読める言語を教えてください。その言語の審査者アカウントを用意します。
1つのバッチにどれくらい時間がかかりますか?
約10分です。1バッチは約30枚で、最初のアラビア語バッチでは、審査者は1枚あたり平均11秒でした。回答はその都度保存されるので、途中でやめて、あとから続けられます。
審査した結果はどうなりますか?
提出した回答はAIFontの文字レンダリングデータセットに加わり、GitHubとZenodoでCC BY 4.0のもと公開されます。クレジットは実名、ペンネーム、匿名から選べます。ネイティブ審査者が確信を持って下した判定はそのまま最終判定になり、正答率の表も再計算されます。
ネイティブ審査者に報酬はありますか?
審査は貢献という形でお願いしています。回答はあなたが選んだクレジットで公開データセットに入り、あなたの言語がどう採点されるかを決めます。時間に対して報酬が必要な場合は、メールを送るときにその旨を書いてください。相談しましょう。
なぜAI自身に画像をチェックさせないのですか?
ある文字をよく読めないAIは、単語ではなく形で判断してしまいます。私たちのアラビア語テストでは、ネイティブの読み手は私たちの291件の判定のうち23件と異なる判定をし、AI審査者と非ネイティブの審査者の意見が分かれていた41枚のうち34枚に決着をつけました。