画像生成AI比較2026:文字に強いのは?
画像生成AI 5種で文字入れを7言語実測。GPT Image・Nano Banana 99%、Qwen-Image 79%。
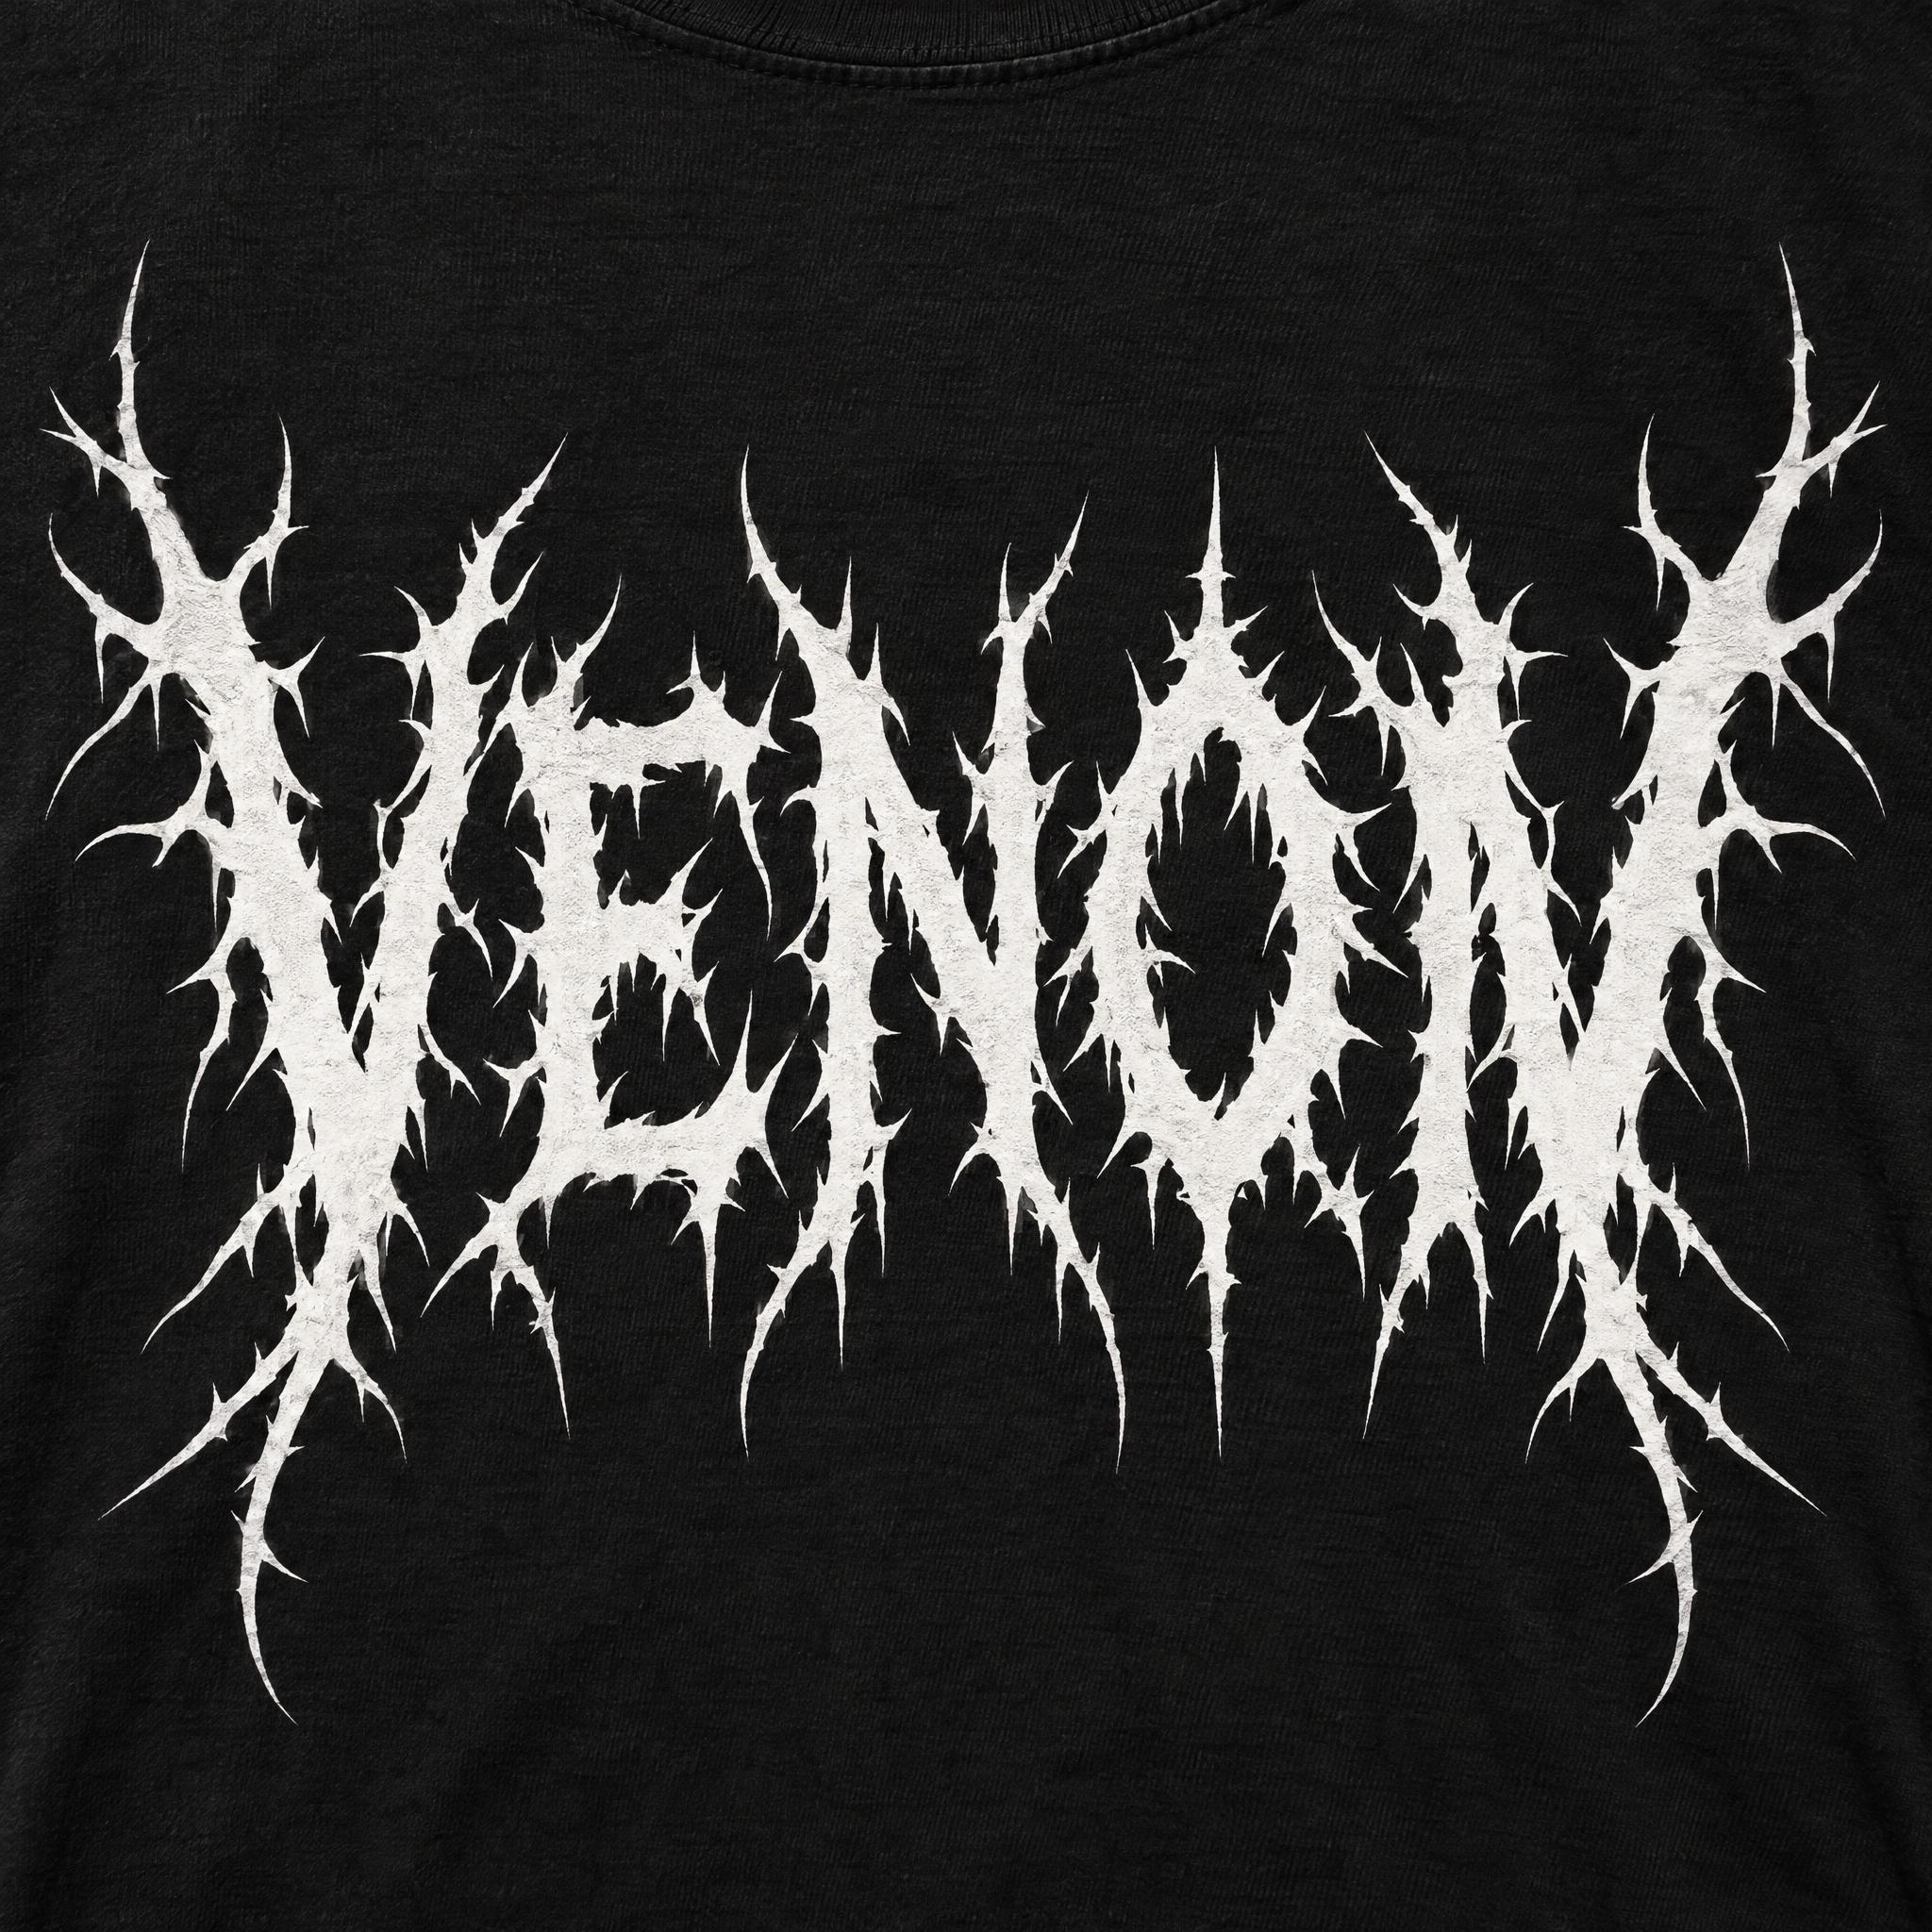
デスメタル風のTシャツにVENOMと入れるよう頼んだところ、画像生成AI 5モデルを比較したなかで最も正確だったモデルが印字したのはVENONでした。これはGPT Imageが404枚中に出したわずか3つのスペルミスのひとつです。Qwen-Imageは86個間違えました。
画像生成AIの差がまだはっきり出るのが、文字です。クロームの質感や絵の具の垂れ、スタジオ照明は写真と見分けがつかないほど描けるのに、点をひとつずらして単語を別の単語に変えてしまう。私たちはAIフォントのプロンプトをつくる仕事をしているので、公開するプロンプトはすべて5つのモデルで生成し、1枚ずつ1文字単位で確認しています。59スタイル分の確認がたまって、以下の比較になりました。
画像生成AIの比較:結論から
| 文字体系 | GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image |
|---|---|---|---|---|---|
| ラテン文字(英語・ドイツ語・スペイン語・ポルトガル語) | 235/236 | 235/235 | 229/235 | 230/235 | 213/235 |
| 中国語 | 59/59 | 58/59 | 58/59 | 56/59 | 56/59 |
| 日本語 | 59/59 | 58/59 | 52/59 | 51/59 | 45/59 |
| アラビア語 | 48/50 | 51/51 | 35/49 | 27/47 | 6/53 |
| 合計 | 99% | 100% | 93% | 91% | 79% |
- 文字に最も強い画像生成モデルはGPT Image 2.5とNano Banana 2.1です。 どちらも約400枚で間違いは2〜3個、どの文字体系でも安定していました。
- Grok Imagine 2.0とSeedream 5.0 Proはラテン文字と中国語はこなしますが、日本語でつまずき、アラビア語では大きく崩れます。
- Qwen-Image 3.0 Proは、ふつうの英字の単語でも失点した唯一のモデルで、アラビア語は53語中6語でした。
テストの方法
59スタイルはすべてAIFontで公開しているプロンプトです。たとえばTextura、Paint Splatter、Tagging Lettersなど。各スタイルに言語ごとのプロンプトが1本ずつあり、その言語の短い単語を画像に入れます:FRESH、Reino、ばくはつ、كعك。
- 全モデルに同じプロンプト。 同じスタイル・同じ言語なら、5モデルにまったく同じプロンプト文を渡しました。数えたのは各モデルが最初に返した1枚だけで、再生成から良いものを選ぶことはしていません。
- 設定: 2K、正方形、各社のAPI経由、2026年10月22日〜29日に生成。GPT Imageは品質設定xhigh、Grok Imagineは最上位のmedium。ほかの3モデルには品質設定がありません。
- モデル: GPT Image 2.5(OpenAI)、Nano Banana 2.1(Google)、Grok Imagine Image 2.0(xAI)、Seedream 5.0 Pro(ByteDance)、Qwen-Image 3.0 Pro(Alibaba)。
- 判定: すべての画像をAIレビュアーが読み、中国語・日本語・アラビア語は拡大して確認しました。採点対象のうち489枚は人も確認しています。AIが誤り・判断保留とした画像すべて、アラビア語の大半、残りから無作為に抜き出した一部です。
- 誤りの基準: 代わりに何と読めるか言える場合だけ誤りとします(VENOMではなくVENON)。装飾的な字形や飾りの線、大文字・小文字の違いは正解扱い。プロンプトが求めていない余計な単語は誤りです。
最初の生成は計2,057枚。そのうちアラビア語41枚は、AIと人の判定が食い違い、どちらもアラビア語ネイティブではないため除外し、採点対象は2,016枚になりました。
ラテン文字と中国語:5モデルとも合格
英語、ドイツ語、スペイン語、ポルトガル語、中国語では、どのモデルも90%を超えました。これらの言語の短い単語なら、5モデルのどれでもたいてい1回目で正しく書けます。
唯一の例外はQwen-Imageのスペイン語とポルトガル語で、言語ごとに9〜10語を間違えました。典型的なミスはスペルの誤りではありません。
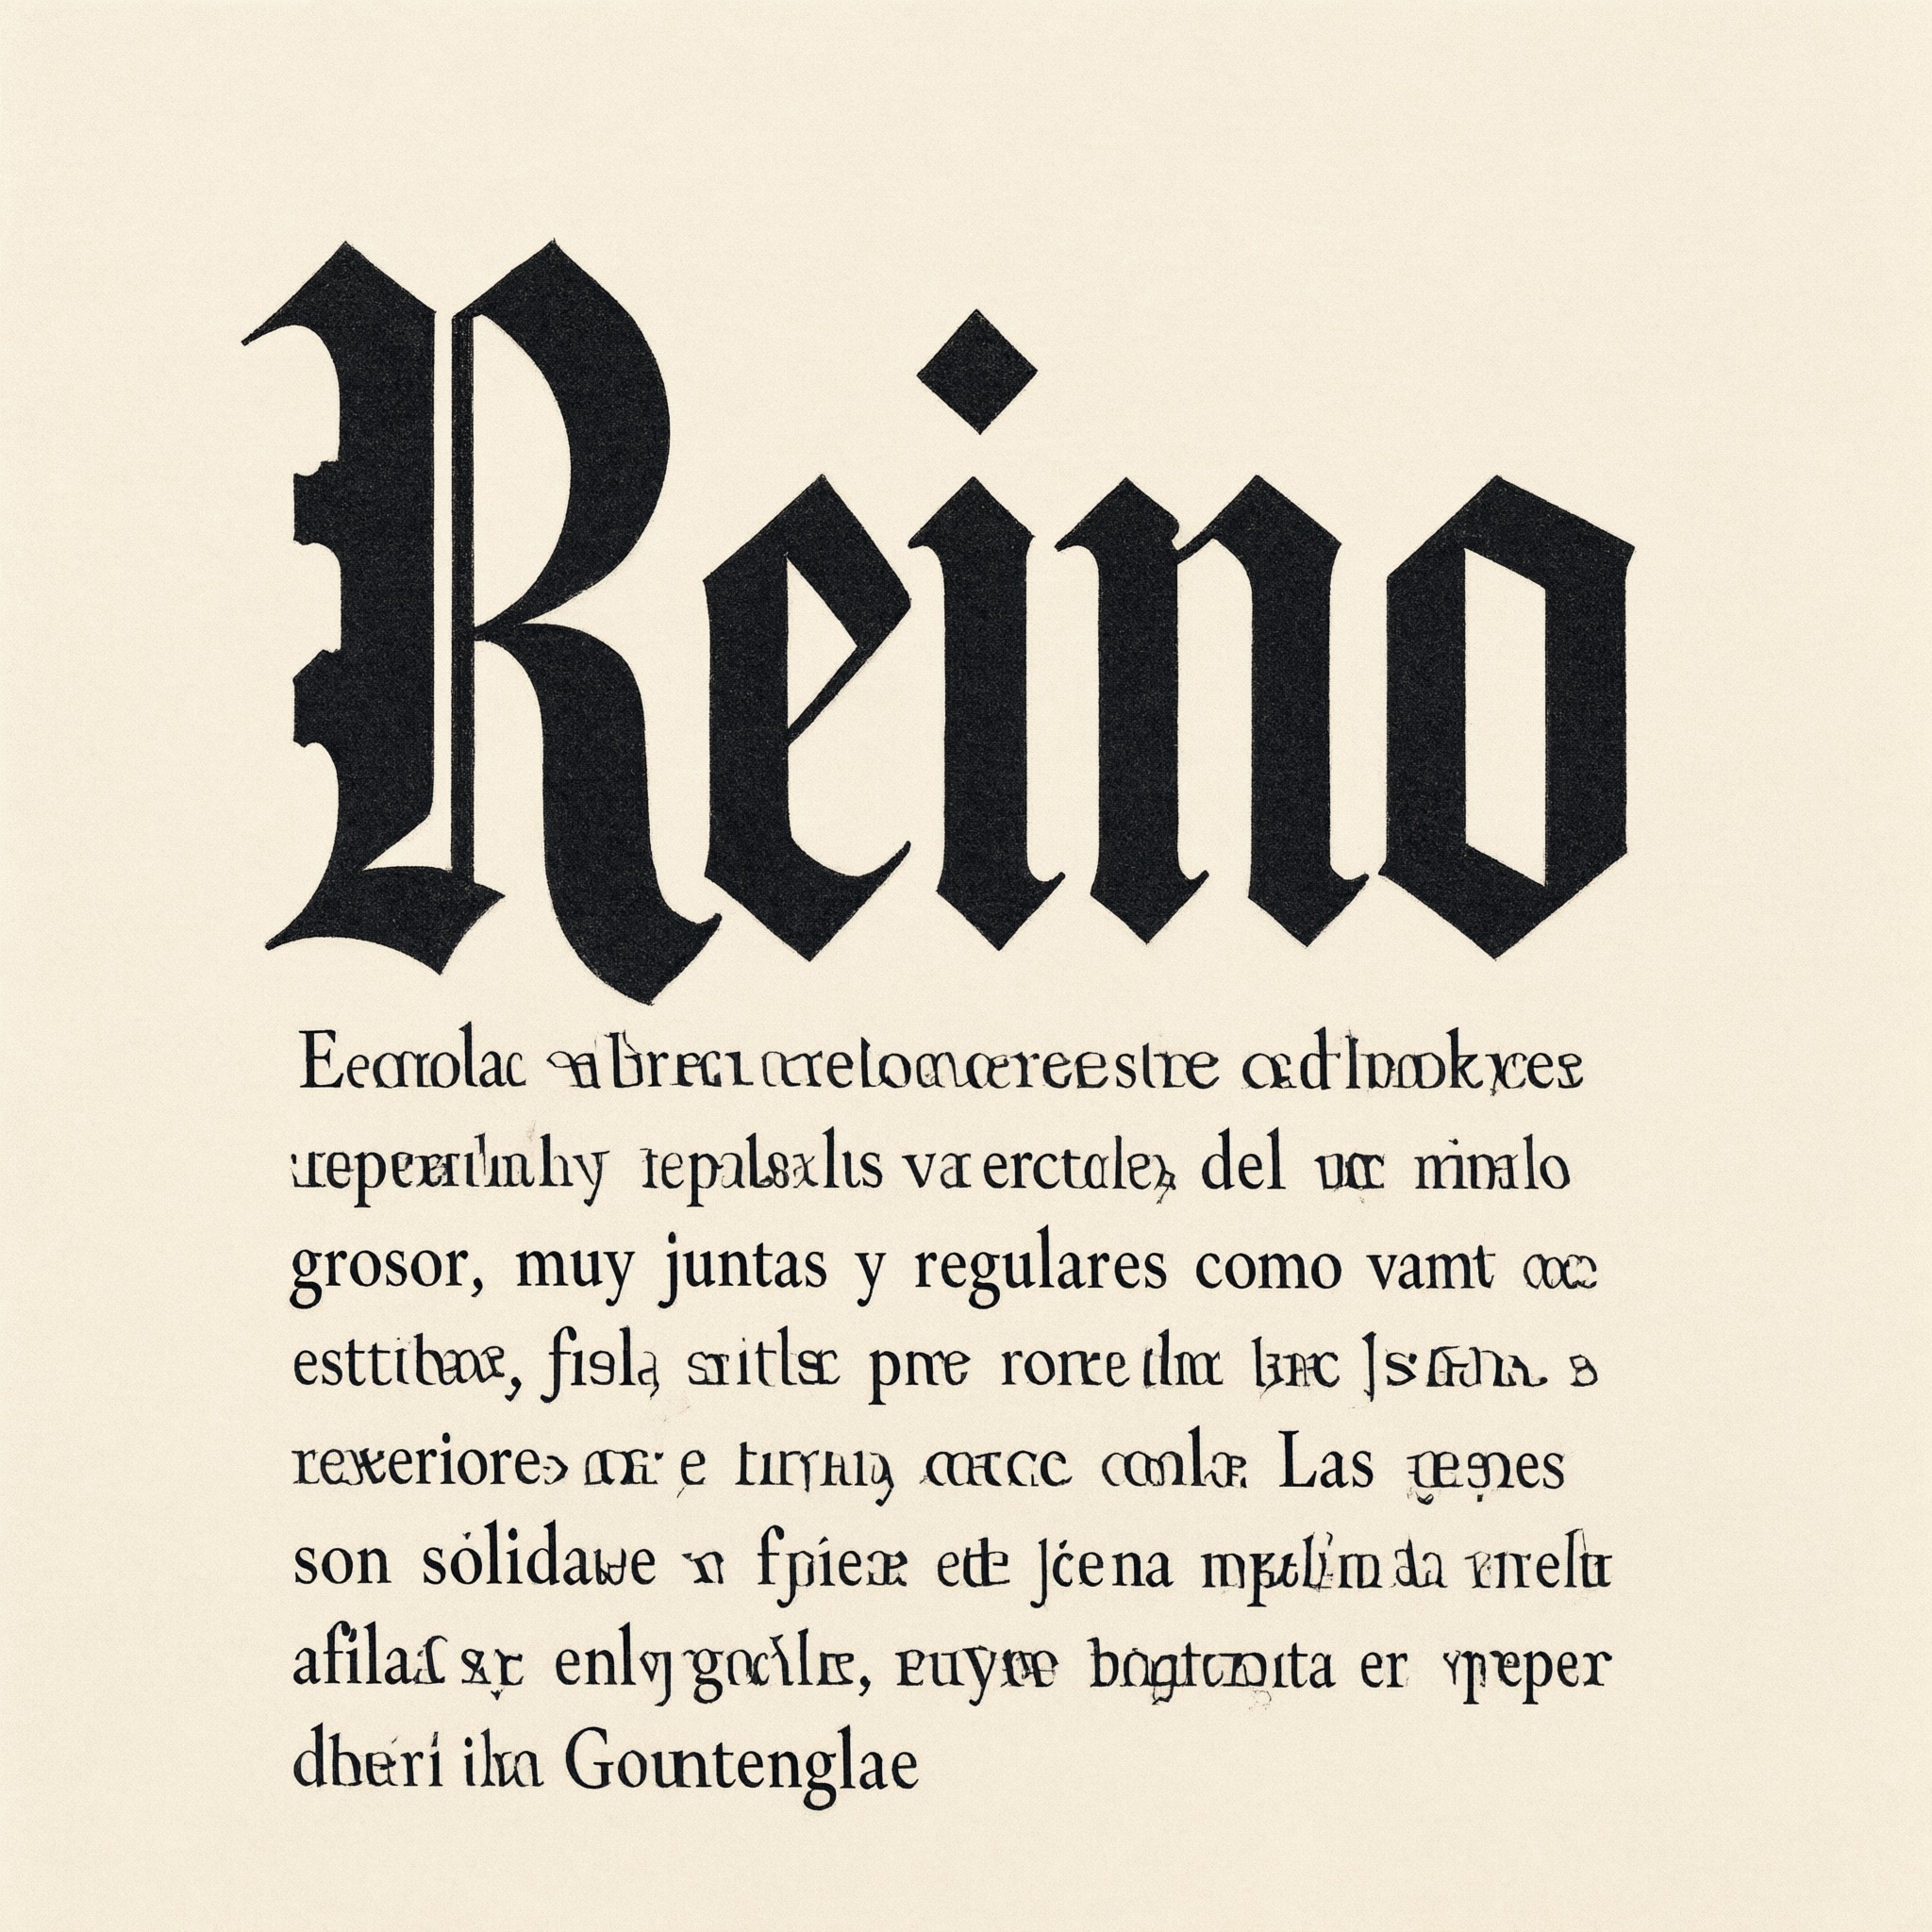
指定した単語に、頼んでいない文章のかたまりが付くこのパターンが、Qwen-Imageの86個のエラーのうち40個を占めます。余計な文章は、プロンプトそのものが崩れて写り込んだものであることが多いです。
日本語:ここで差が開く
| GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image | |
|---|---|---|---|---|---|
| 日本語 | 59/59 | 58/59 | 52/59 | 51/59 | 45/59 |
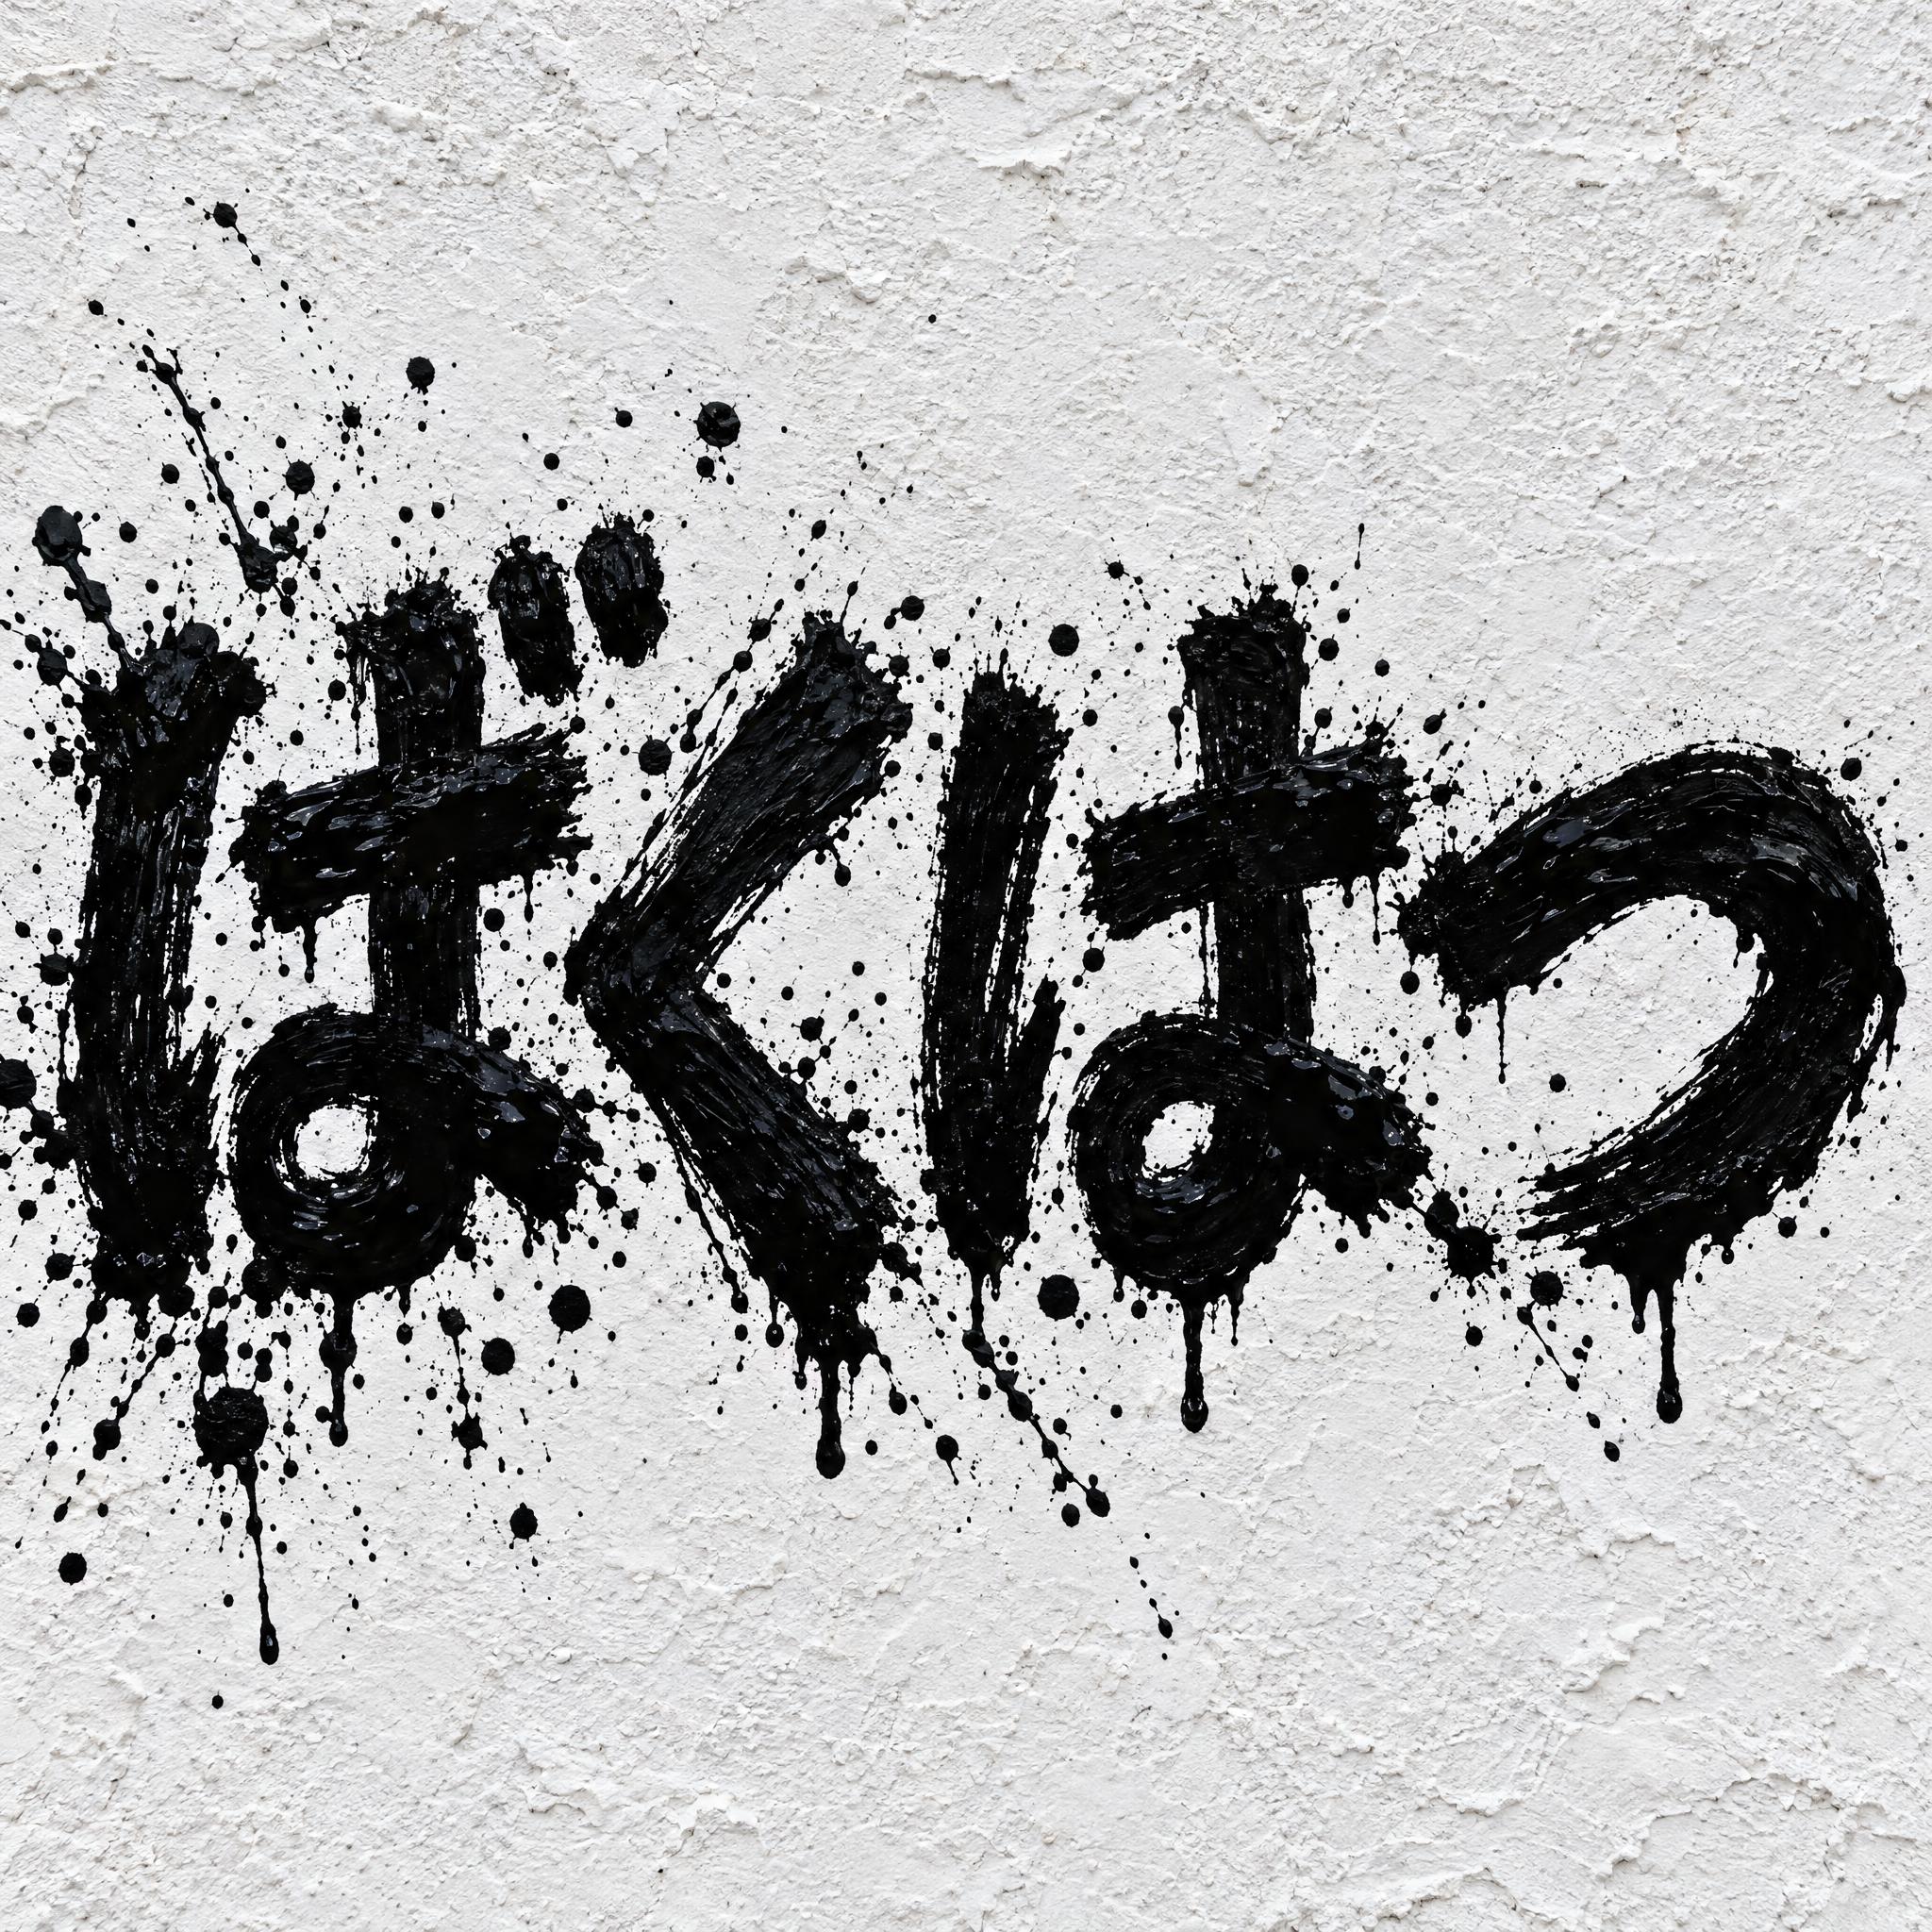
かなには単語を変えてしまう小さな記号があります。点が2つ(濁点)付くだけで、「は」が「ば」になります。ペイントスプラッターのプロンプトでは、Grok ImagineとSeedreamがどちらも、付くはずのない場所に濁点を付けました。
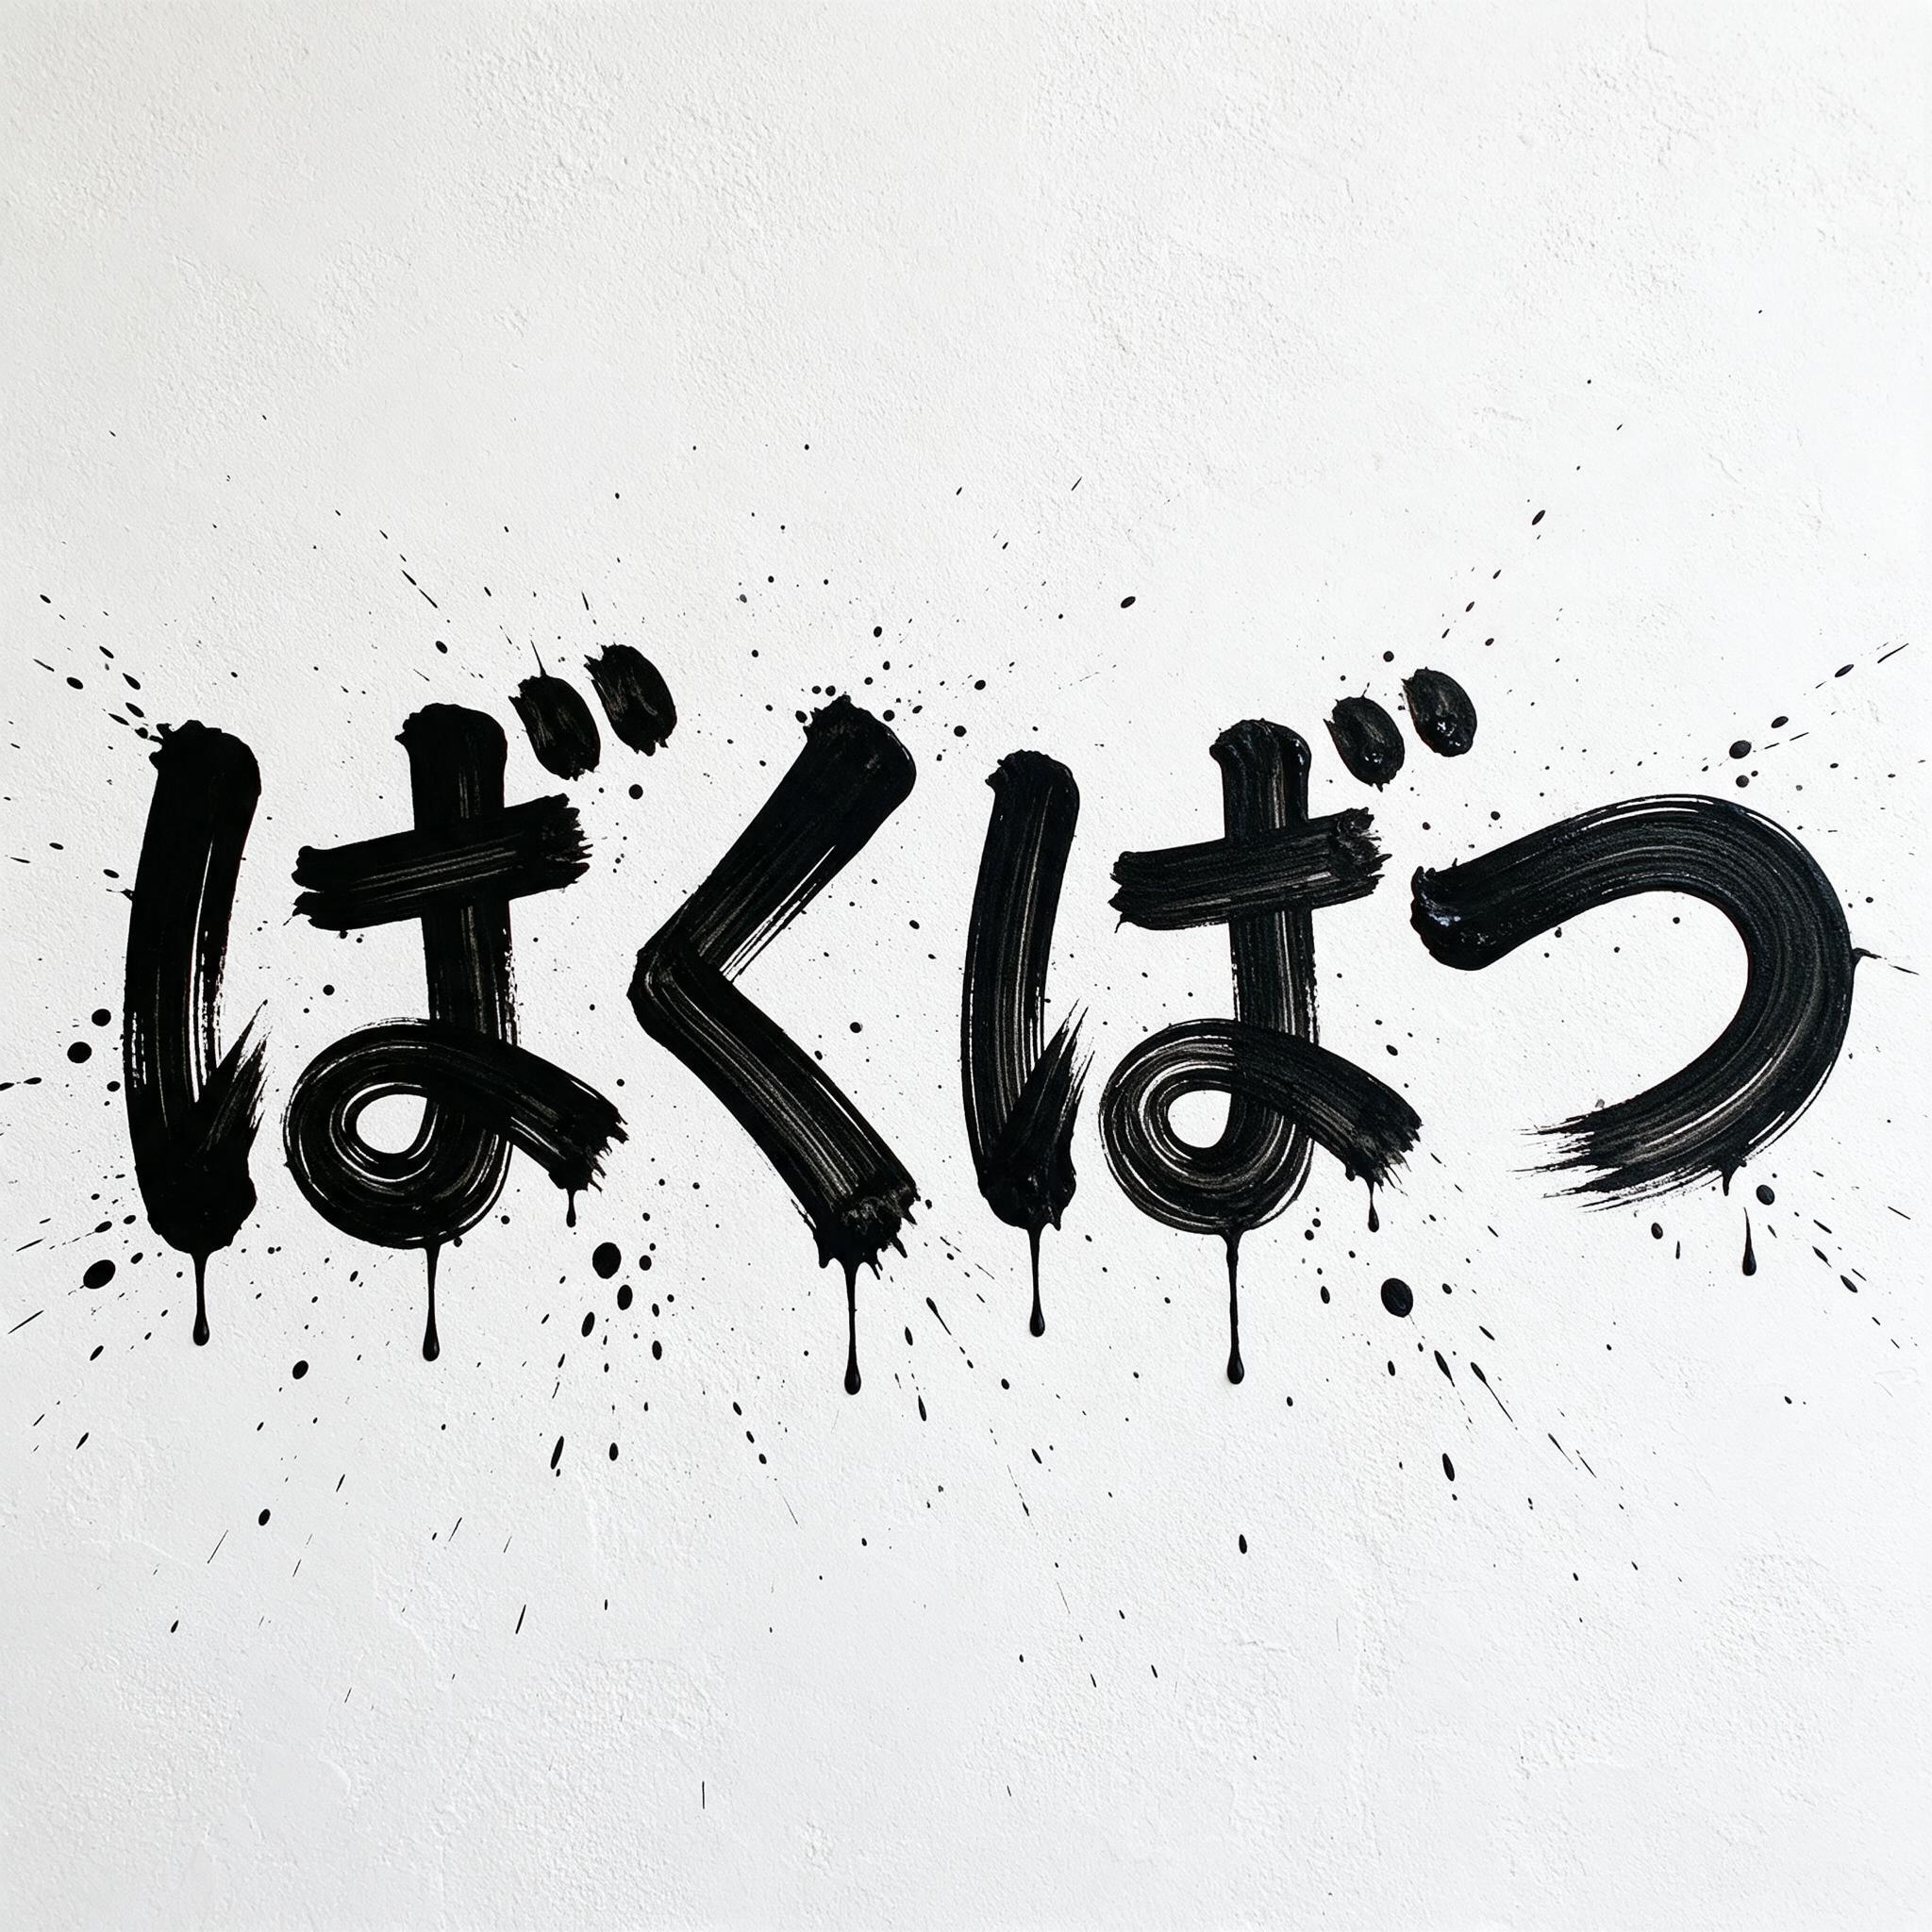
Grok ImagineとSeedreamのほかの日本語のミスも同じ形で、文字がひとつ違うだけで、単語全体が崩れるわけではありません。Grokは「ストリート」を「ストリトト」、「ジンクス」を「ジングス」、「ぼうけん」を「ぼうげん」と書き、Seedreamは「かくとう」を「かくどう」、「ねがい」を「ねがいの」と書きました。日本語を読める人なら、どれも一目で気づきます。
アラビア語:持ちこたえたのは2モデルだけ
| GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image | |
|---|---|---|---|---|---|
| アラビア語 | 48/50(96%) | 51/51(100%) | 35/49(71%) | 27/47(57%) | 6/53(11%) |
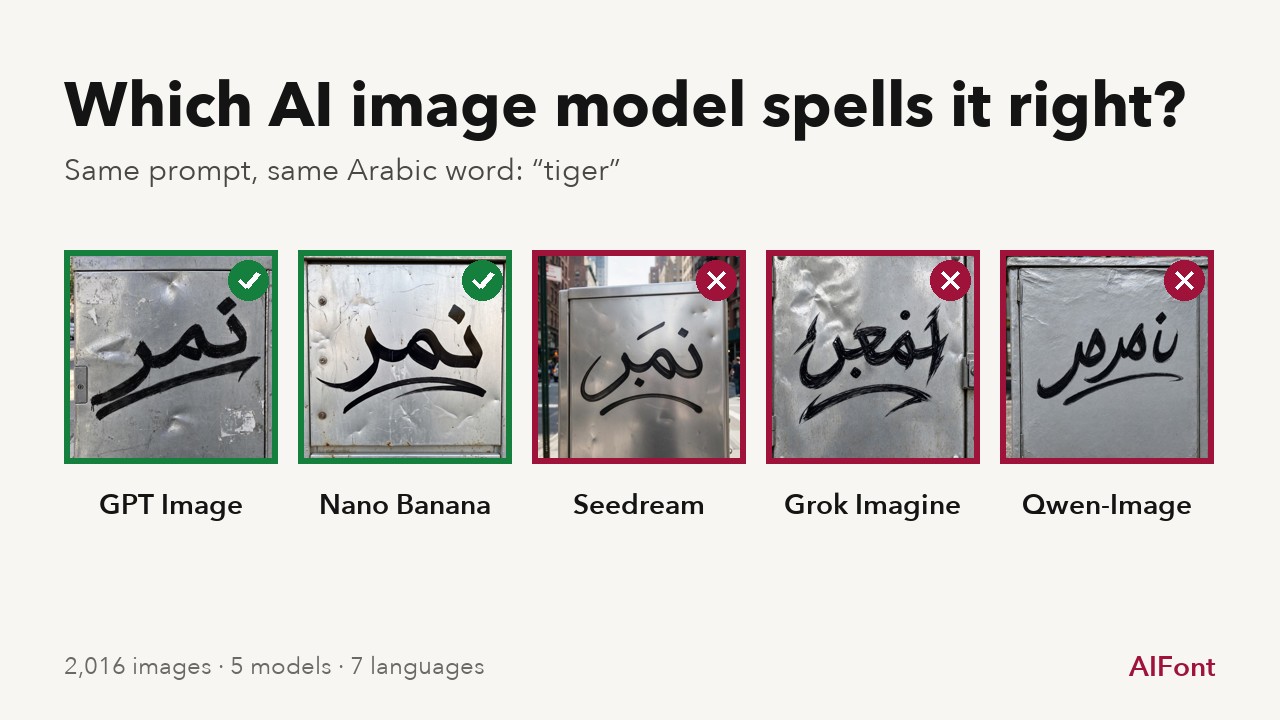
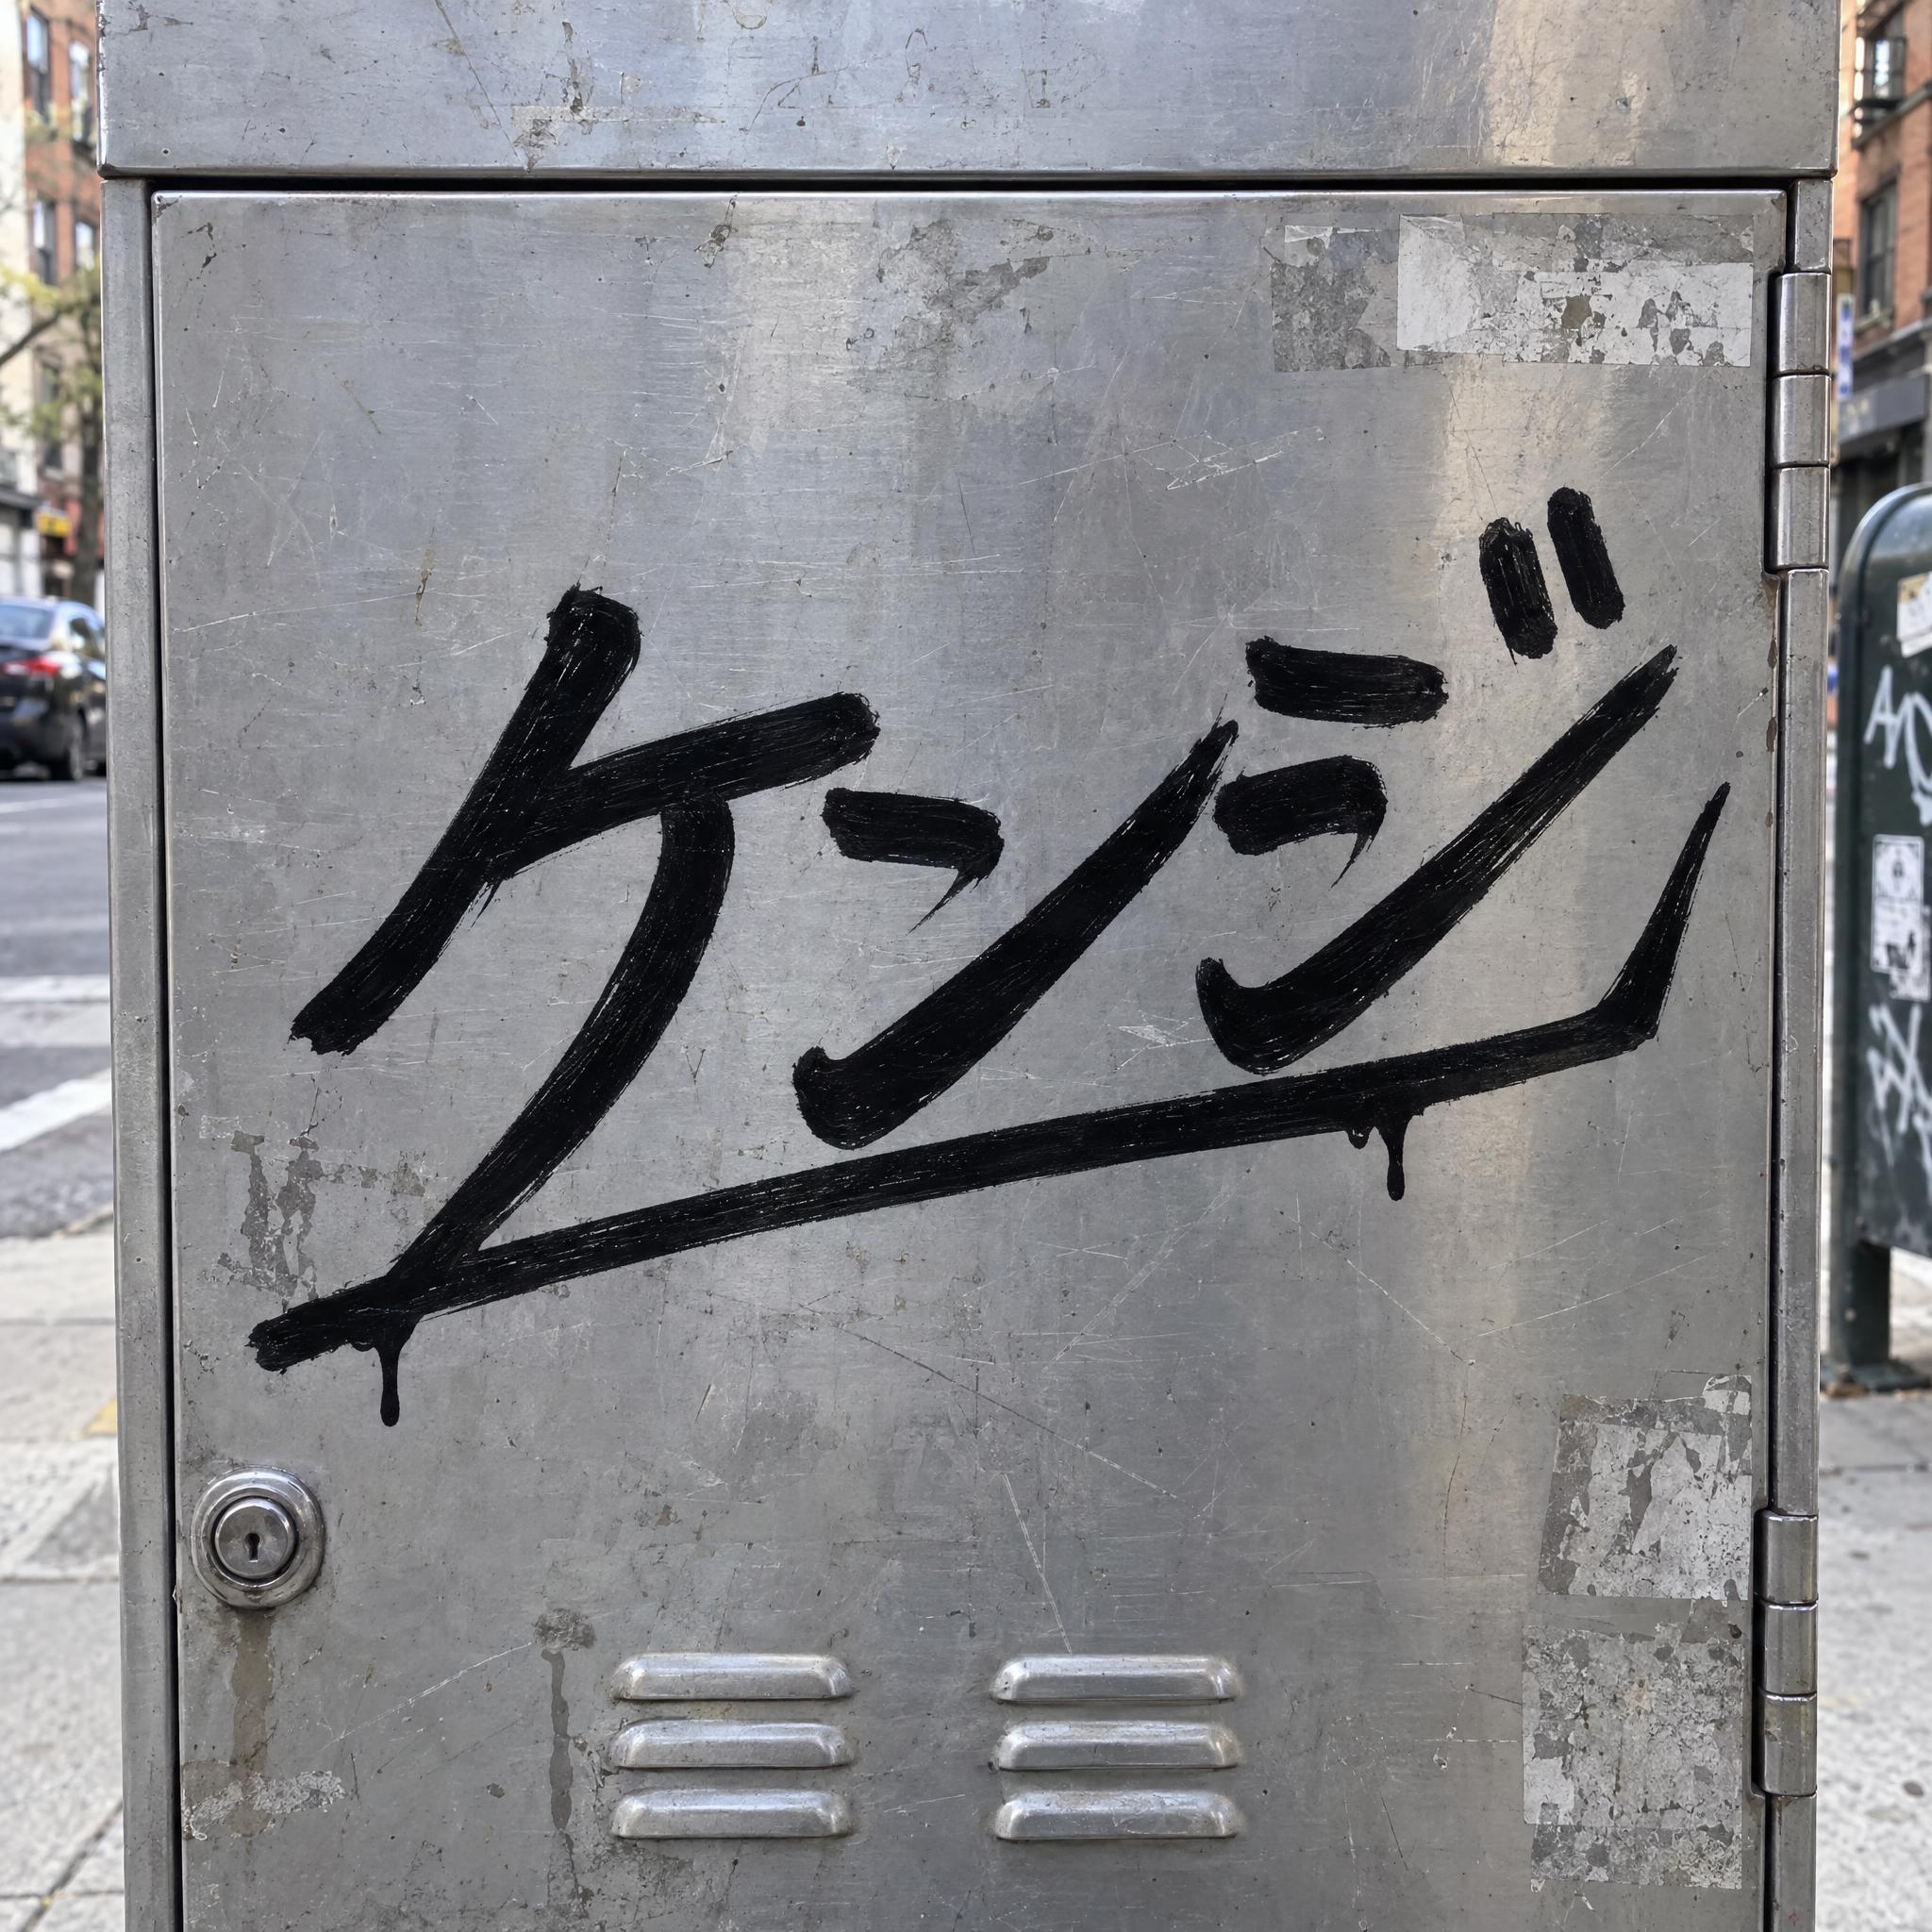
アラビア文字は今回のテストでいちばん難しい文字体系です。文字どうしがつながり、語中の位置で形が変わり、点の数や位置だけで区別される文字が多くあります。1本のプロンプトで差が一目でわかります。街なかの配電ボックスに、グラフィティでنمر(トラ)と書かせたものです。
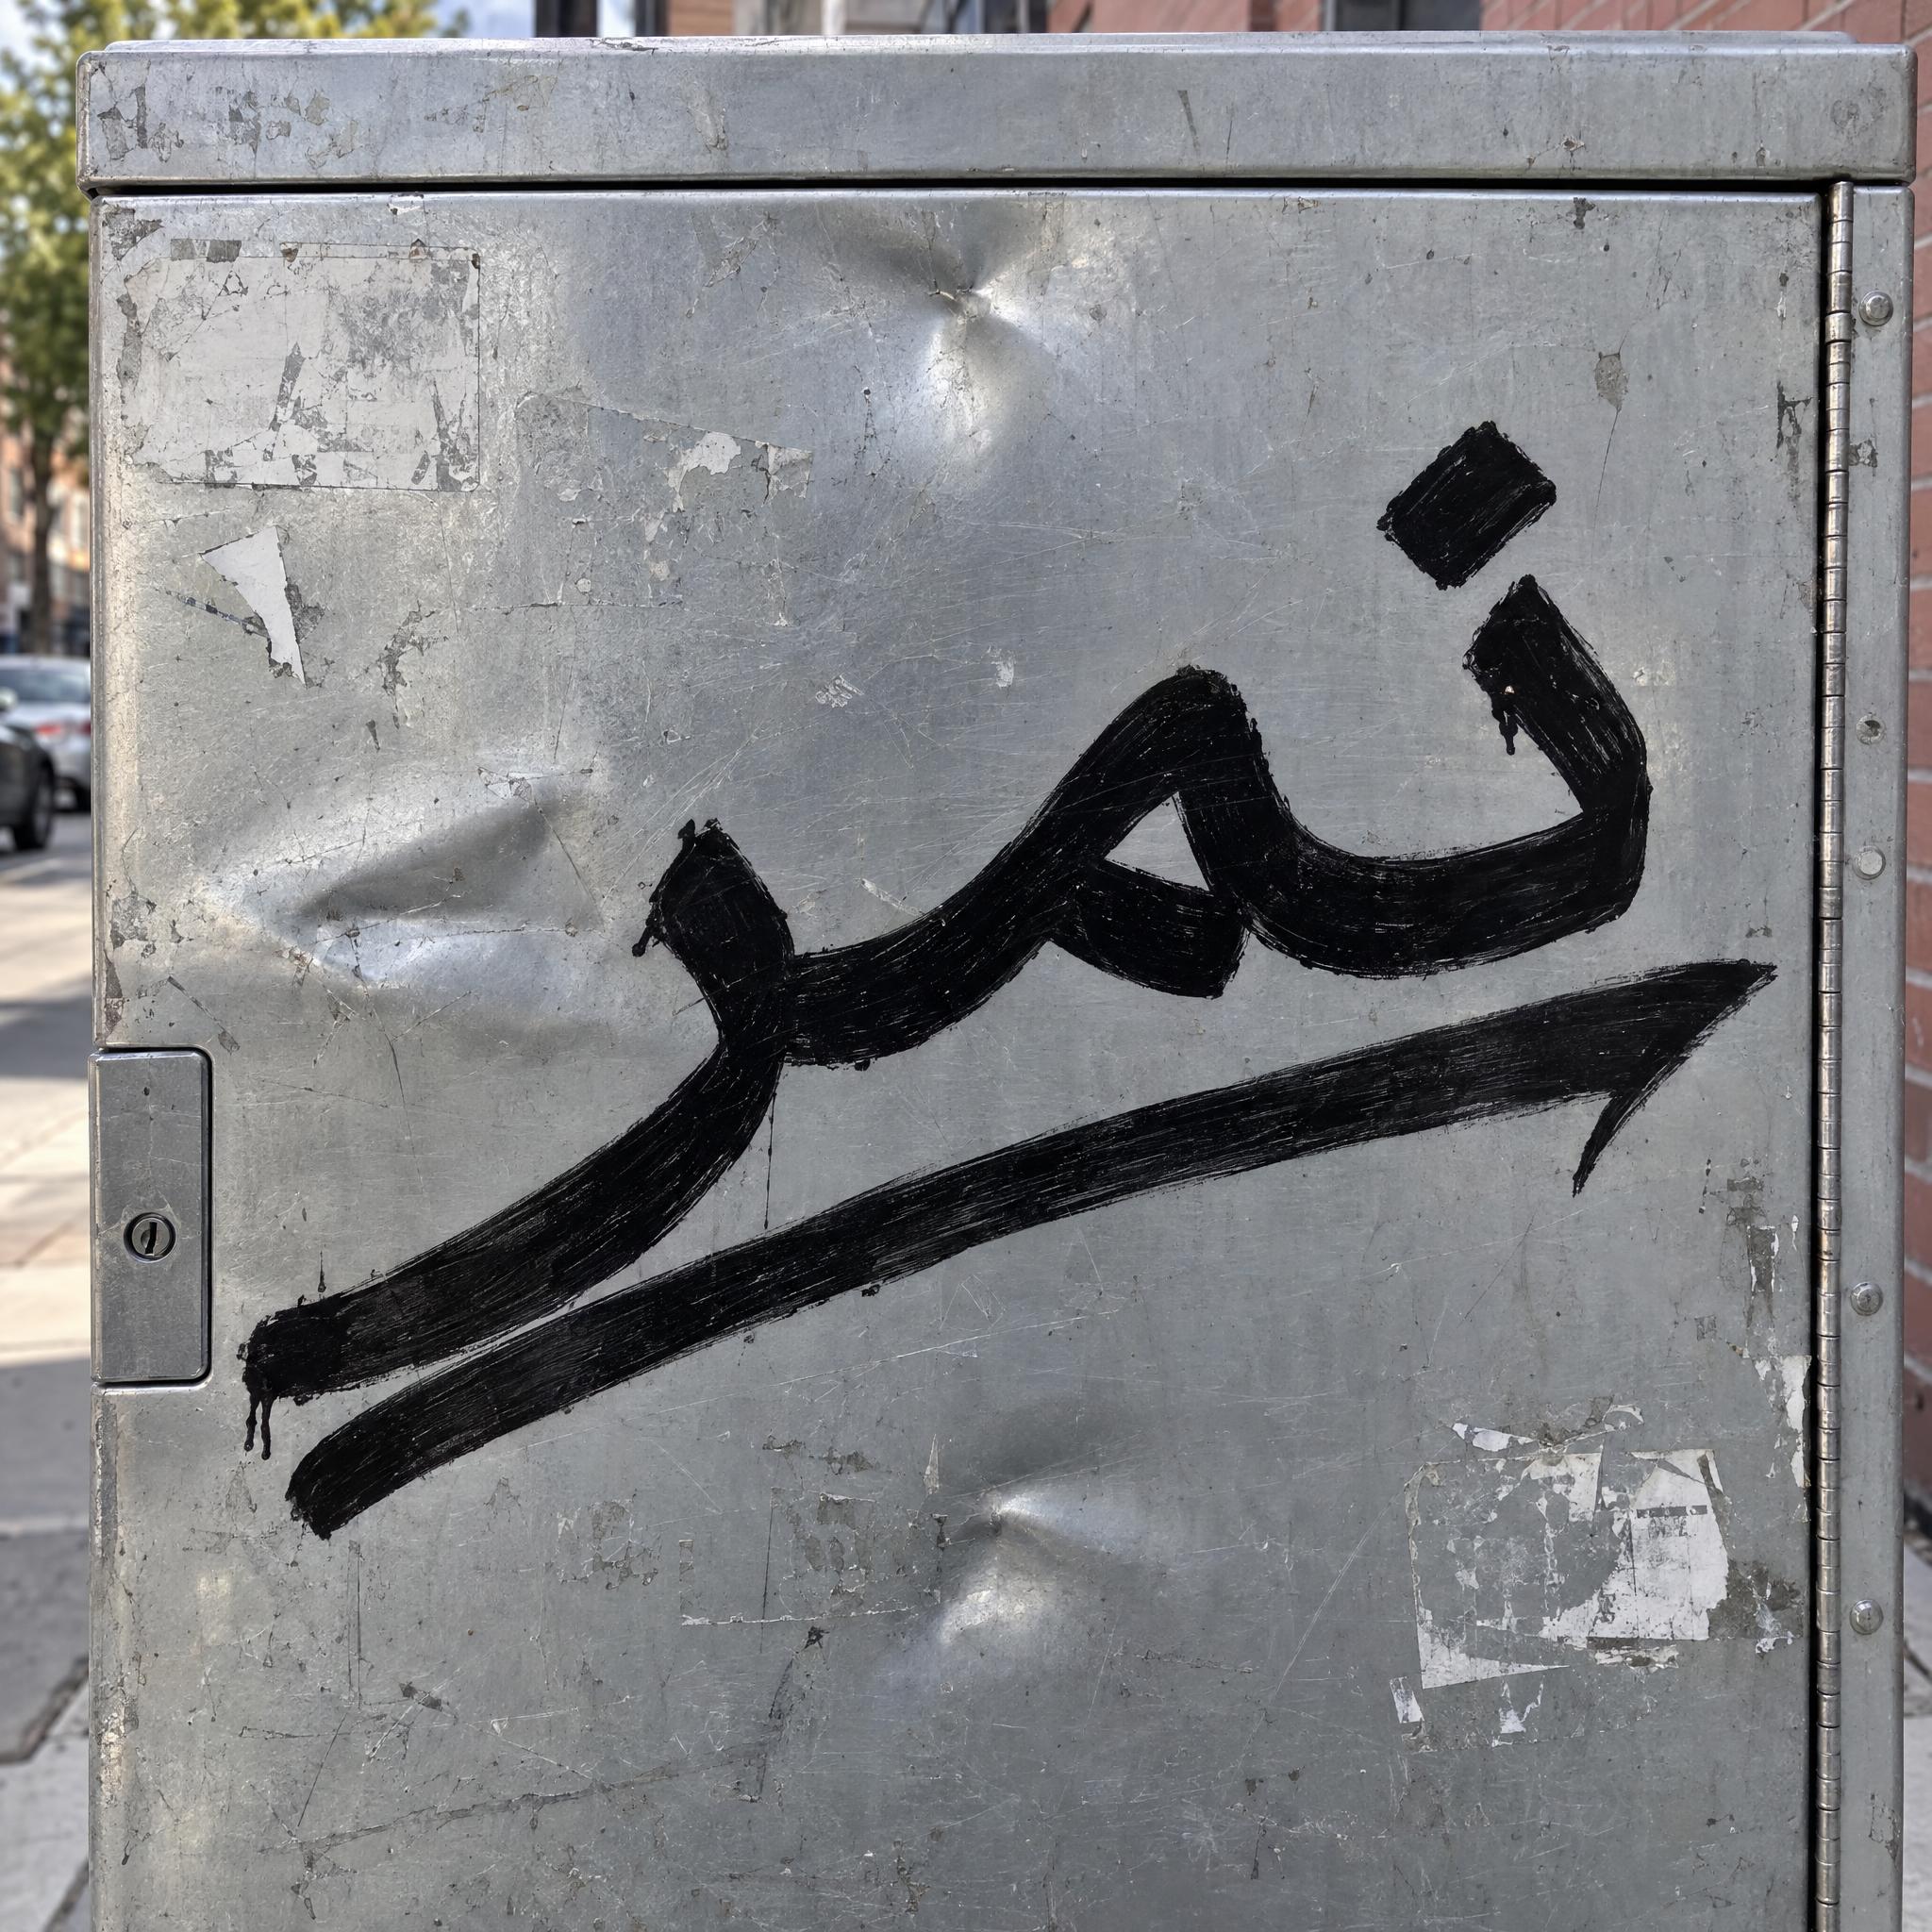
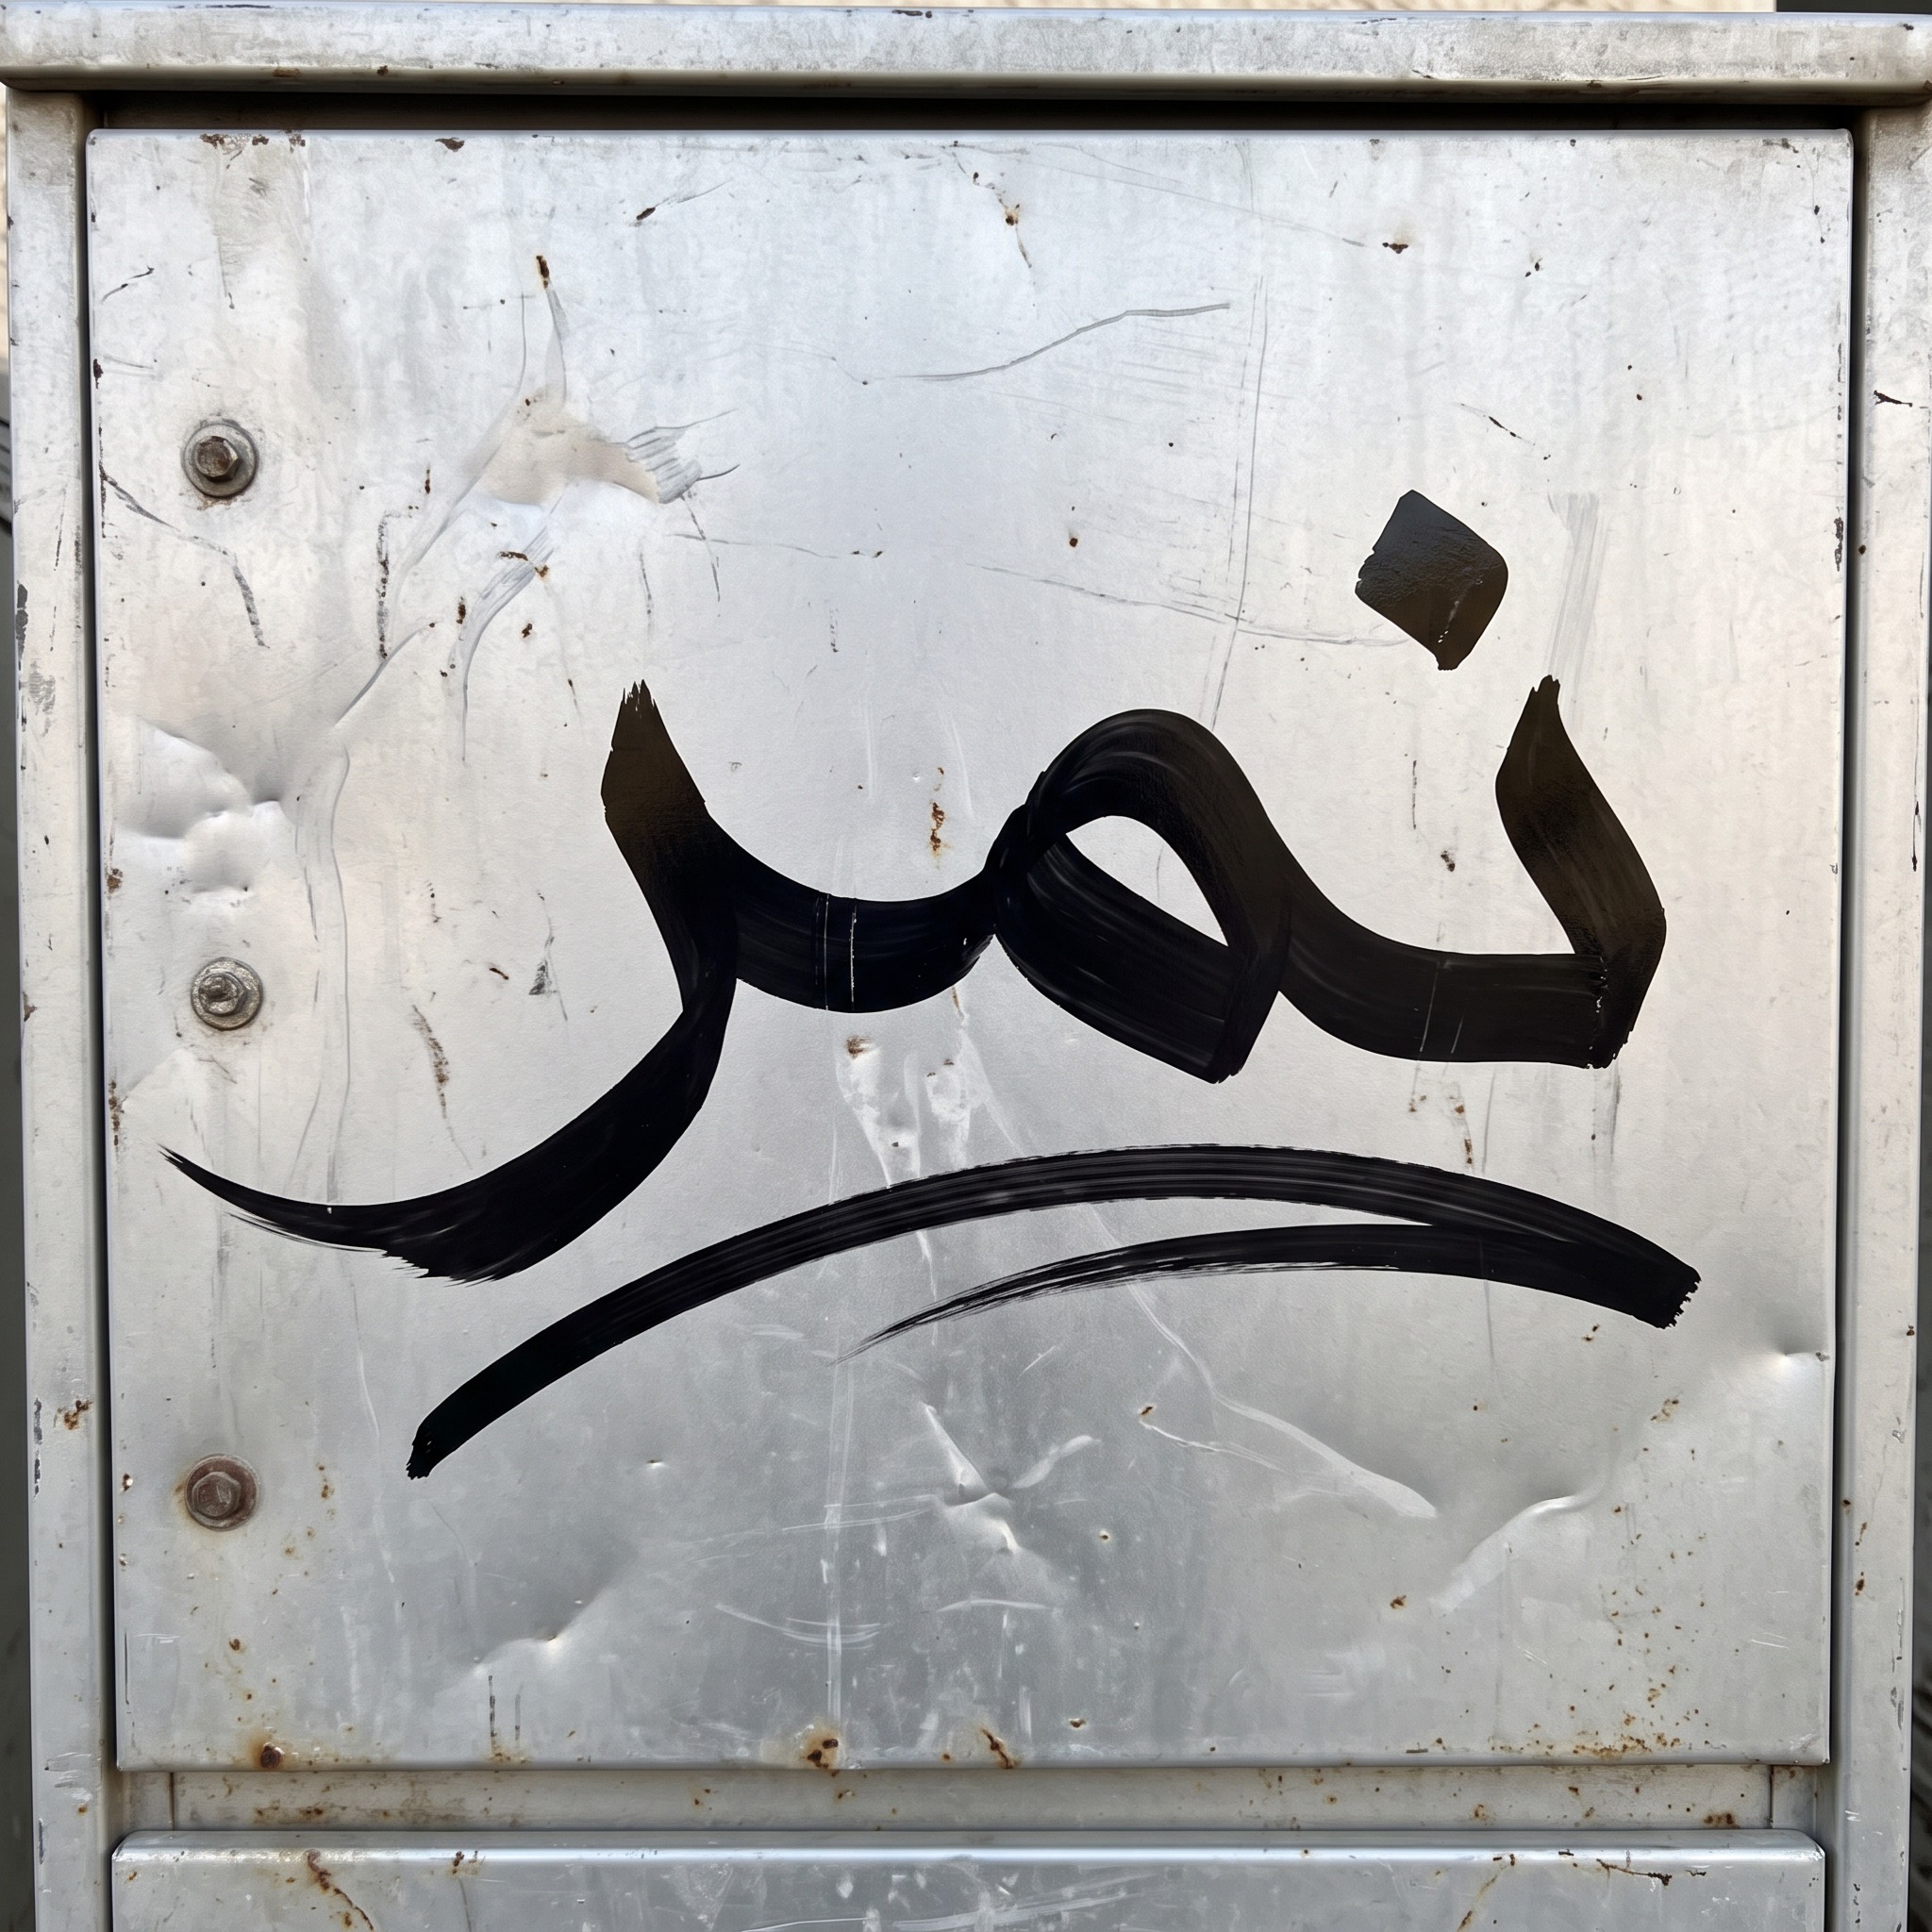
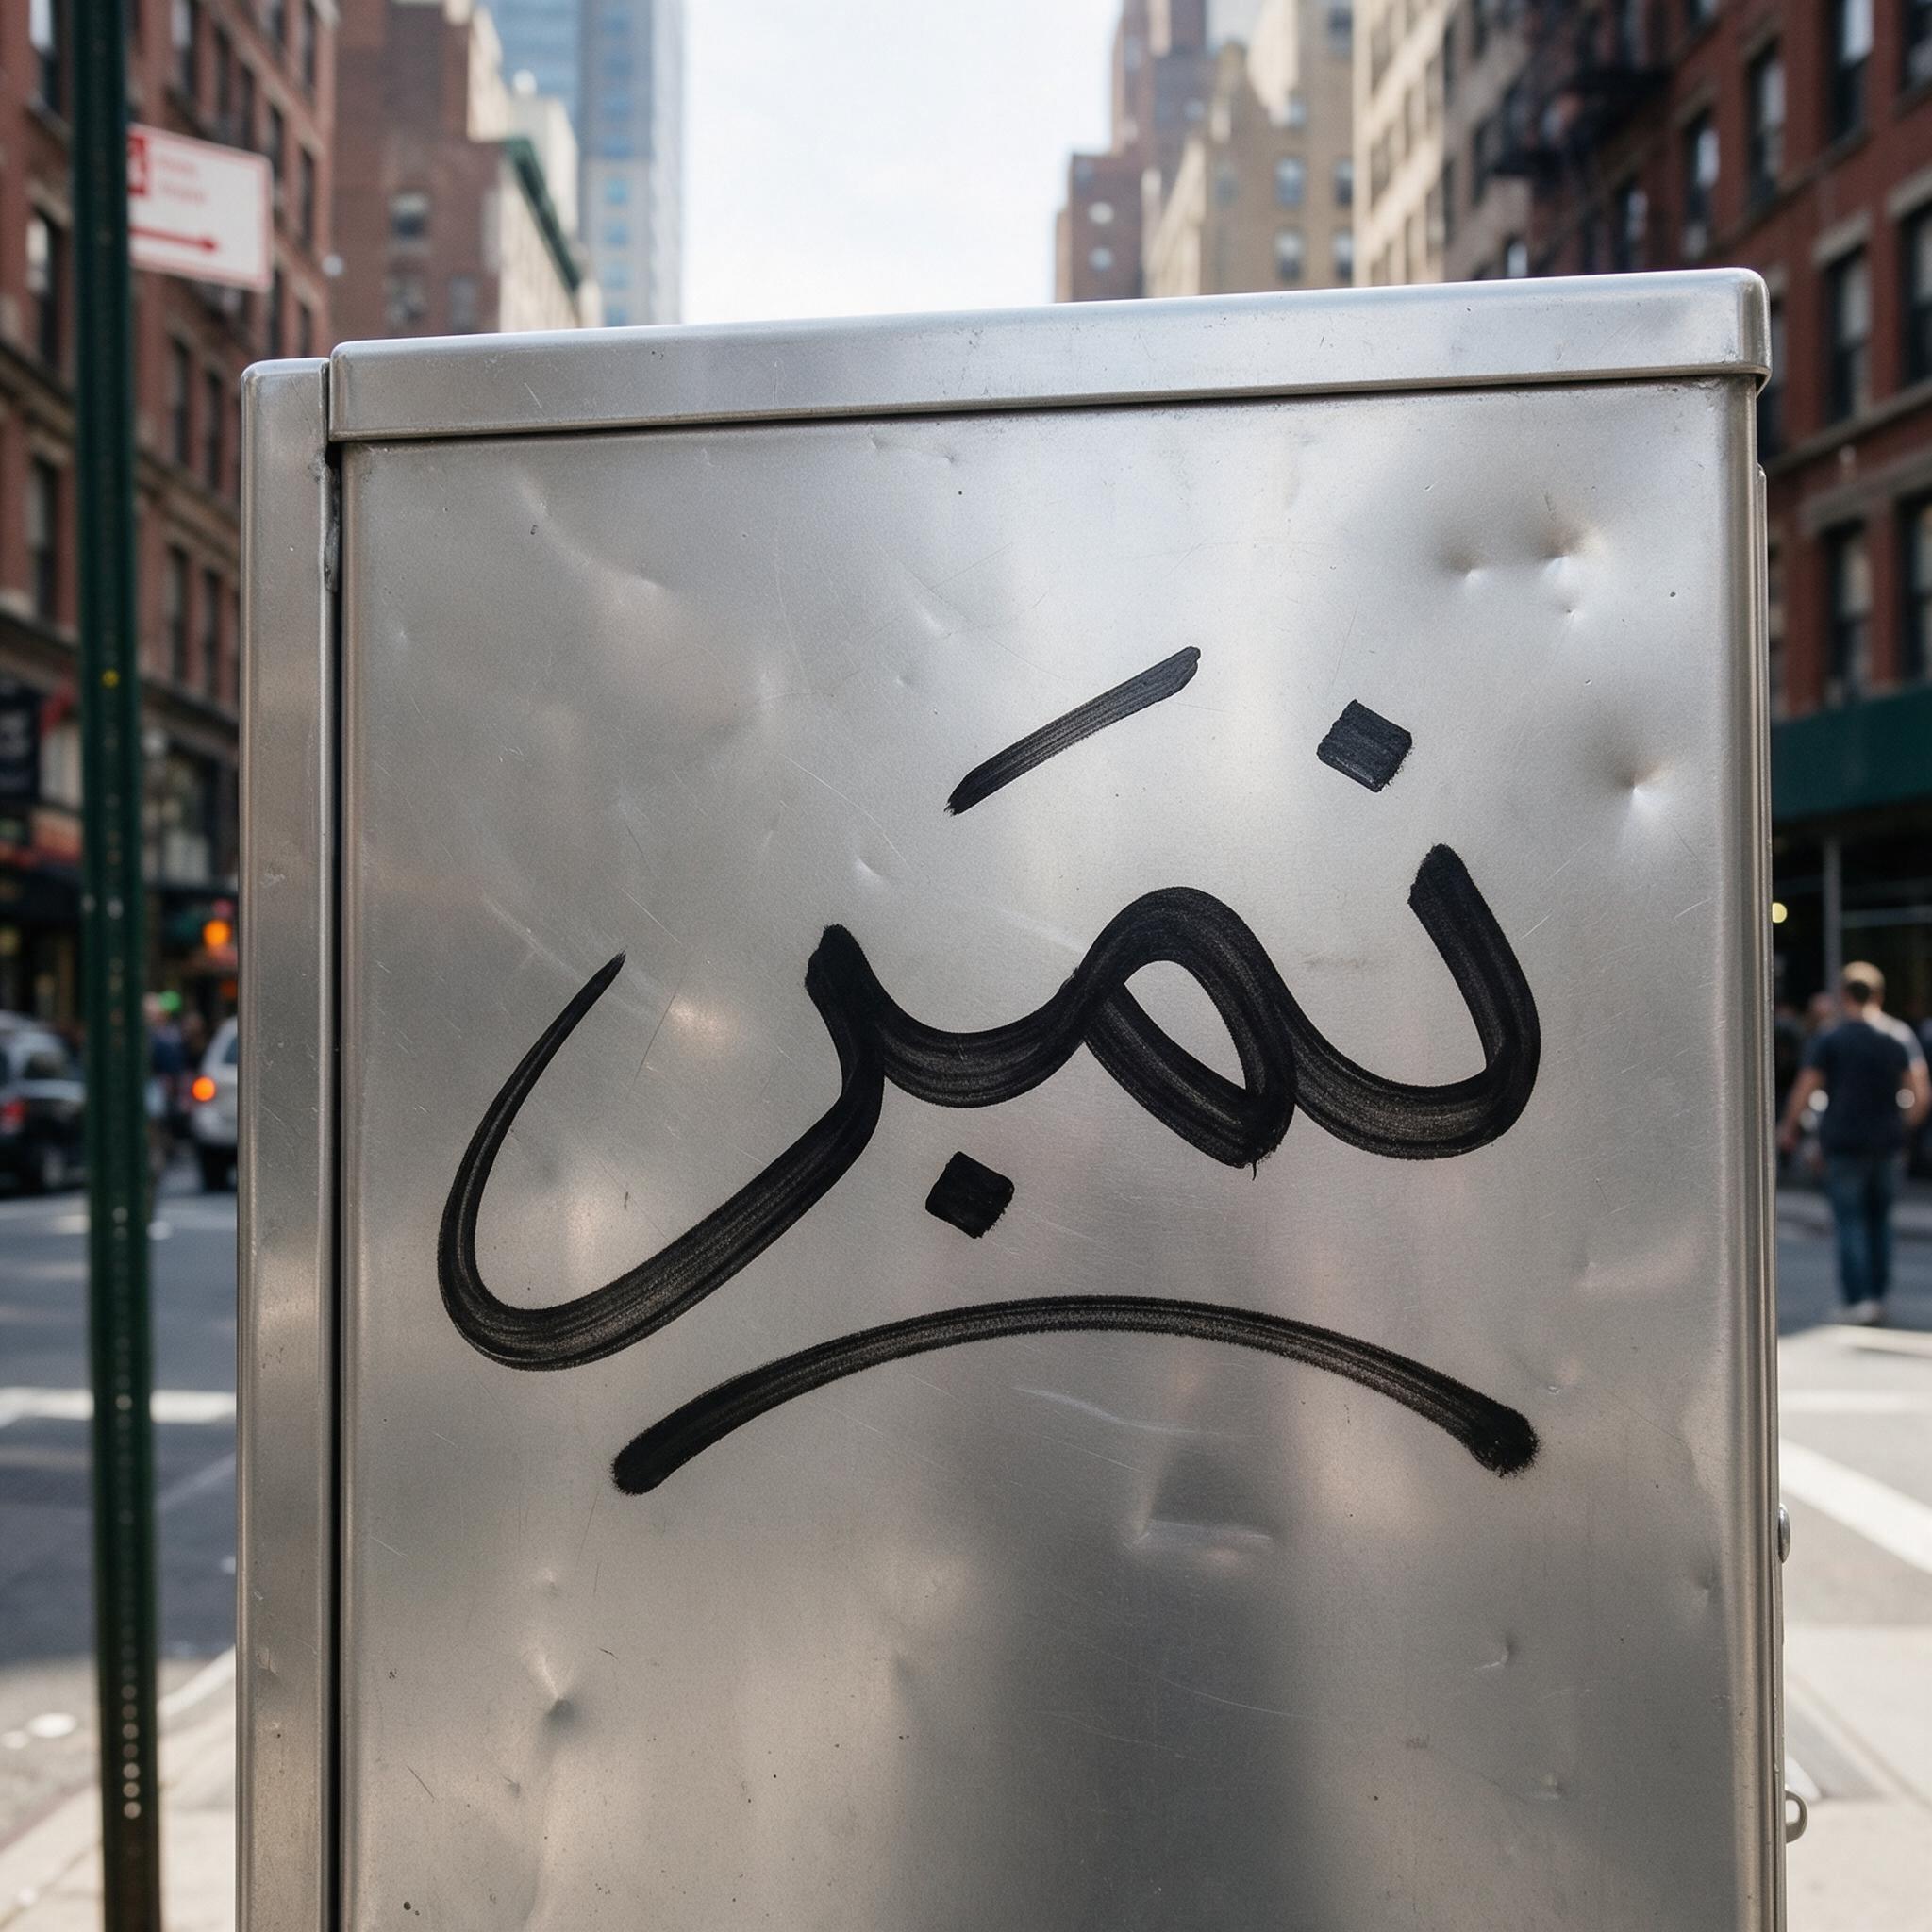
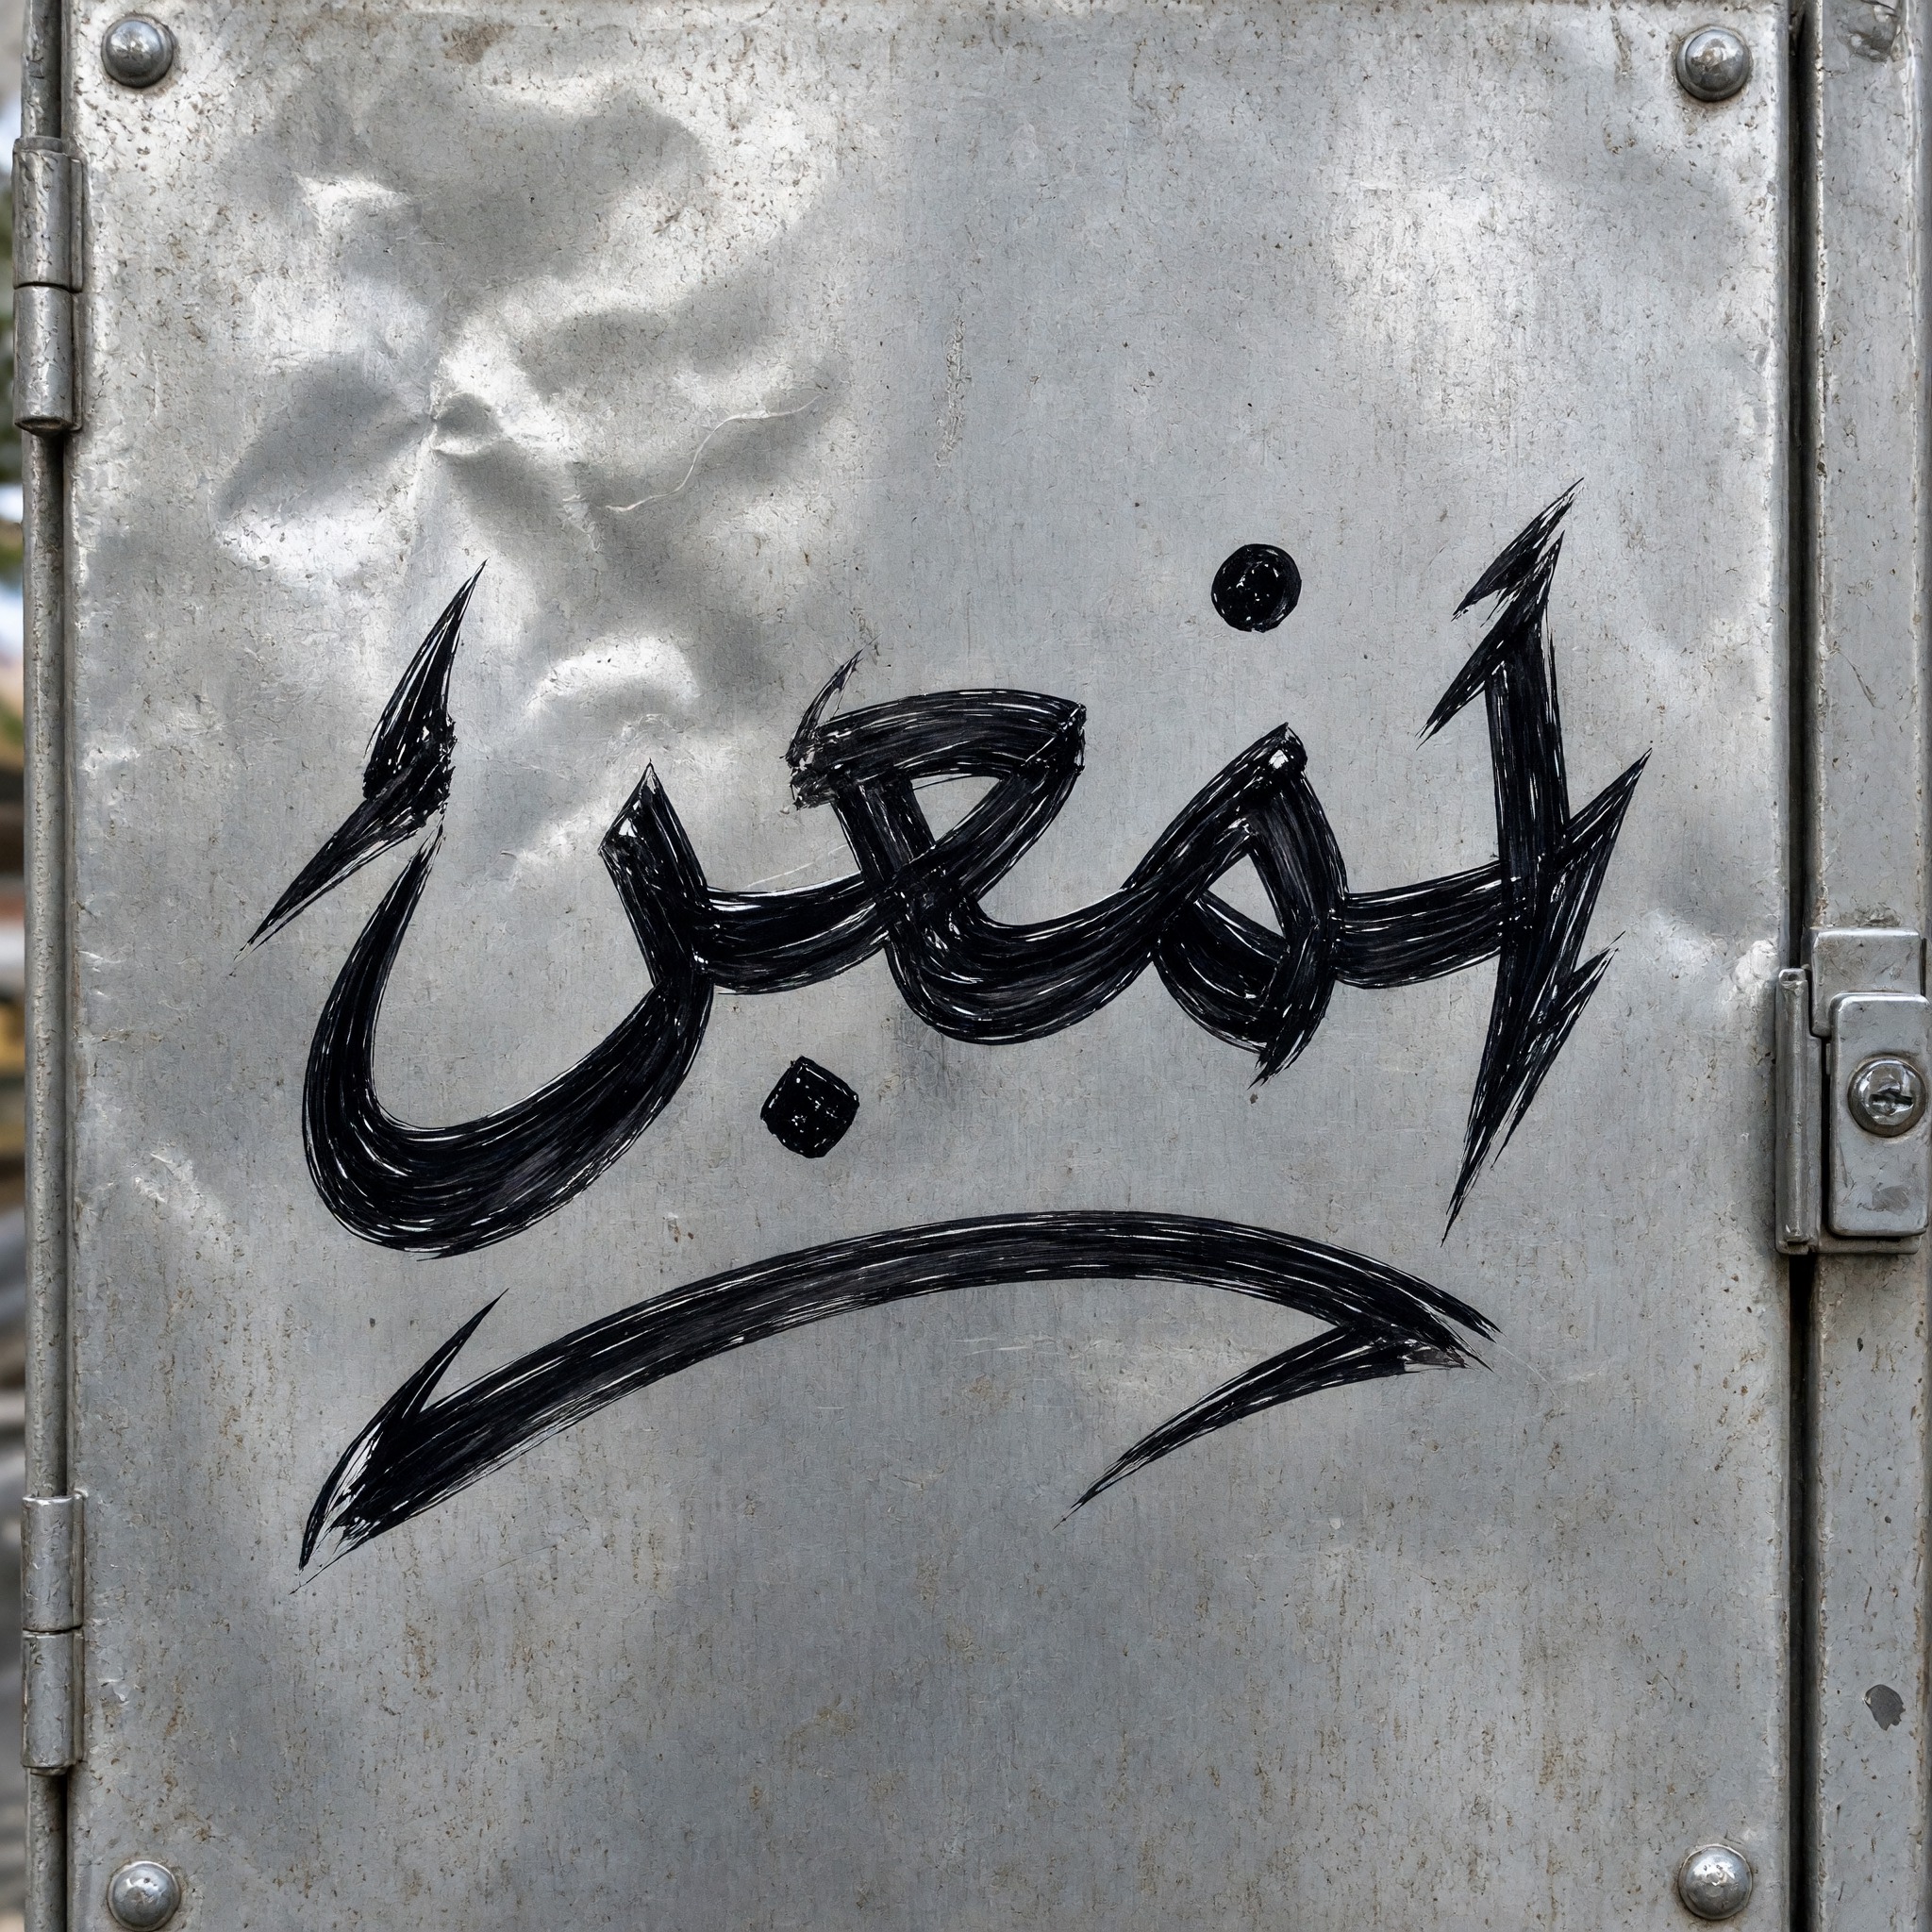
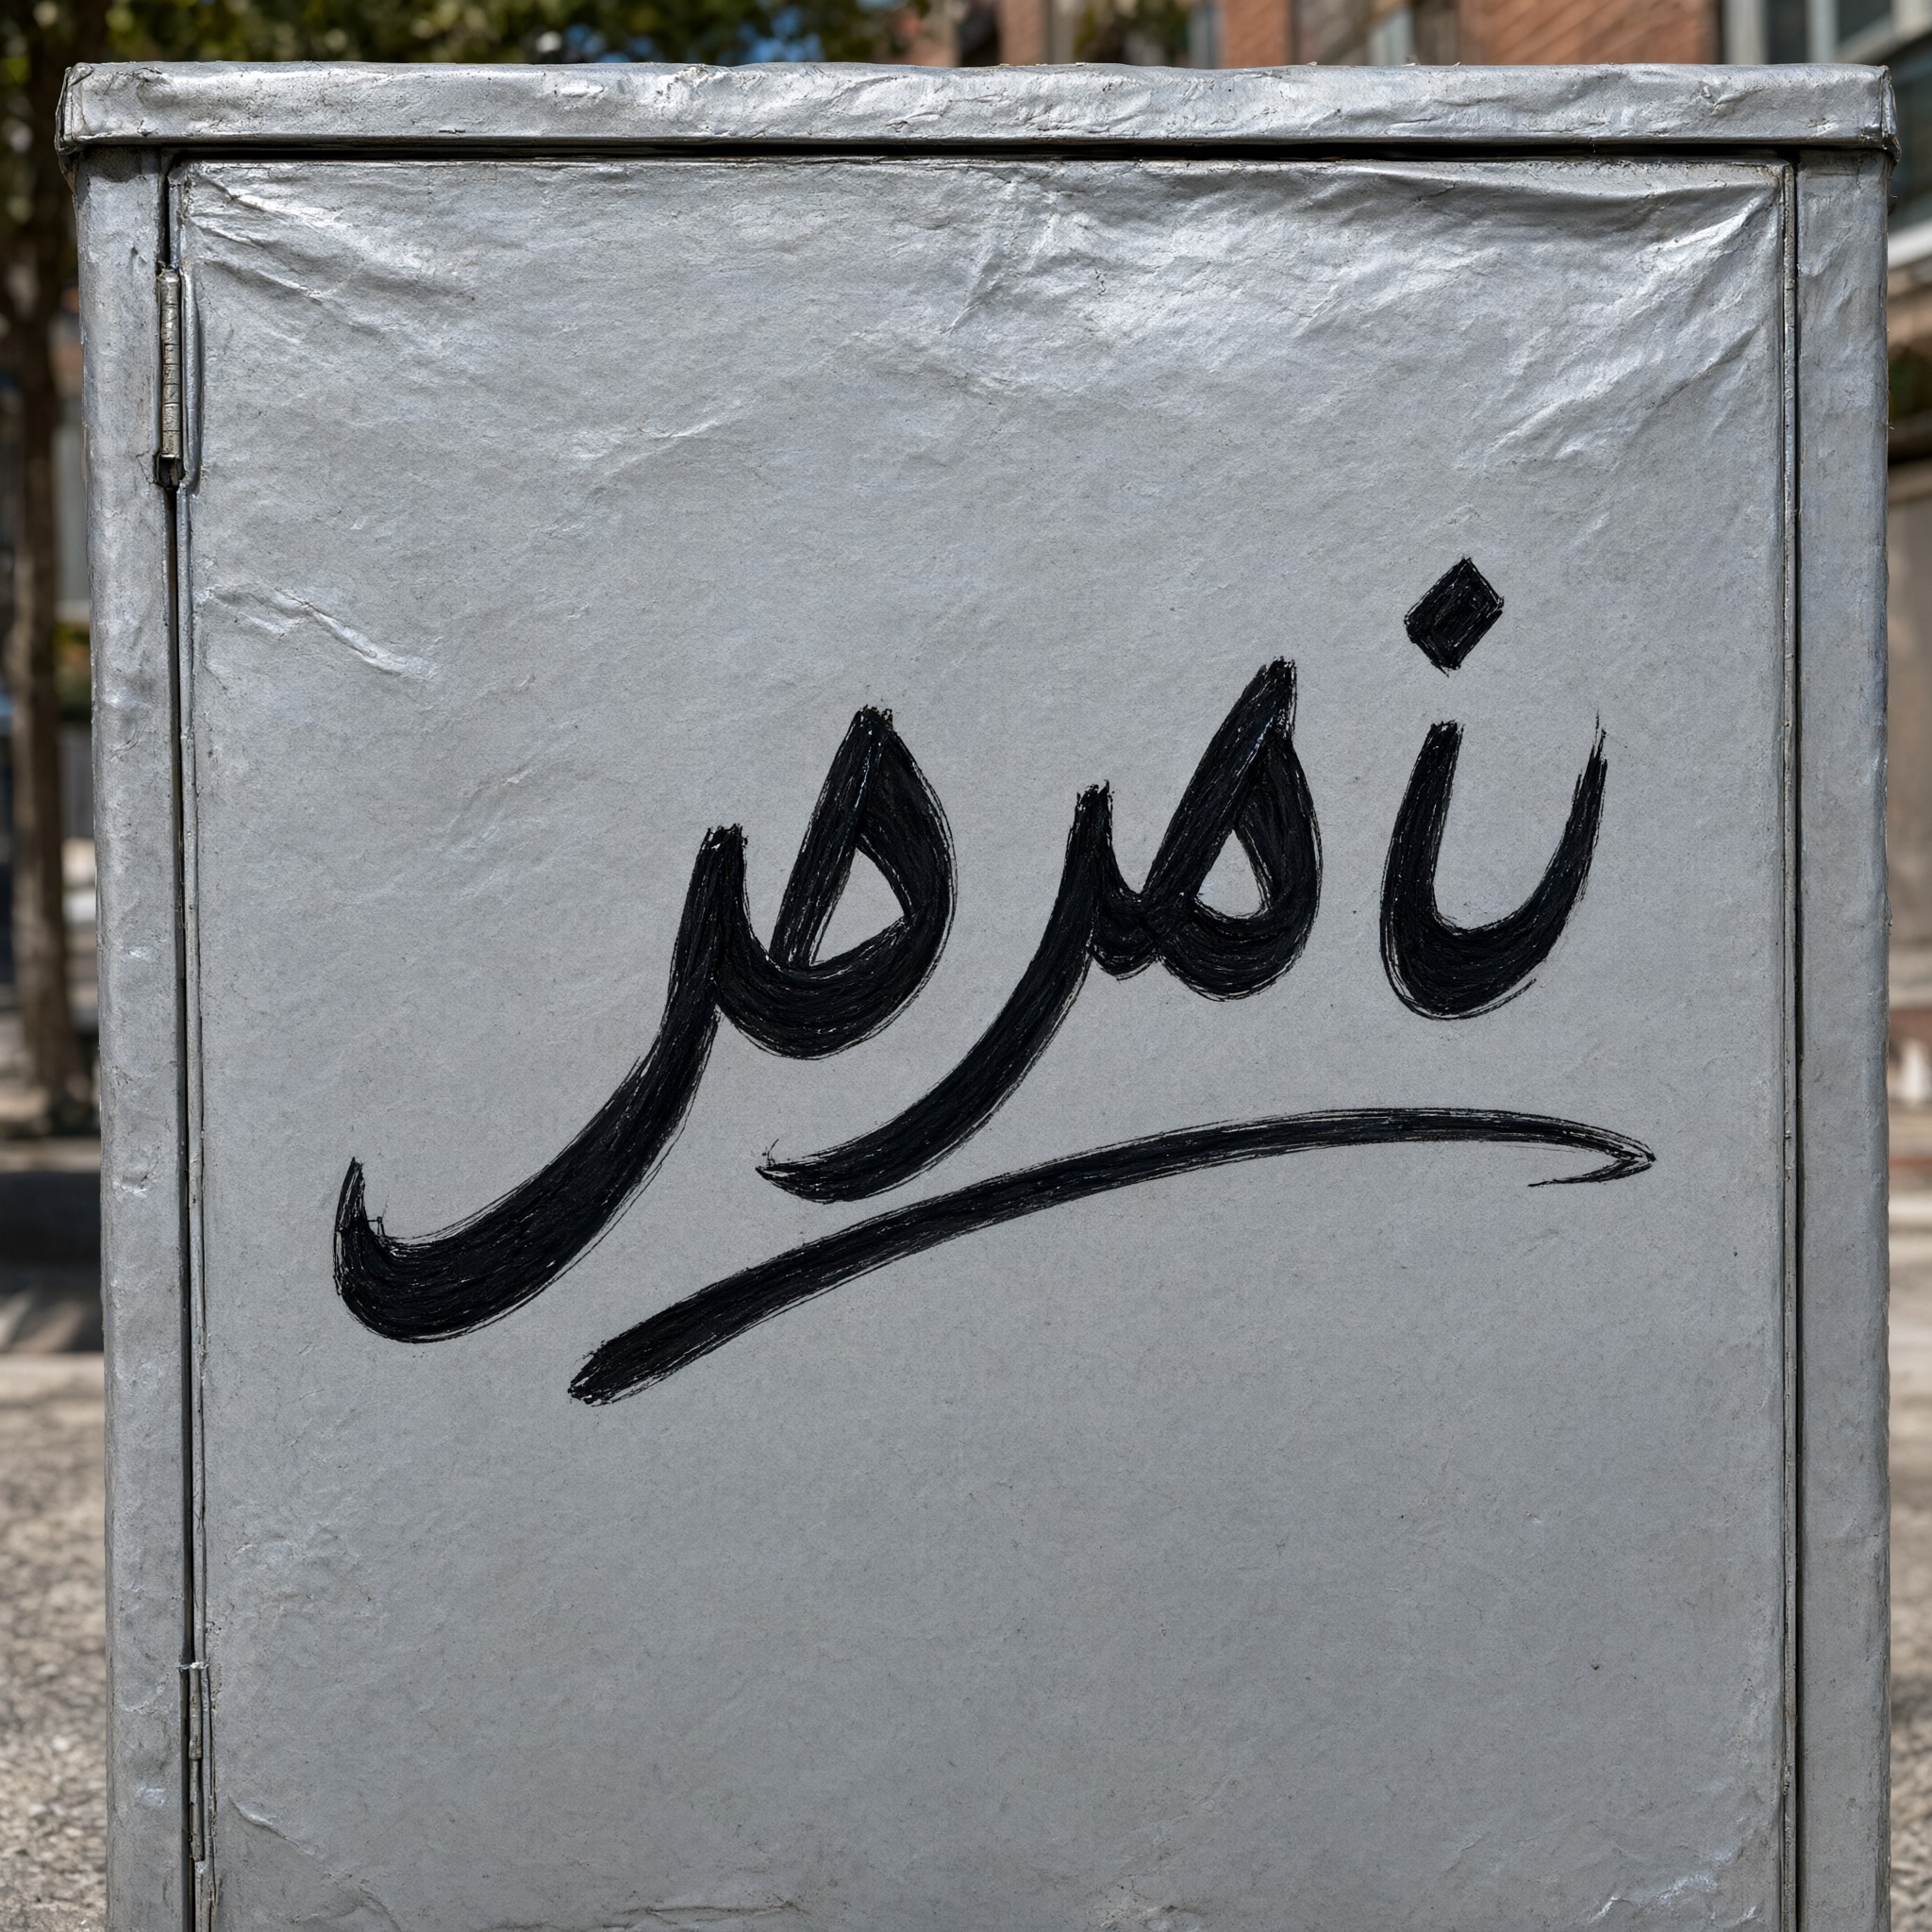
Grok ImagineとSeedreamがアラビア語で失点するのは、点と余計な文字です。Grokのアラビア語のエラー14個のうち6個は点の欠落・追加・位置ずれ、5個は文字の追加。Seedreamの20個では、9個が点、7個が文字の追加でした。ジンジャーブレッドのプロンプトでは、両モデルともكعكの上や周りに丸いクッキーのかけらを散らし、それが余計な点として読めてしまいました。
Qwen-Imageのアラビア語は別の問題です。指定した単語をそもそもほとんど書かず、その周りに、あるいは代わりに、別のアラビア文字を1行書きます。
アラビア語の数字には注意点があります。 レビュアーにアラビア語ネイティブはおらず、AIと人の判定が食い違った41枚は除外しています。順位には自信があります。96%と11%の差は、どんな判定ミスよりはるかに大きいからです。正確なパーセンテージは、ネイティブの読み手がデータセットを訂正するにつれて変わる可能性があります。
トップでも間違える
GPT Imageの3つのエラーは、デスメタルのTシャツでVENOMがVENONになったものと、アラビア語の2語です。1つは語末の文字の誤り(تحيةがتحيئ)、もう1つは文字の脱落(فتنةがفتة)でした。
Nano Bananaの2つは、日本語の単語で1文字が崩れたものと、ハロウィンの中国語画像で、指定の単語「南瓜」のまわりに小さな「PARTY!」のラベルを3つ足したものです。単語自体は正しく、余計な文字が私たちのルールに引っかかりました。
再生成すれば直る?
一部は直ります。モデルしだいです。1枚目が誤りだったケースを数え、もう1回生成して直るかを確かめました。
| 1枚目が誤り | 1回の再生成で修正 | |
|---|---|---|
| GPT Image | 3 | 1 |
| Nano Banana | 2 | 2 |
| Grok Imagine | 28 | 13 |
| Seedream | 36 | 18 |
| Qwen-Image | 86 | 10 |
Grok ImagineとSeedreamのミスは点や線1本といった細部で、2回目でおよそ半分が消えます。Qwen-Imageの余計な文字を足す癖は再生成しても残り、86個中直ったのは10個だけでした。モデルが文字を足し続けるなら、再生成するよりプロンプトを書き直すほうが効きます。
文字入れにおすすめの画像生成AIは?
- 言語を問わず1回で決めたい: GPT ImageかNano Banana。見た目の好みで選んでください。文字の正確さは、この2つから選ぶ理由になりません。
- 英語か中国語だけ: 5モデルどれでも使えます。Grok ImagineやSeedreamの画風が好みなら選んで問題ありません。印刷前に結果を確認してください。
- 日本語: GPT ImageかNano Banana。ほかを使うなら、かなを1文字ずつ読み、濁点を確認してください。
- アラビア語: GPT ImageかNano Banana。ほかの3モデルのアラビア語は、ネイティブが確認しないかぎり私たちなら使いません。
- Qwen-Image: 入れる単語は短くし、指定した単語だけでなく、画像全体に余計な文字がないか確認してください。
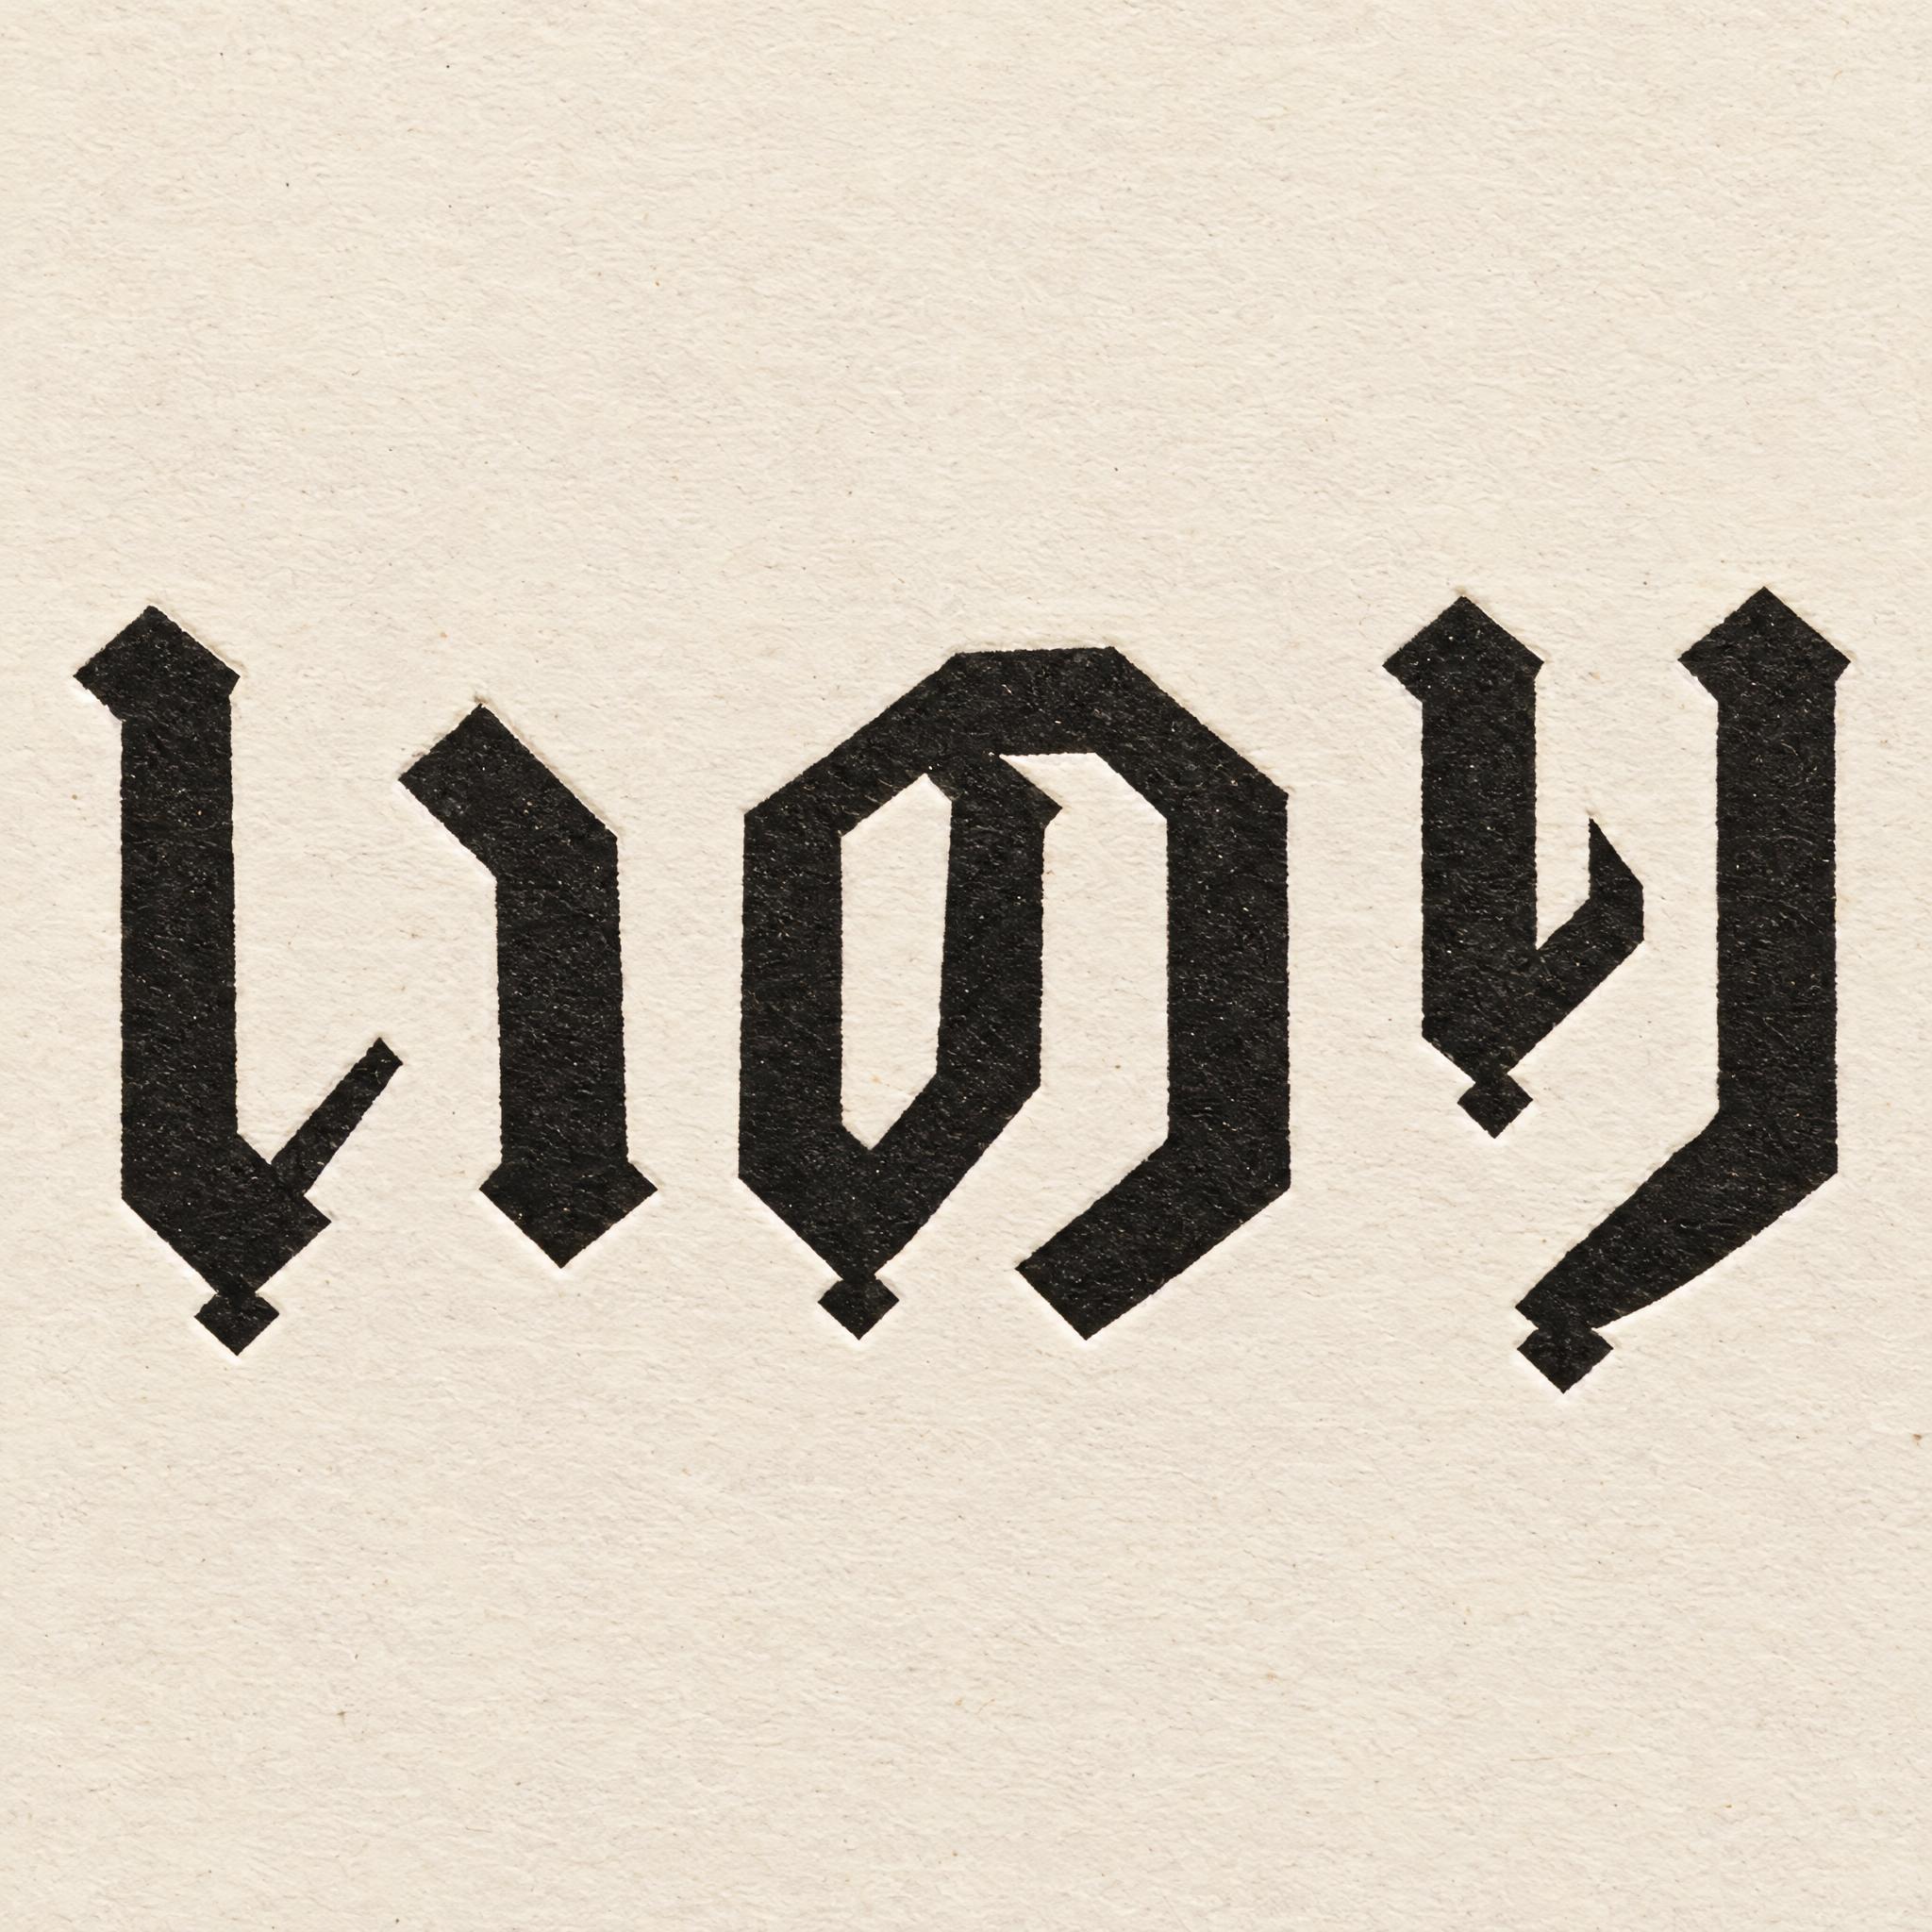
AIFontのフォントページでは、言語ごとに5モデルすべての結果を載せているので、プロンプトをコピーする前にそのスタイルでどう書けるかがわかります。ゴシックフォントとグラフィティ文字のコレクションで並べて比べるのがおすすめです。
データは公開しています
データセットの全2,495枚を、プロンプト、判定、レビュアーのメモとともにCC BY 4.0で公開しています:GitHubのAIFont文字レンダリングデータセット、アーカイブはZenodo(DOI 10.5281/zenodo.23815210)。アラビア語や日本語などデータに含まれる言語が読めて、判定の誤りを見つけたら、issueを立ててください。訂正は次のリリースとこの表に反映します。
新しいスタイルや言語が増えたとき、またモデルが更新されたときに、この比較をやり直します。
よくある質問
2026年、文字入れにおすすめの画像生成AIはどれですか?
2,016枚を検証した結果、GPT Image 2.5とNano Banana 2.1が同率トップで、404語中それぞれ401語と402語を正しく書きました。差は画像1枚分なので、引き分けと見ています。どちらもアラビア文字を含むすべての文字体系で95%を超えました。
日本語やアラビア語の文字入れには、どの画像生成AIがいいですか?
GPT ImageとNano Bananaです。日本語では59語中58〜59語を正しく書き、ほかの3モデルは45〜52語でした。アラビア語では96%と100%で、Grok Imagineは71%、Seedreamは57%、Qwen-Imageは11%でした。
Qwen-Imageはなぜ文字を間違えるのですか?
主な原因は、頼んでいない文字を足すことです。Qwen-Imageのエラーのうち40件は、指定した単語は正しく書けているのに、画像のあちこちに余計な文章を一段落ぶん描き込んだものでした。その多くはプロンプト自体が崩れて写り込んだものです。同じプロンプトで再生成しても、まず直りません。
テストデータは公開されていますか?
はい。すべての画像、プロンプト、判定、レビュアーのメモを、AIFontの文字レンダリングデータセットとしてGitHubとZenodoでCC BY 4.0のもと公開しています。誰でも訂正を送れます。