AI 生图模型写字哪家准?2026 实测
5 个生图模型、7 种语言写字实测:GPT Image、Nano Banana 准确率 99%,Qwen-Image 79%。
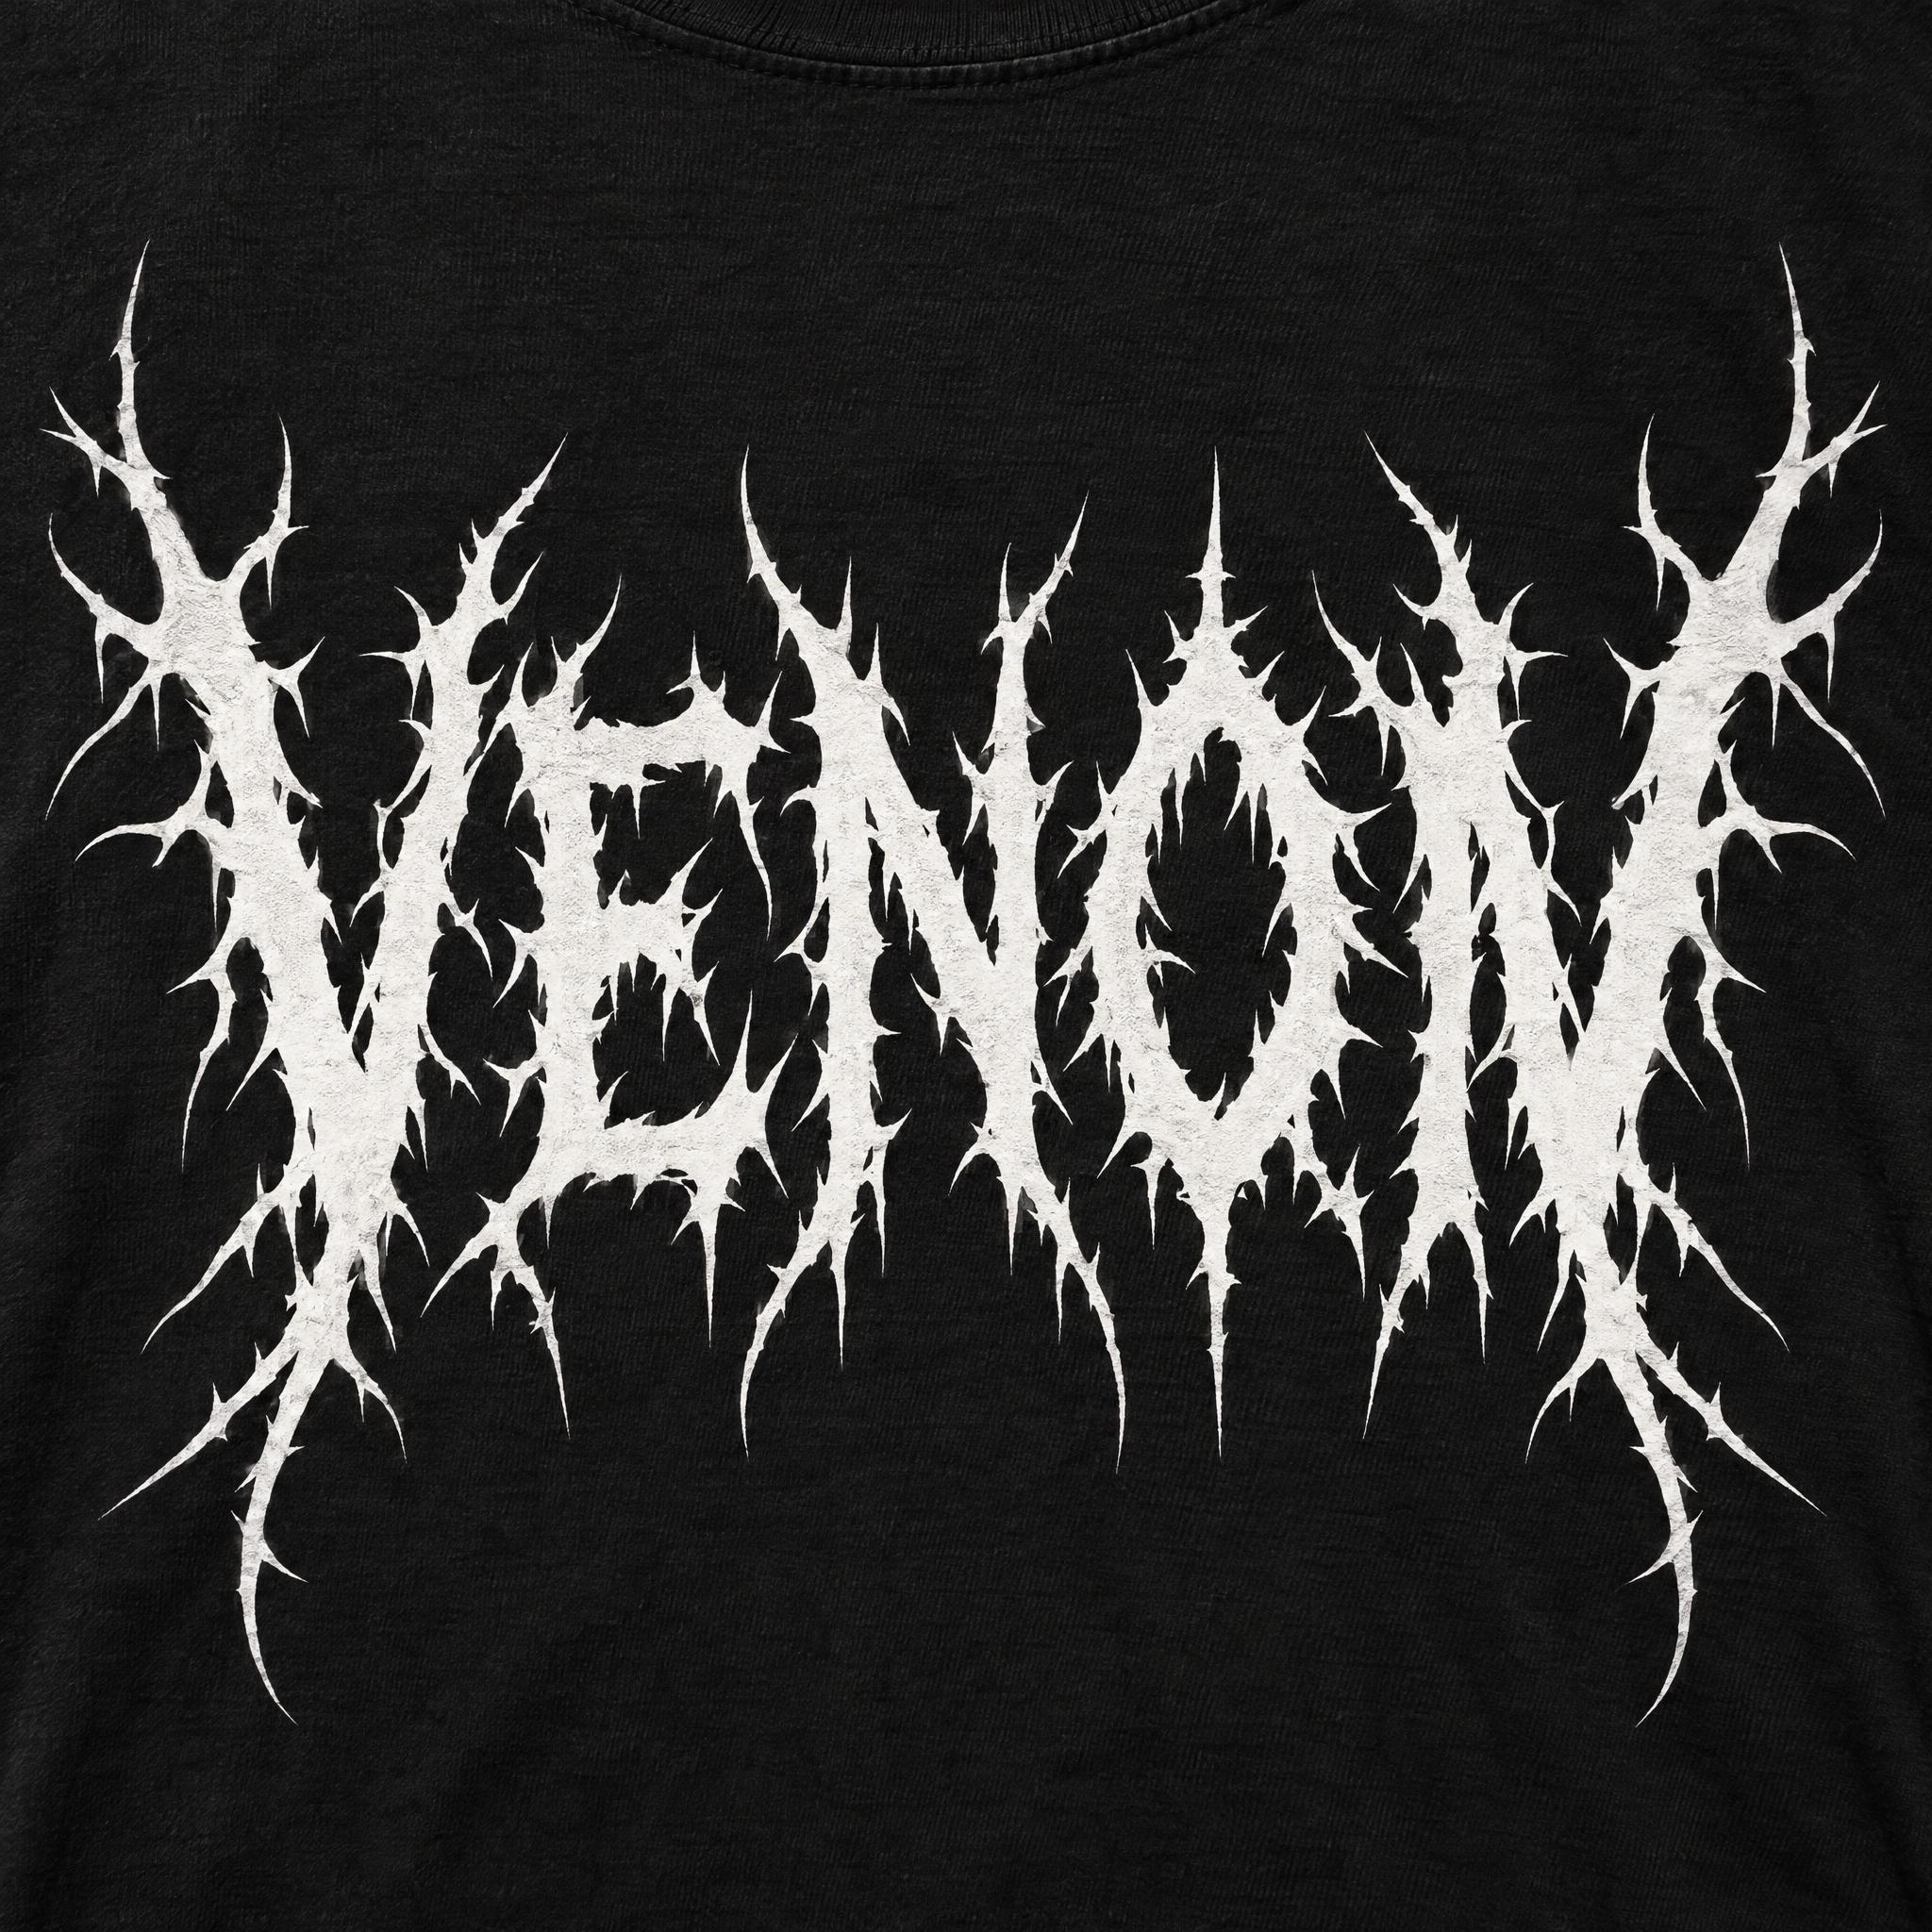
让 AI 生图模型做一件写着 VENOM 的死亡金属 T 恤,我们测下来最准的模型印出来的是 VENON。这是 GPT Image 在 404 张图里仅有的 3 处拼写错误之一。Qwen-Image 错了 86 处。
各家生图模型现在拉开差距的地方,就是写字。一个模型能把镀铬、颜料滴落、影棚灯光画得跟照片一样,却会放错一个点,把一个词变成另一个词。我们的工作就是做 AI 字体提示词,每条提示词发布前都要在五个模型上出图,每张图逐个字母核对。做到第 59 款,这些核对攒成了下面这份对比。
结论先看
| 文字 | GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image |
|---|---|---|---|---|---|
| 拉丁字母(英、德、西、葡) | 235/236 | 235/235 | 229/235 | 230/235 | 213/235 |
| 中文 | 59/59 | 58/59 | 58/59 | 56/59 | 56/59 |
| 日文 | 59/59 | 58/59 | 52/59 | 51/59 | 45/59 |
| 阿拉伯文 | 48/50 | 51/51 | 35/49 | 27/47 | 6/53 |
| 合计 | 99% | 100% | 93% | 91% | 79% |
- GPT Image 2.5 和 Nano Banana 2.1 是写字最准的生图模型。 各自约 400 张图里只错两三处,每种文字都稳。
- Grok Imagine 2.0 和 Seedream 5.0 Pro 拉丁字母和中文没问题,到日文开始出错,阿拉伯文错得很多。
- Qwen-Image 3.0 Pro 是唯一在普通英文字母单词上也丢分的模型,阿拉伯文 53 个只写对 6 个。
怎么测的
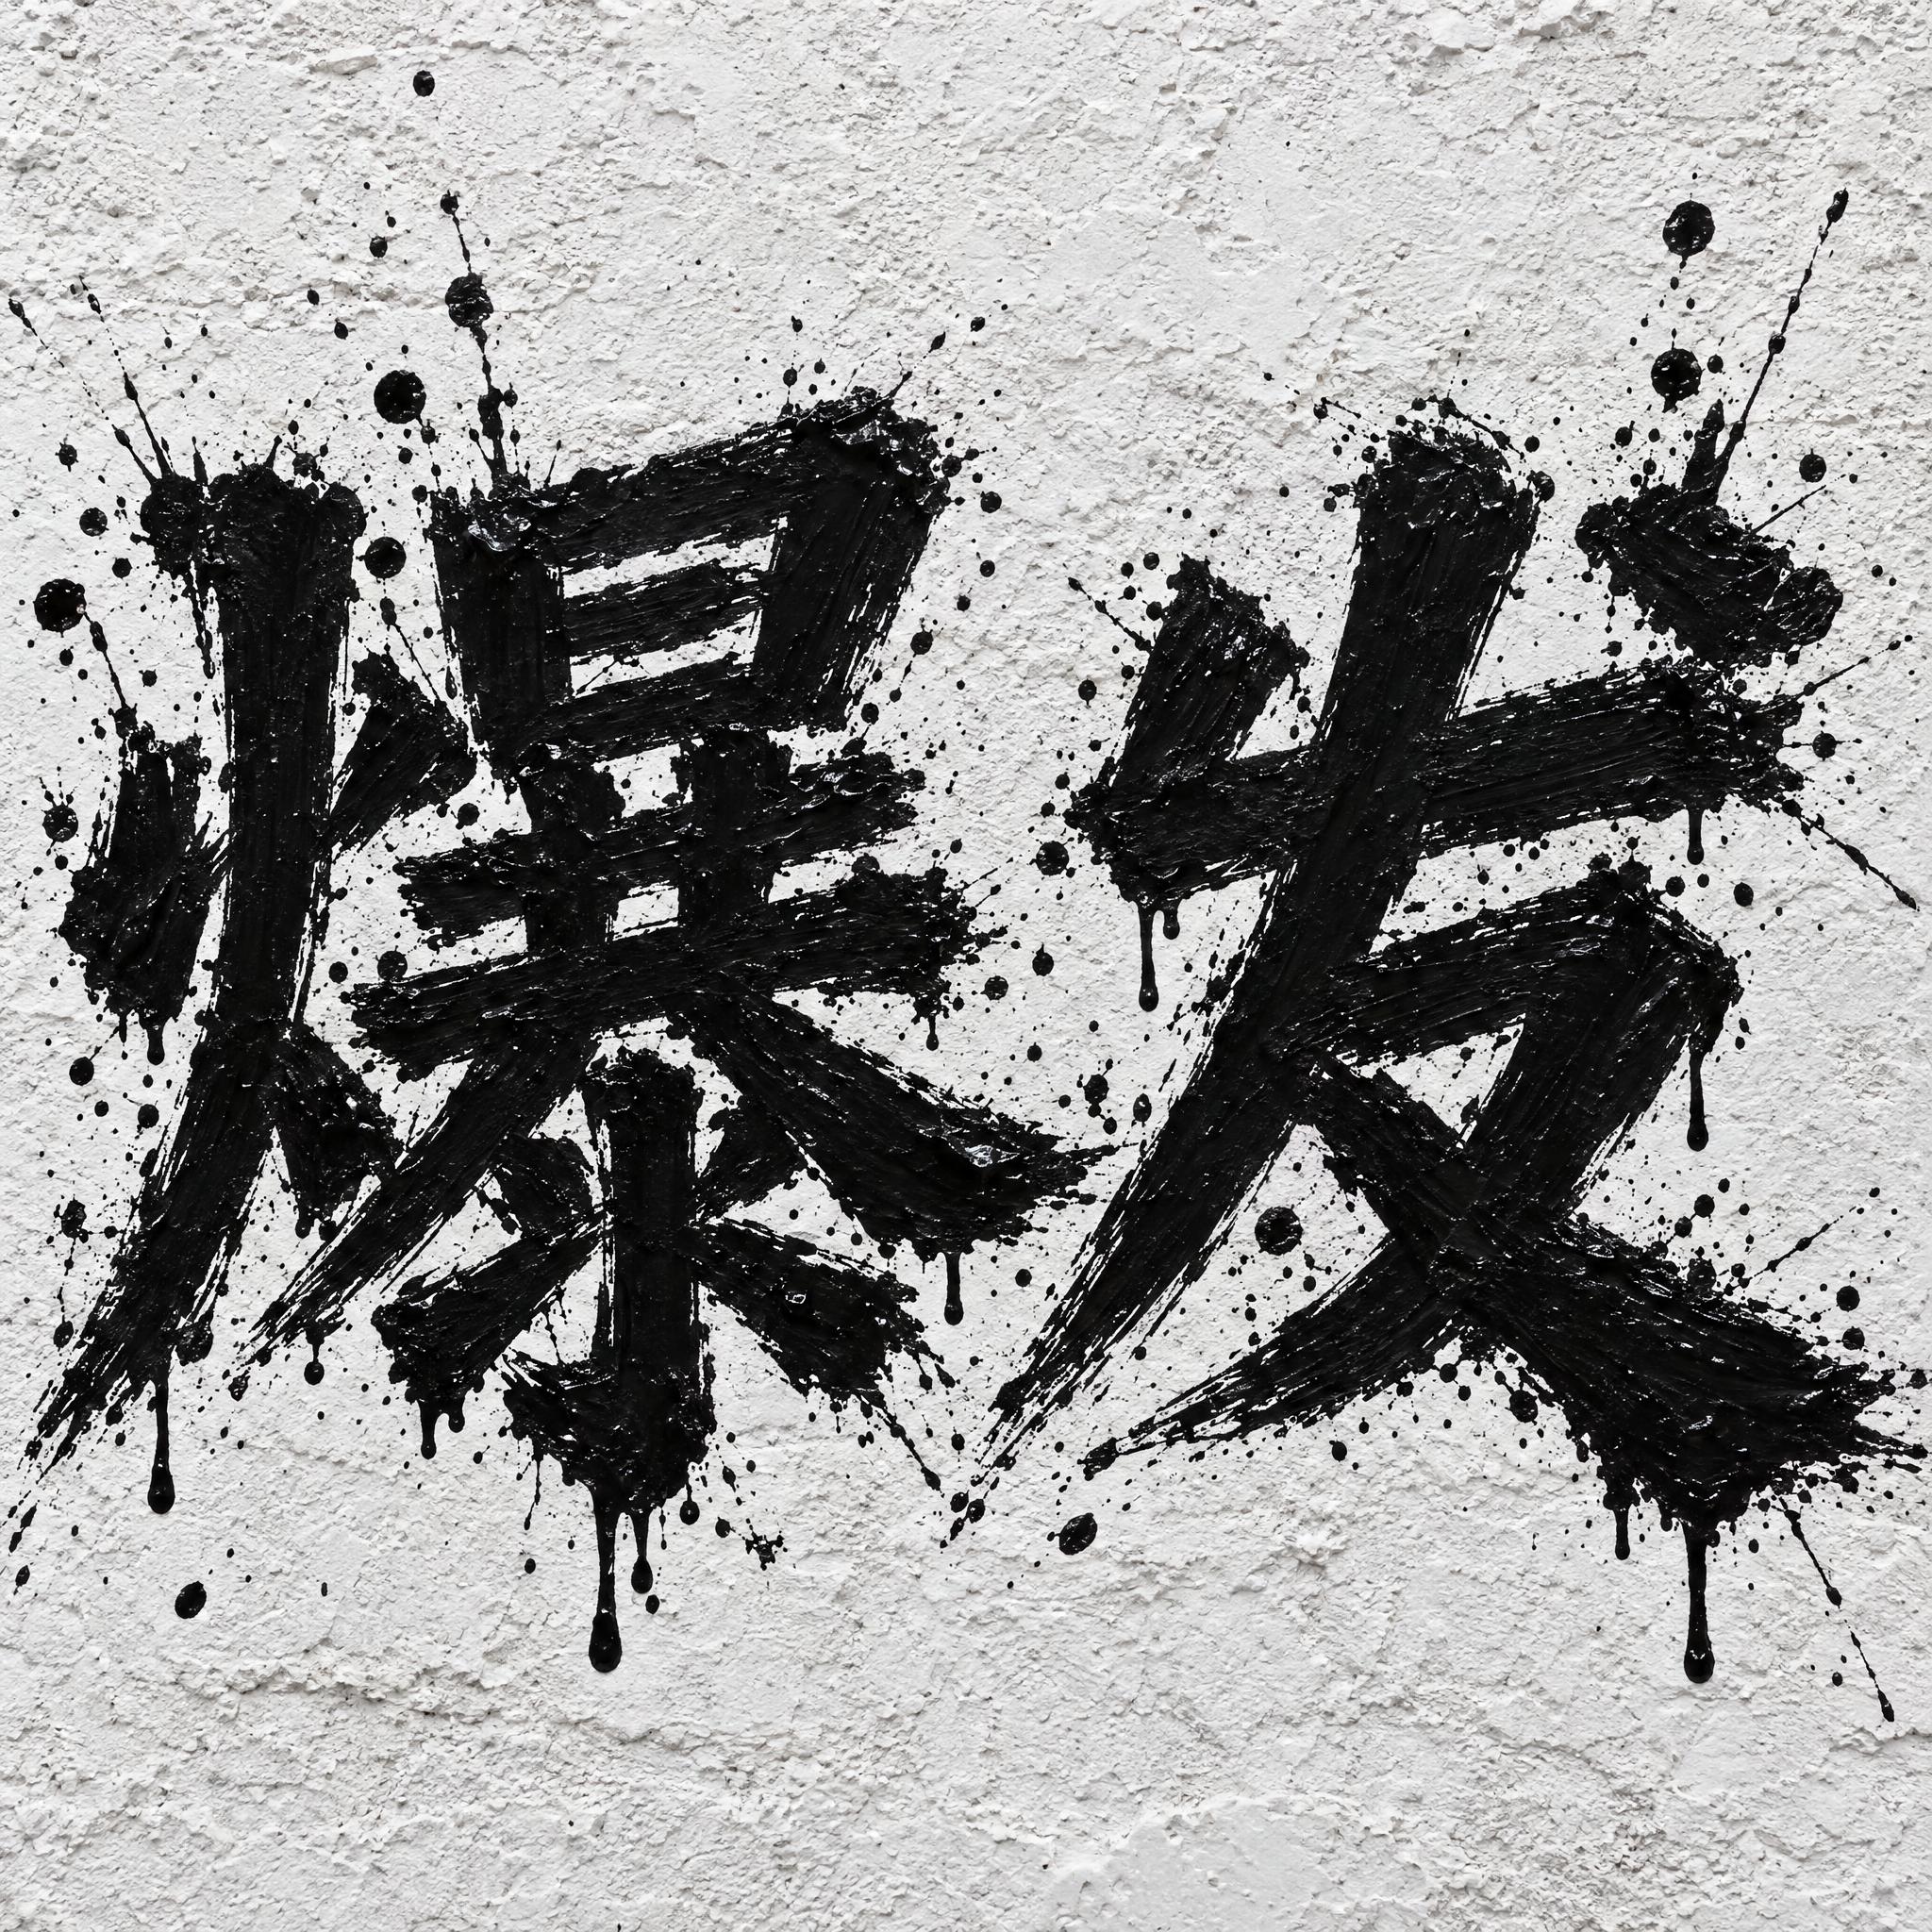
59 款风格都是 AIFont 已发布的提示词,比如 Textura、Paint Splatter、Tagging Letters。每款风格每种语言一条提示词,图里写一个该语言的短词:FRESH、Reino、ばくはつ、كعك。
- 每个模型用同一条提示词。 同一款风格、同一种语言,五个模型拿到的提示词一字不差。只算每个模型返回的第一张图,不挑重跑里好的那张。
- 参数: 2K、正方形,走各家官方 API,2026 年 10 月 22 日到 29 日出图。GPT Image 用 xhigh 画质,Grok Imagine 用 medium(它的最高档),另外三家没有画质选项。
- 模型: GPT Image 2.5(OpenAI)、Nano Banana 2.1(Google)、Grok Imagine Image 2.0(xAI)、Seedream 5.0 Pro(字节跳动)、Qwen-Image 3.0 Pro(阿里巴巴)。
- 怎么判: 每张图都先由 AI 核对,中文、日文、阿拉伯文放大看。计分的图里有 489 张又经过人工核对:AI 判错或拿不准的全部、大部分阿拉伯文,以及从其余图里随机抽的一批。
- 什么算错: 说得出它读成了什么(VENON 而不是 VENOM)才算错。风格化的字形、装饰笔画、大小写不同都算对。提示词没要求、图里却多出来的字算错。
这样一共是 2,057 张首次出图。其中 41 张阿拉伯文 AI 和人工判断不一致,两边又都不是阿拉伯语母语者,所以不计入,最后计分的是 2,016 张。
拉丁字母和中文:五家都过关
英、德、西、葡和中文,每个模型的准确率都在 90% 以上。只要写的是这几种语言的短词,五家里随便哪个,第一张图通常就能写对。
唯一的例外是 Qwen-Image 写西语和葡语,每种语言错 9 到 10 个。它典型的错法不是拼错。
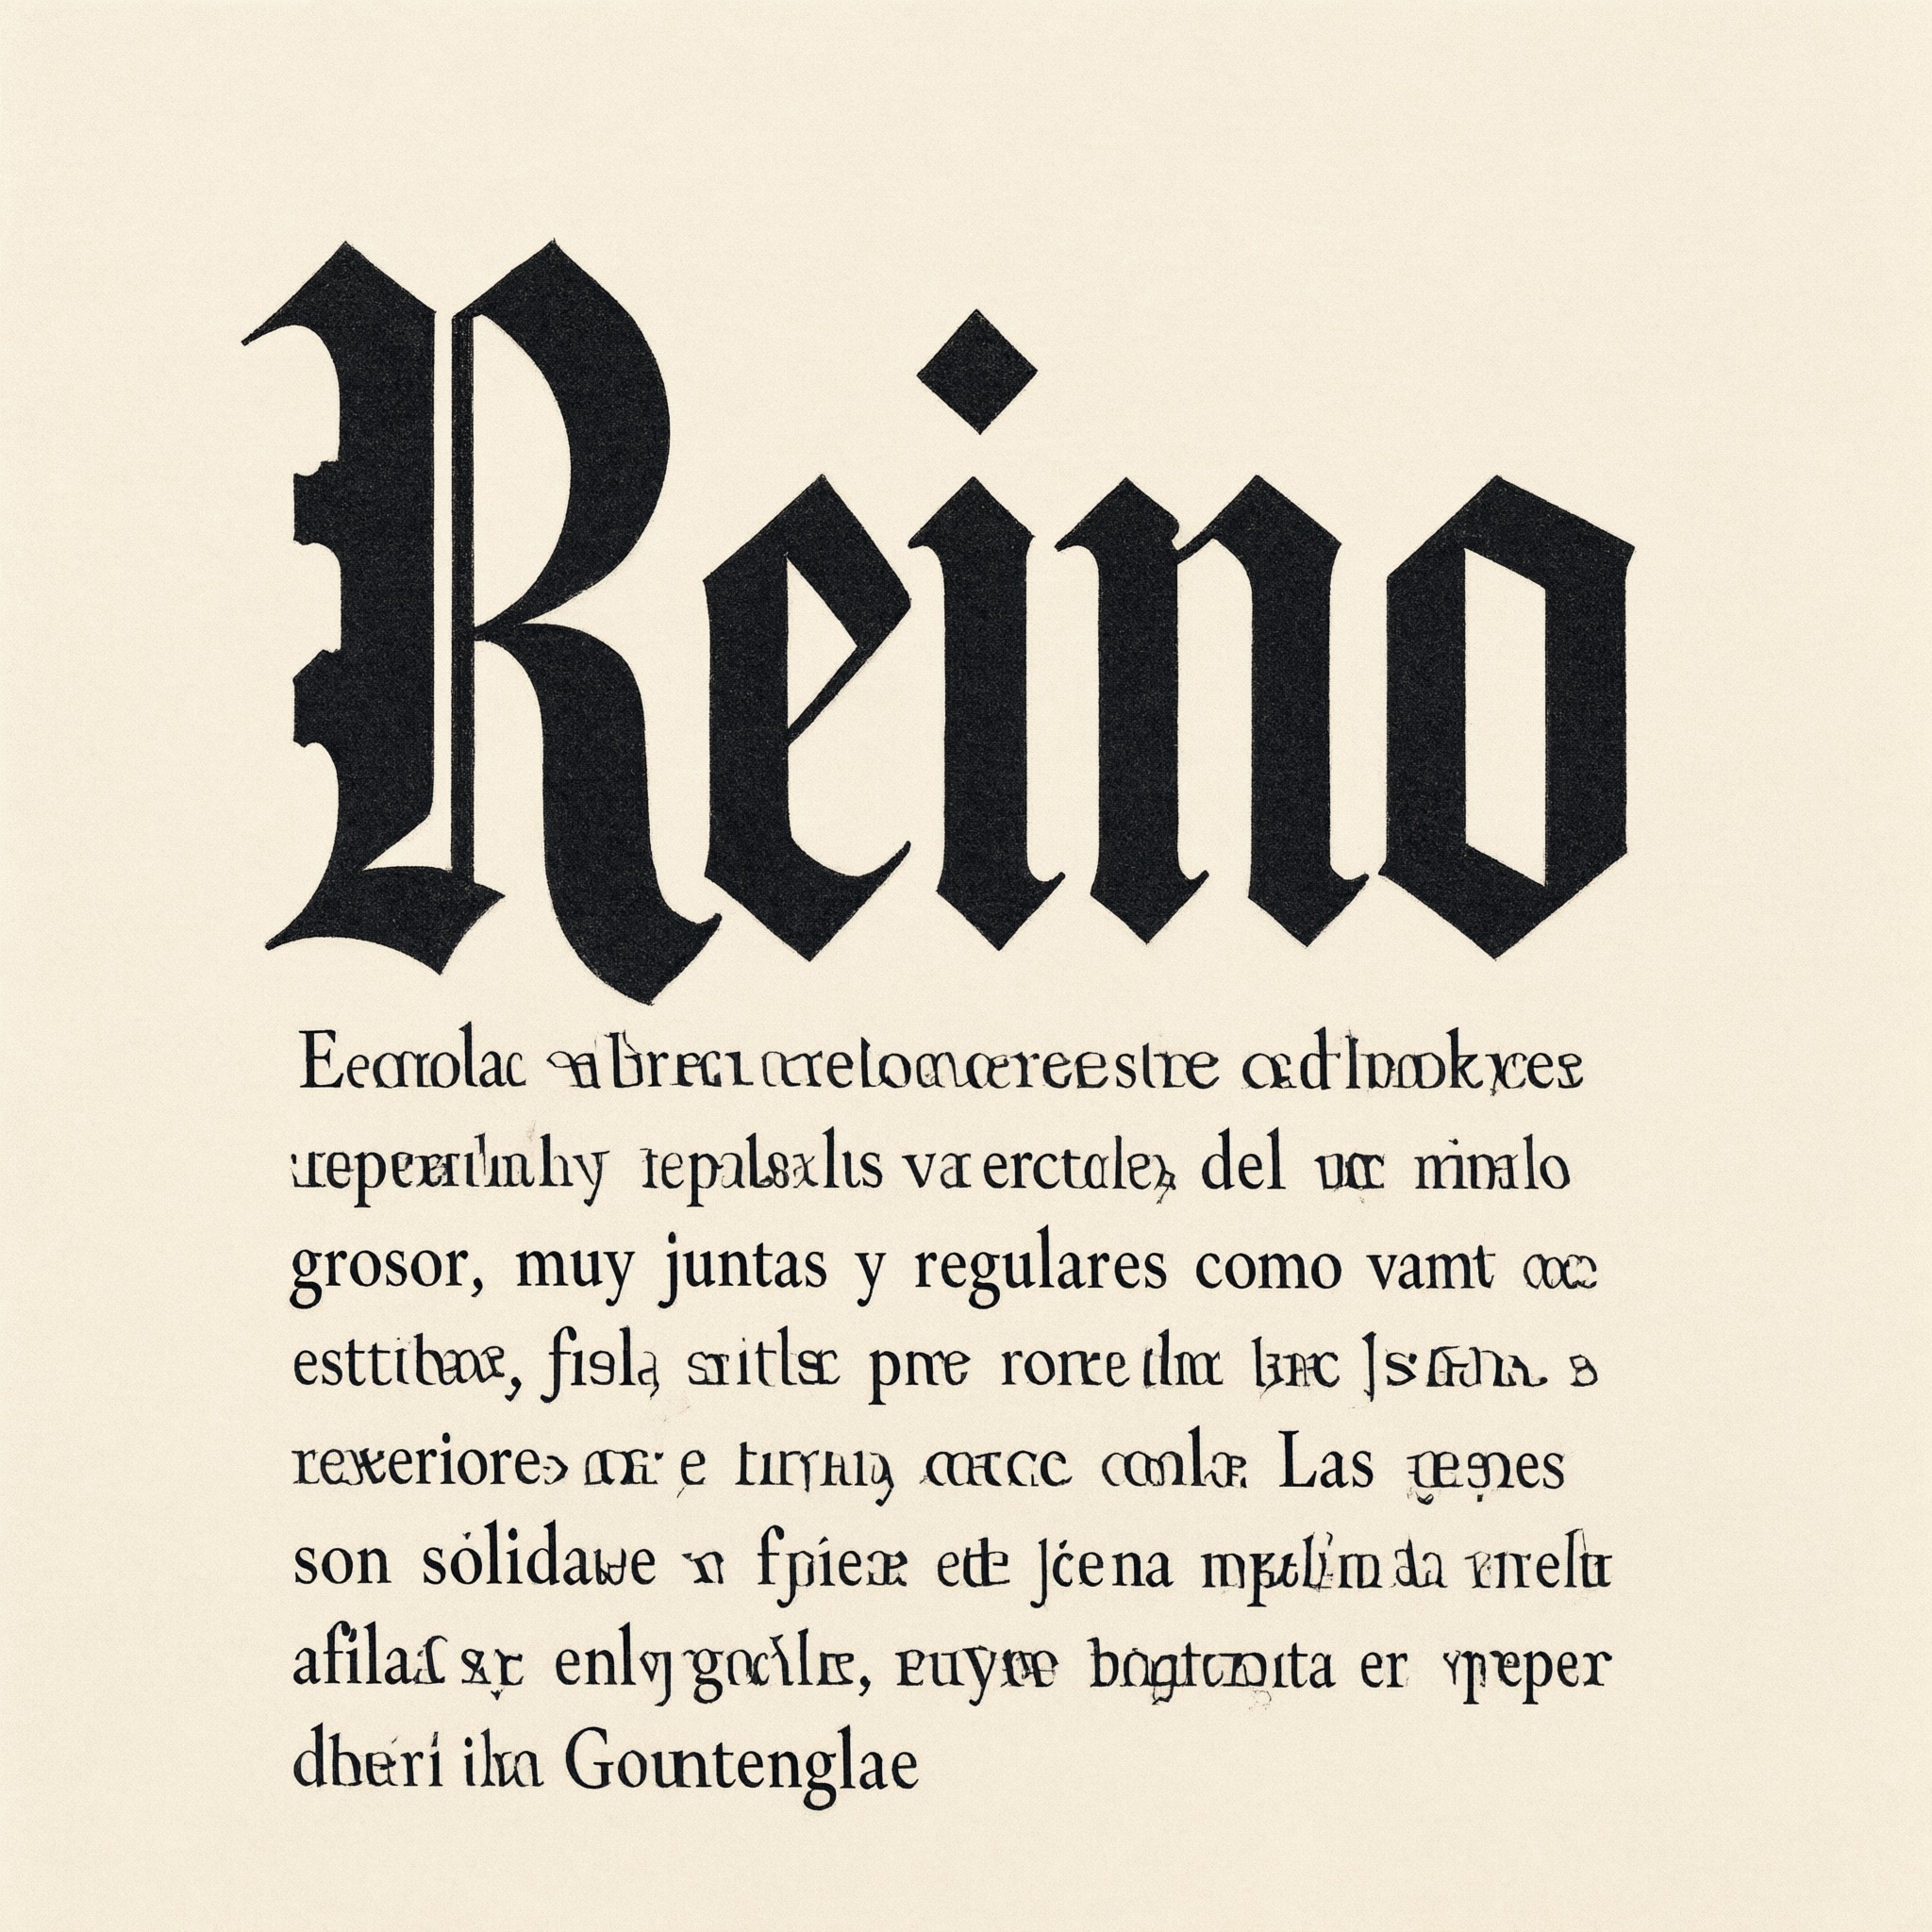
「要求的词写对了,旁边多出一大段字」这种错,占了 Qwen-Image 86 处错误里的 40 处。多出来的字常常就是提示词本身,被打乱了写进图里。
日文:差距从这里拉开
| GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image | |
|---|---|---|---|---|---|
| 日文 | 59/59 | 58/59 | 52/59 | 51/59 | 45/59 |
日文假名上有些小符号会改变整个词:两个点(浊点)就把 は 变成了 ば。在我们的颜料飞溅提示词上,Grok Imagine 和 Seedream 都把浊点加到了不该加的地方。
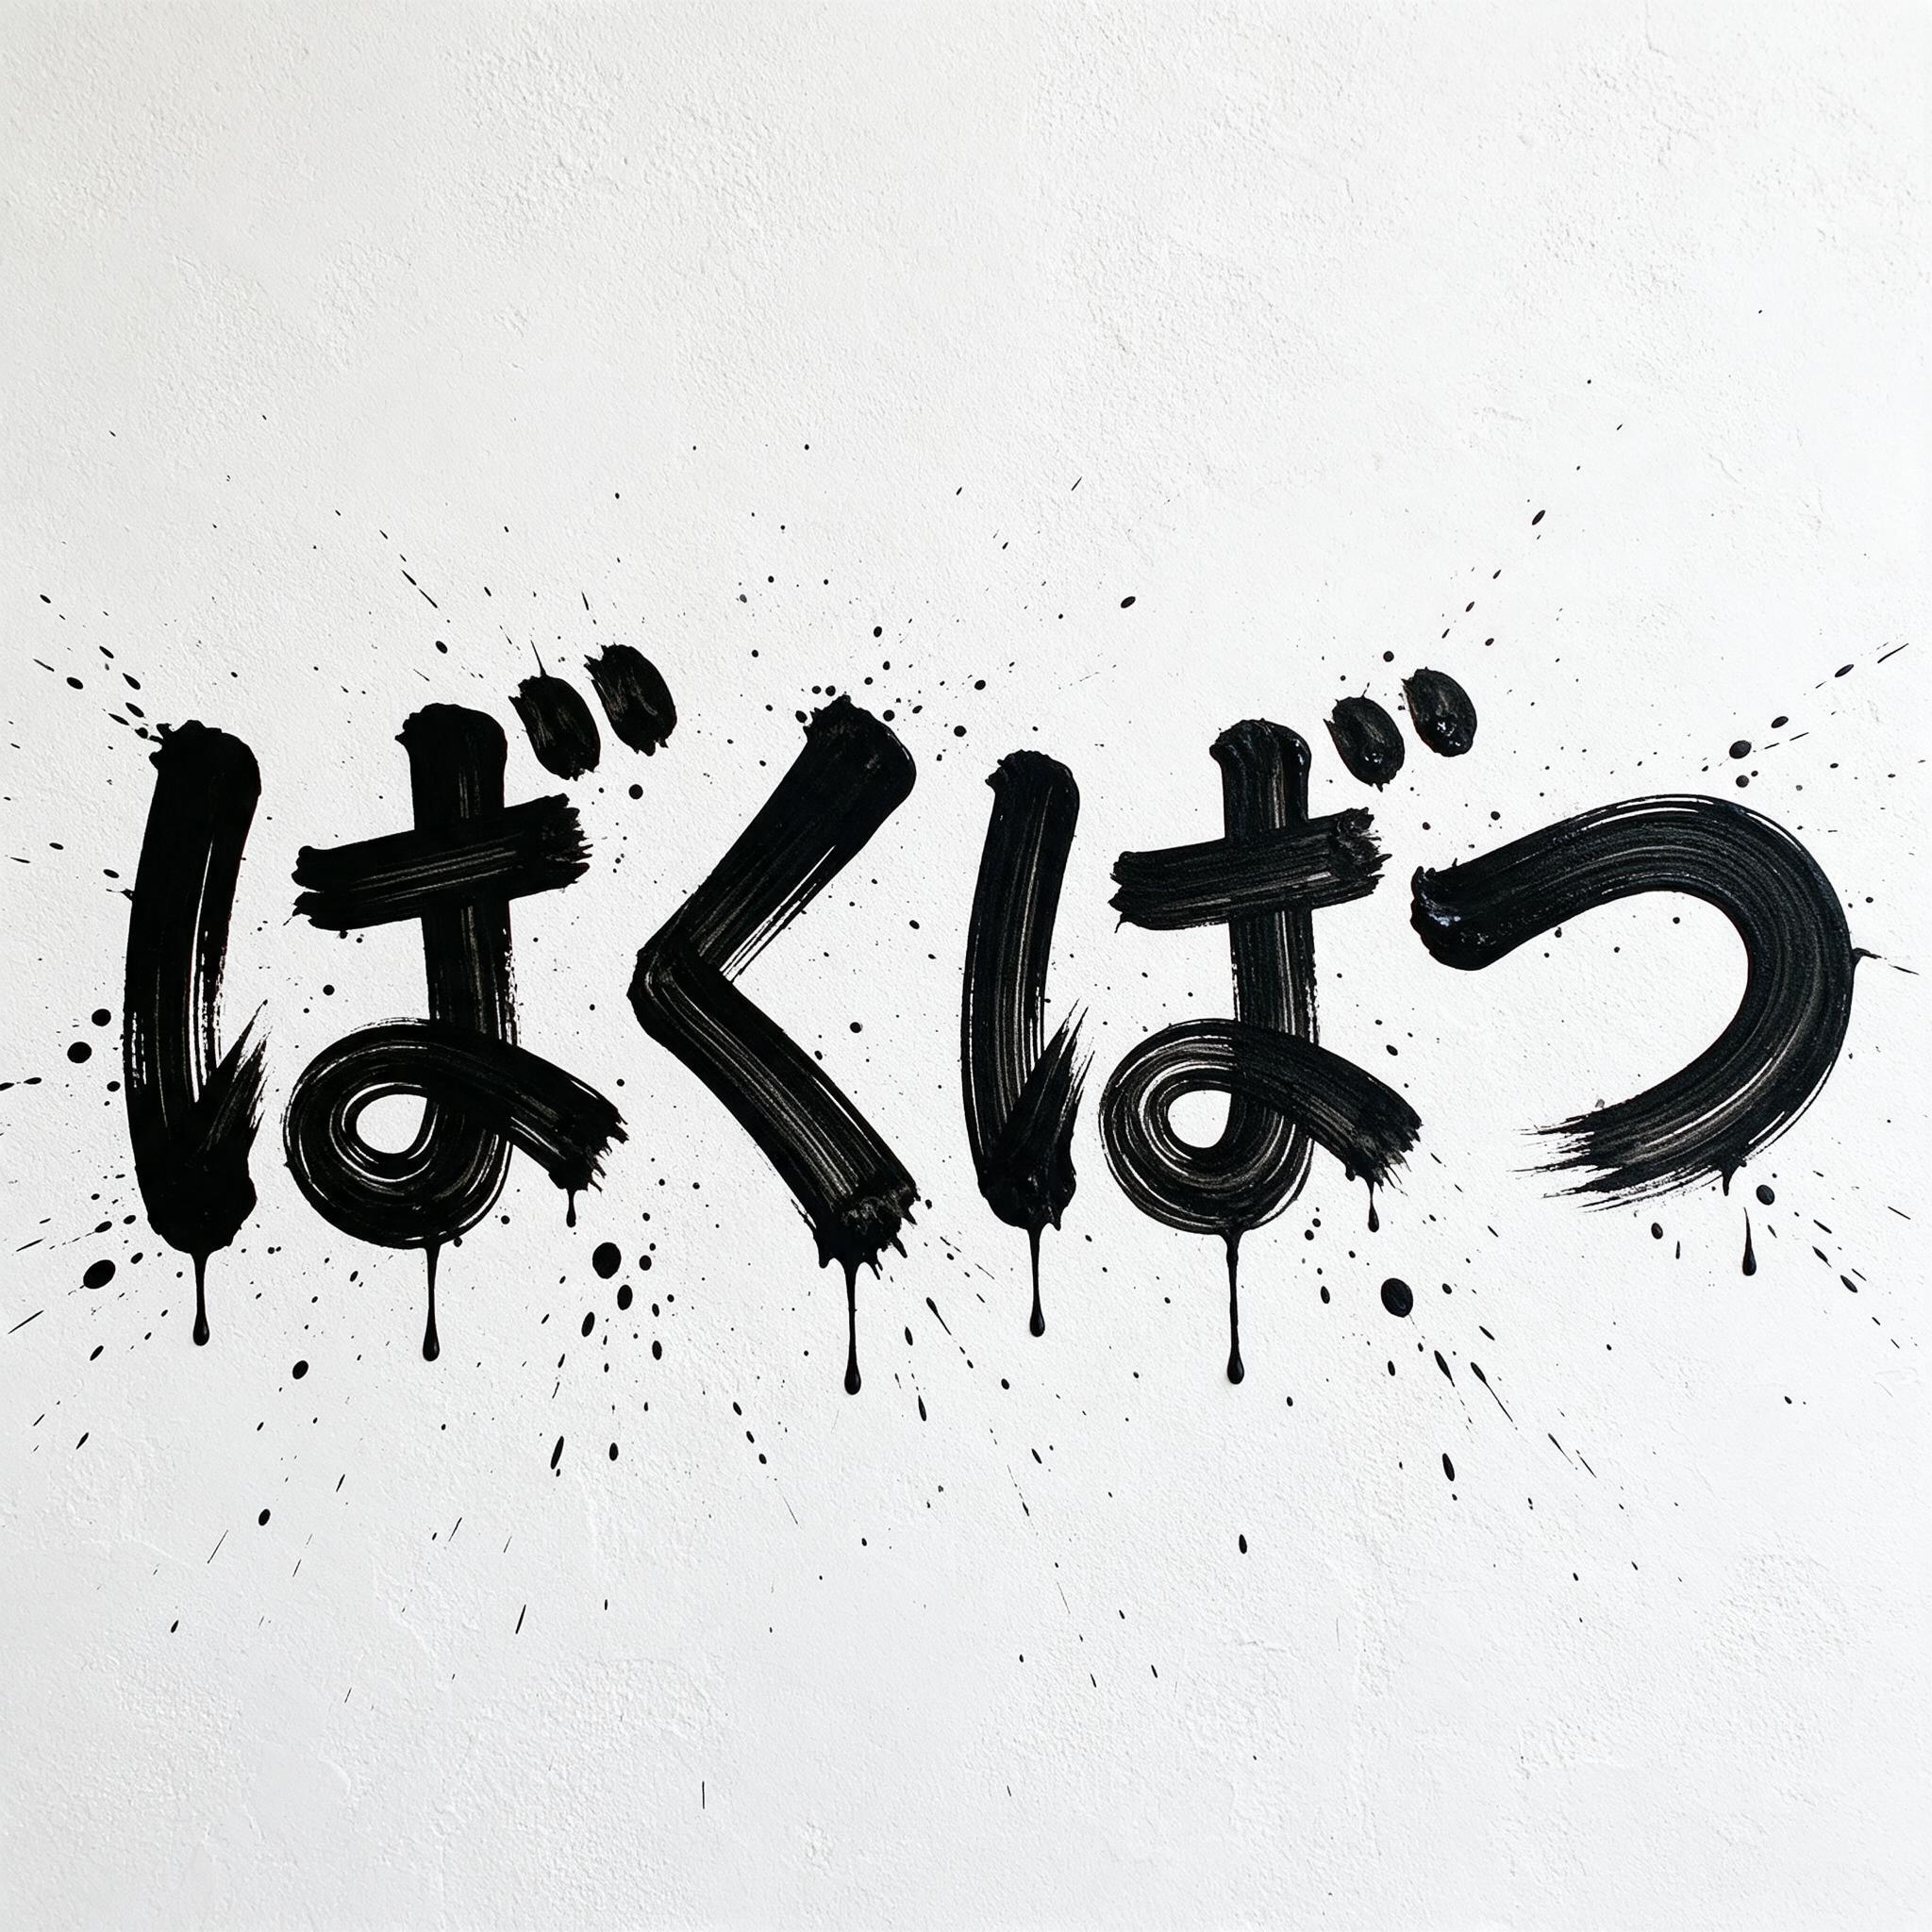
Grok Imagine 和 Seedream 的其他日文错误也是一个样:错一个字,而不是写成一团乱码。Grok 把 ストリート 写成 ストリトト,ジンクス 写成 ジングス,ぼうけん 写成 ぼうげん;Seedream 把 かくとう 写成 かくどう,ねがい 写成 ねがいの。日本读者一眼就能看出来。
阿拉伯文:只有两家靠得住
| GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image | |
|---|---|---|---|---|---|
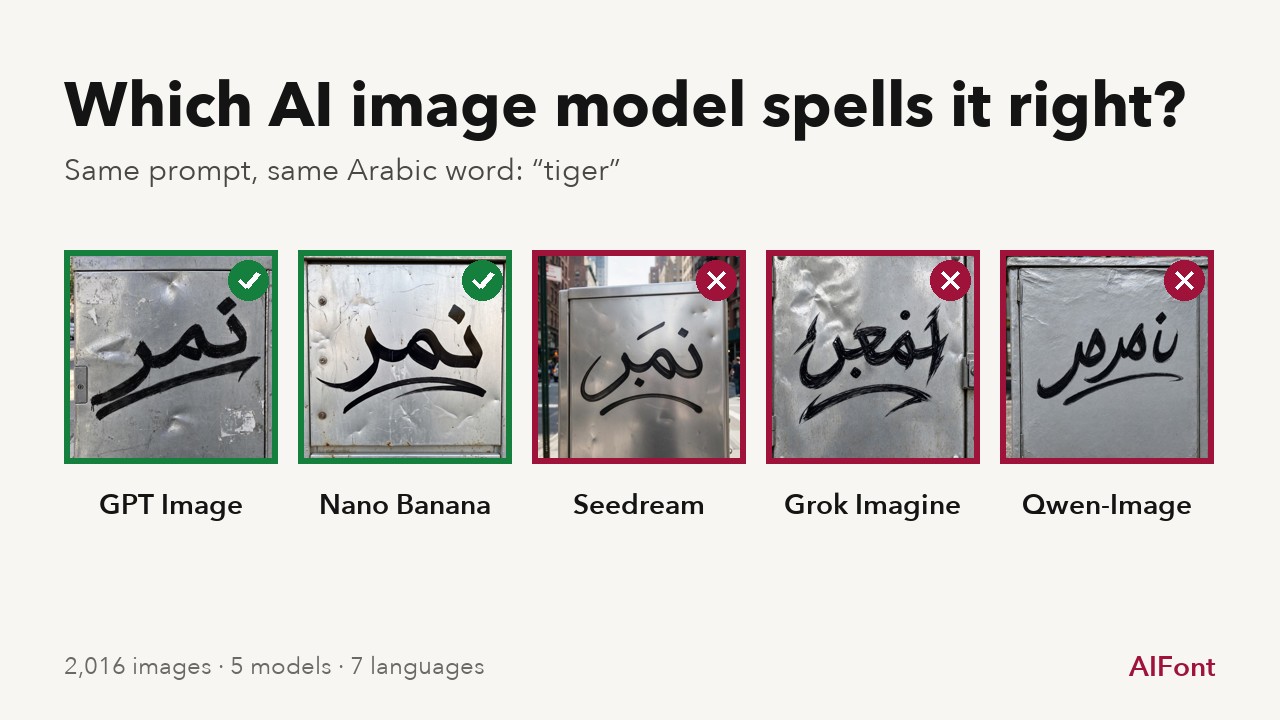
| 阿拉伯文 | 48/50(96%) | 51/51(100%) | 35/49(71%) | 27/47(57%) | 6/53(11%) |
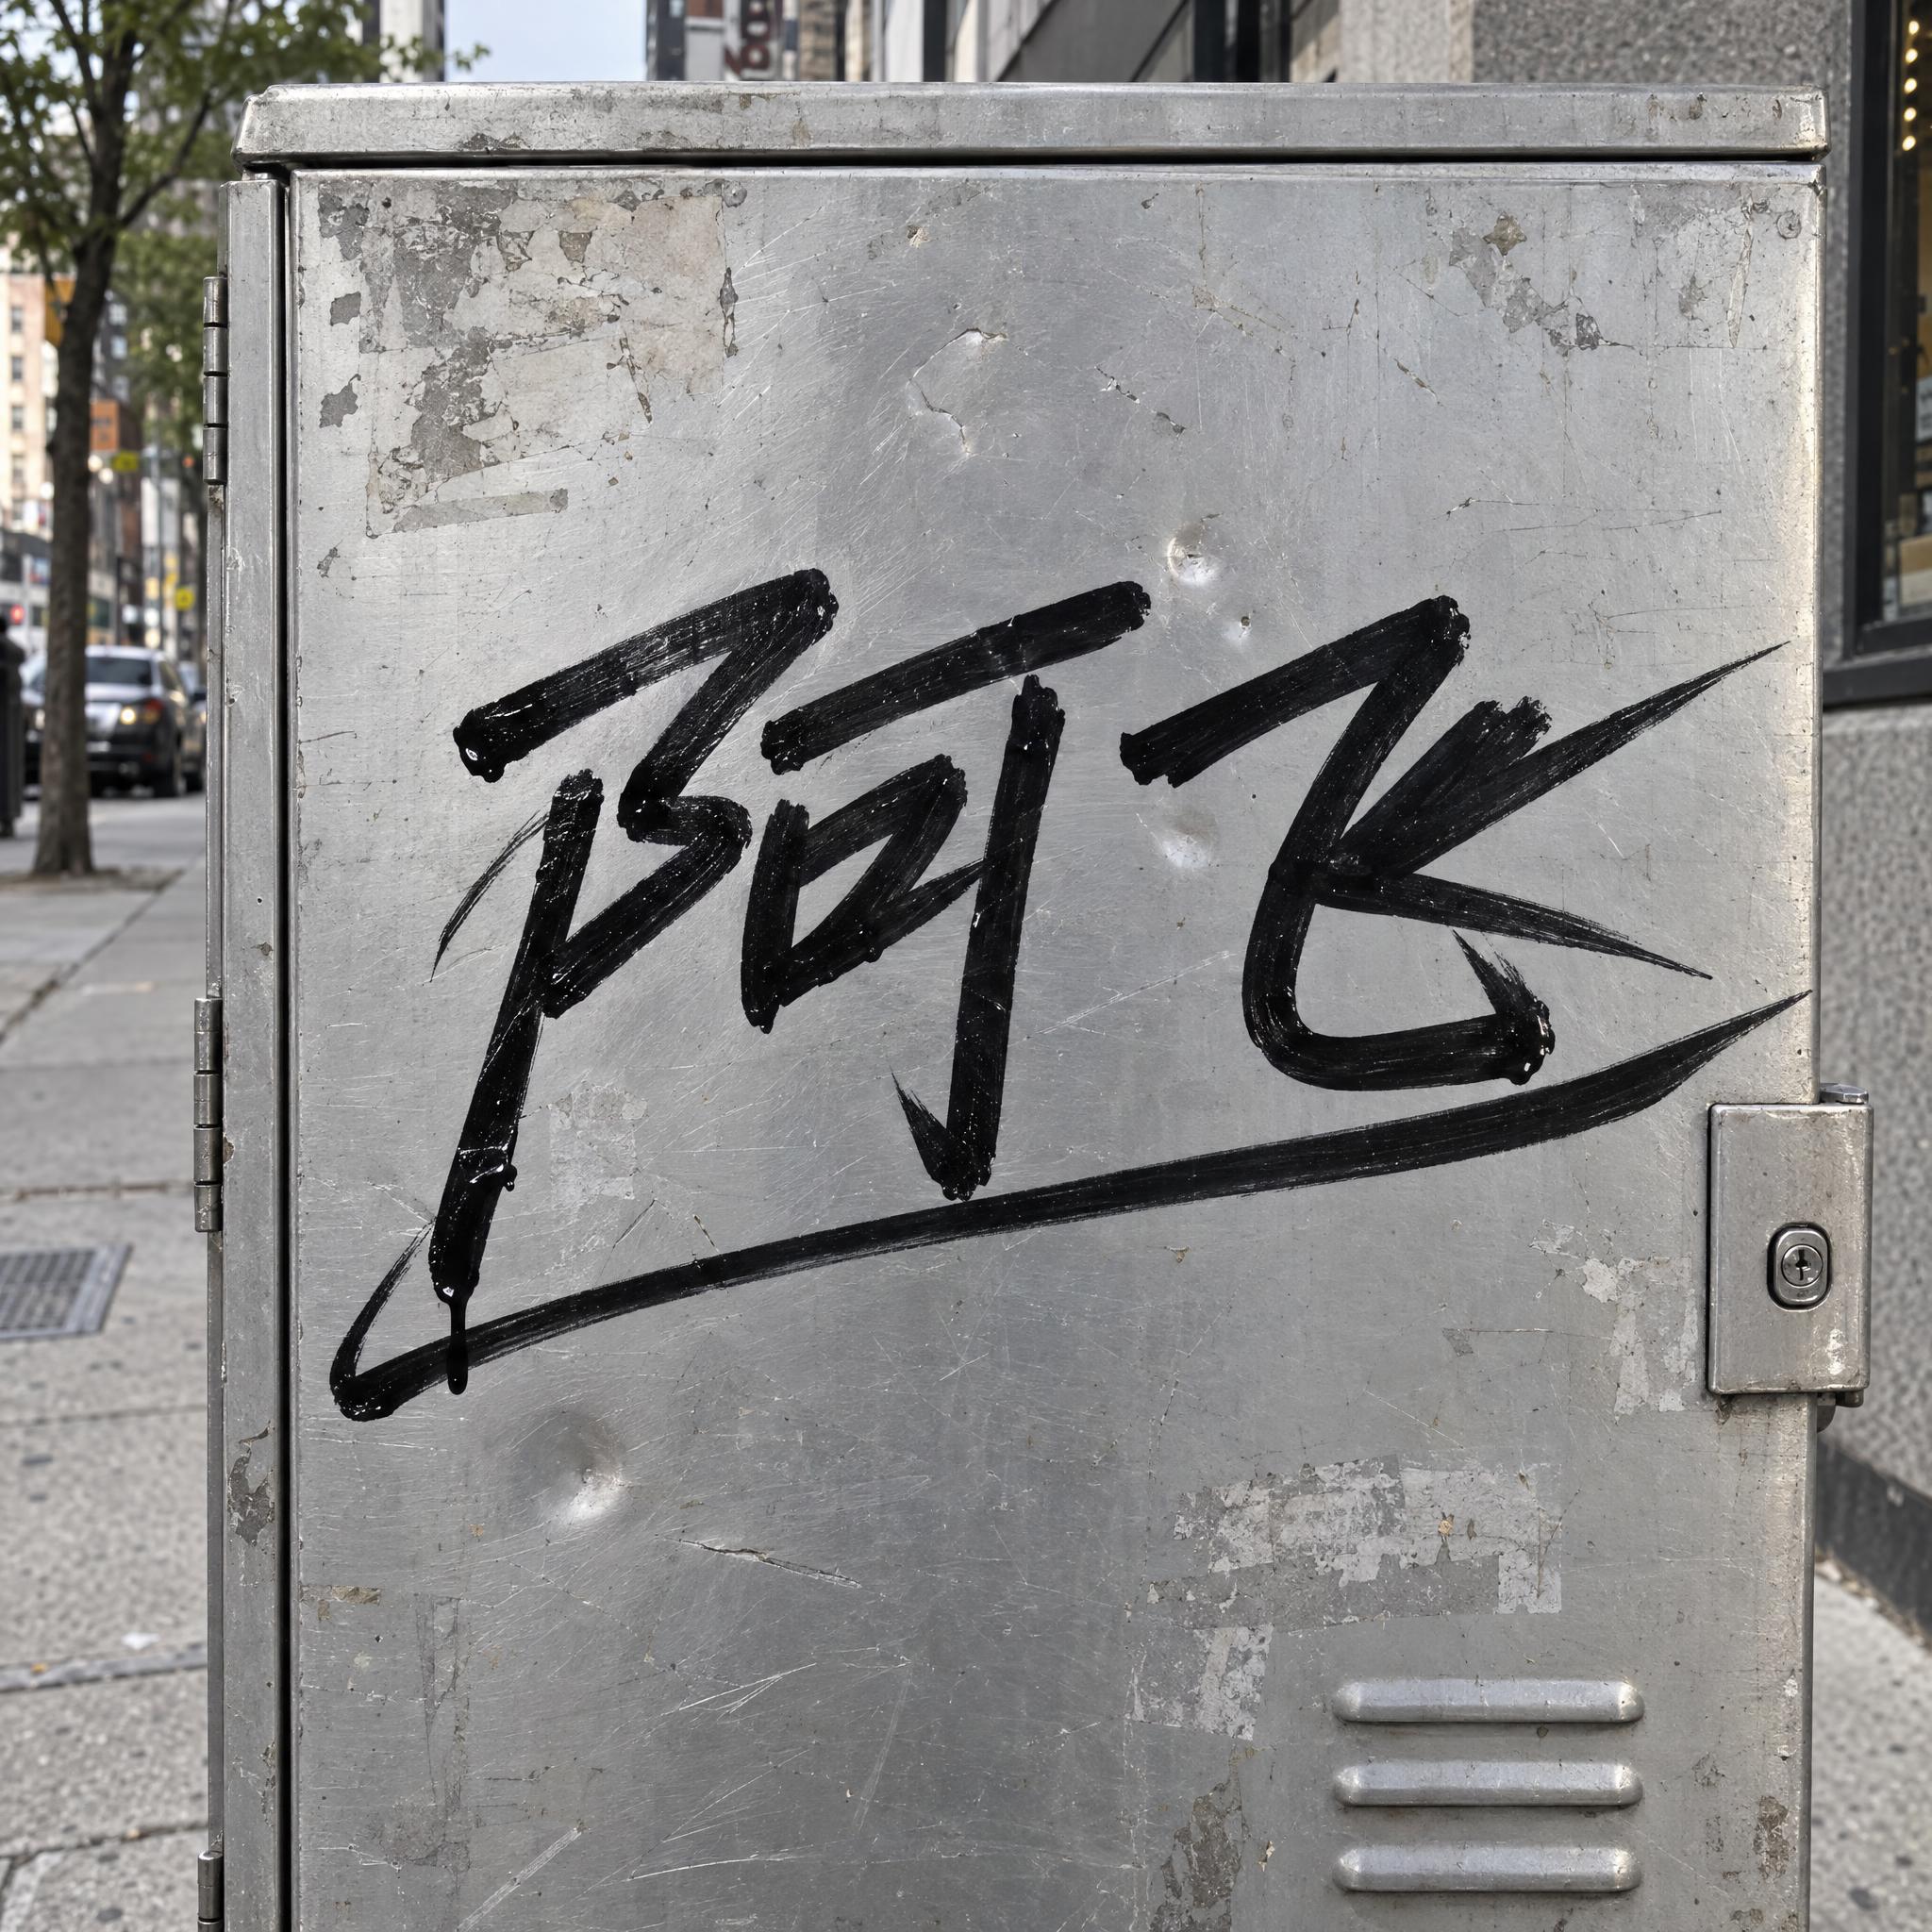
阿拉伯文是这次测试里最难的文字。字母要连写,在词里的位置不同字形就不同,很多字母之间只差点的数量或位置。一条提示词就能看出五家的差距:在街边配电箱上用涂鸦写 نمر(老虎)。
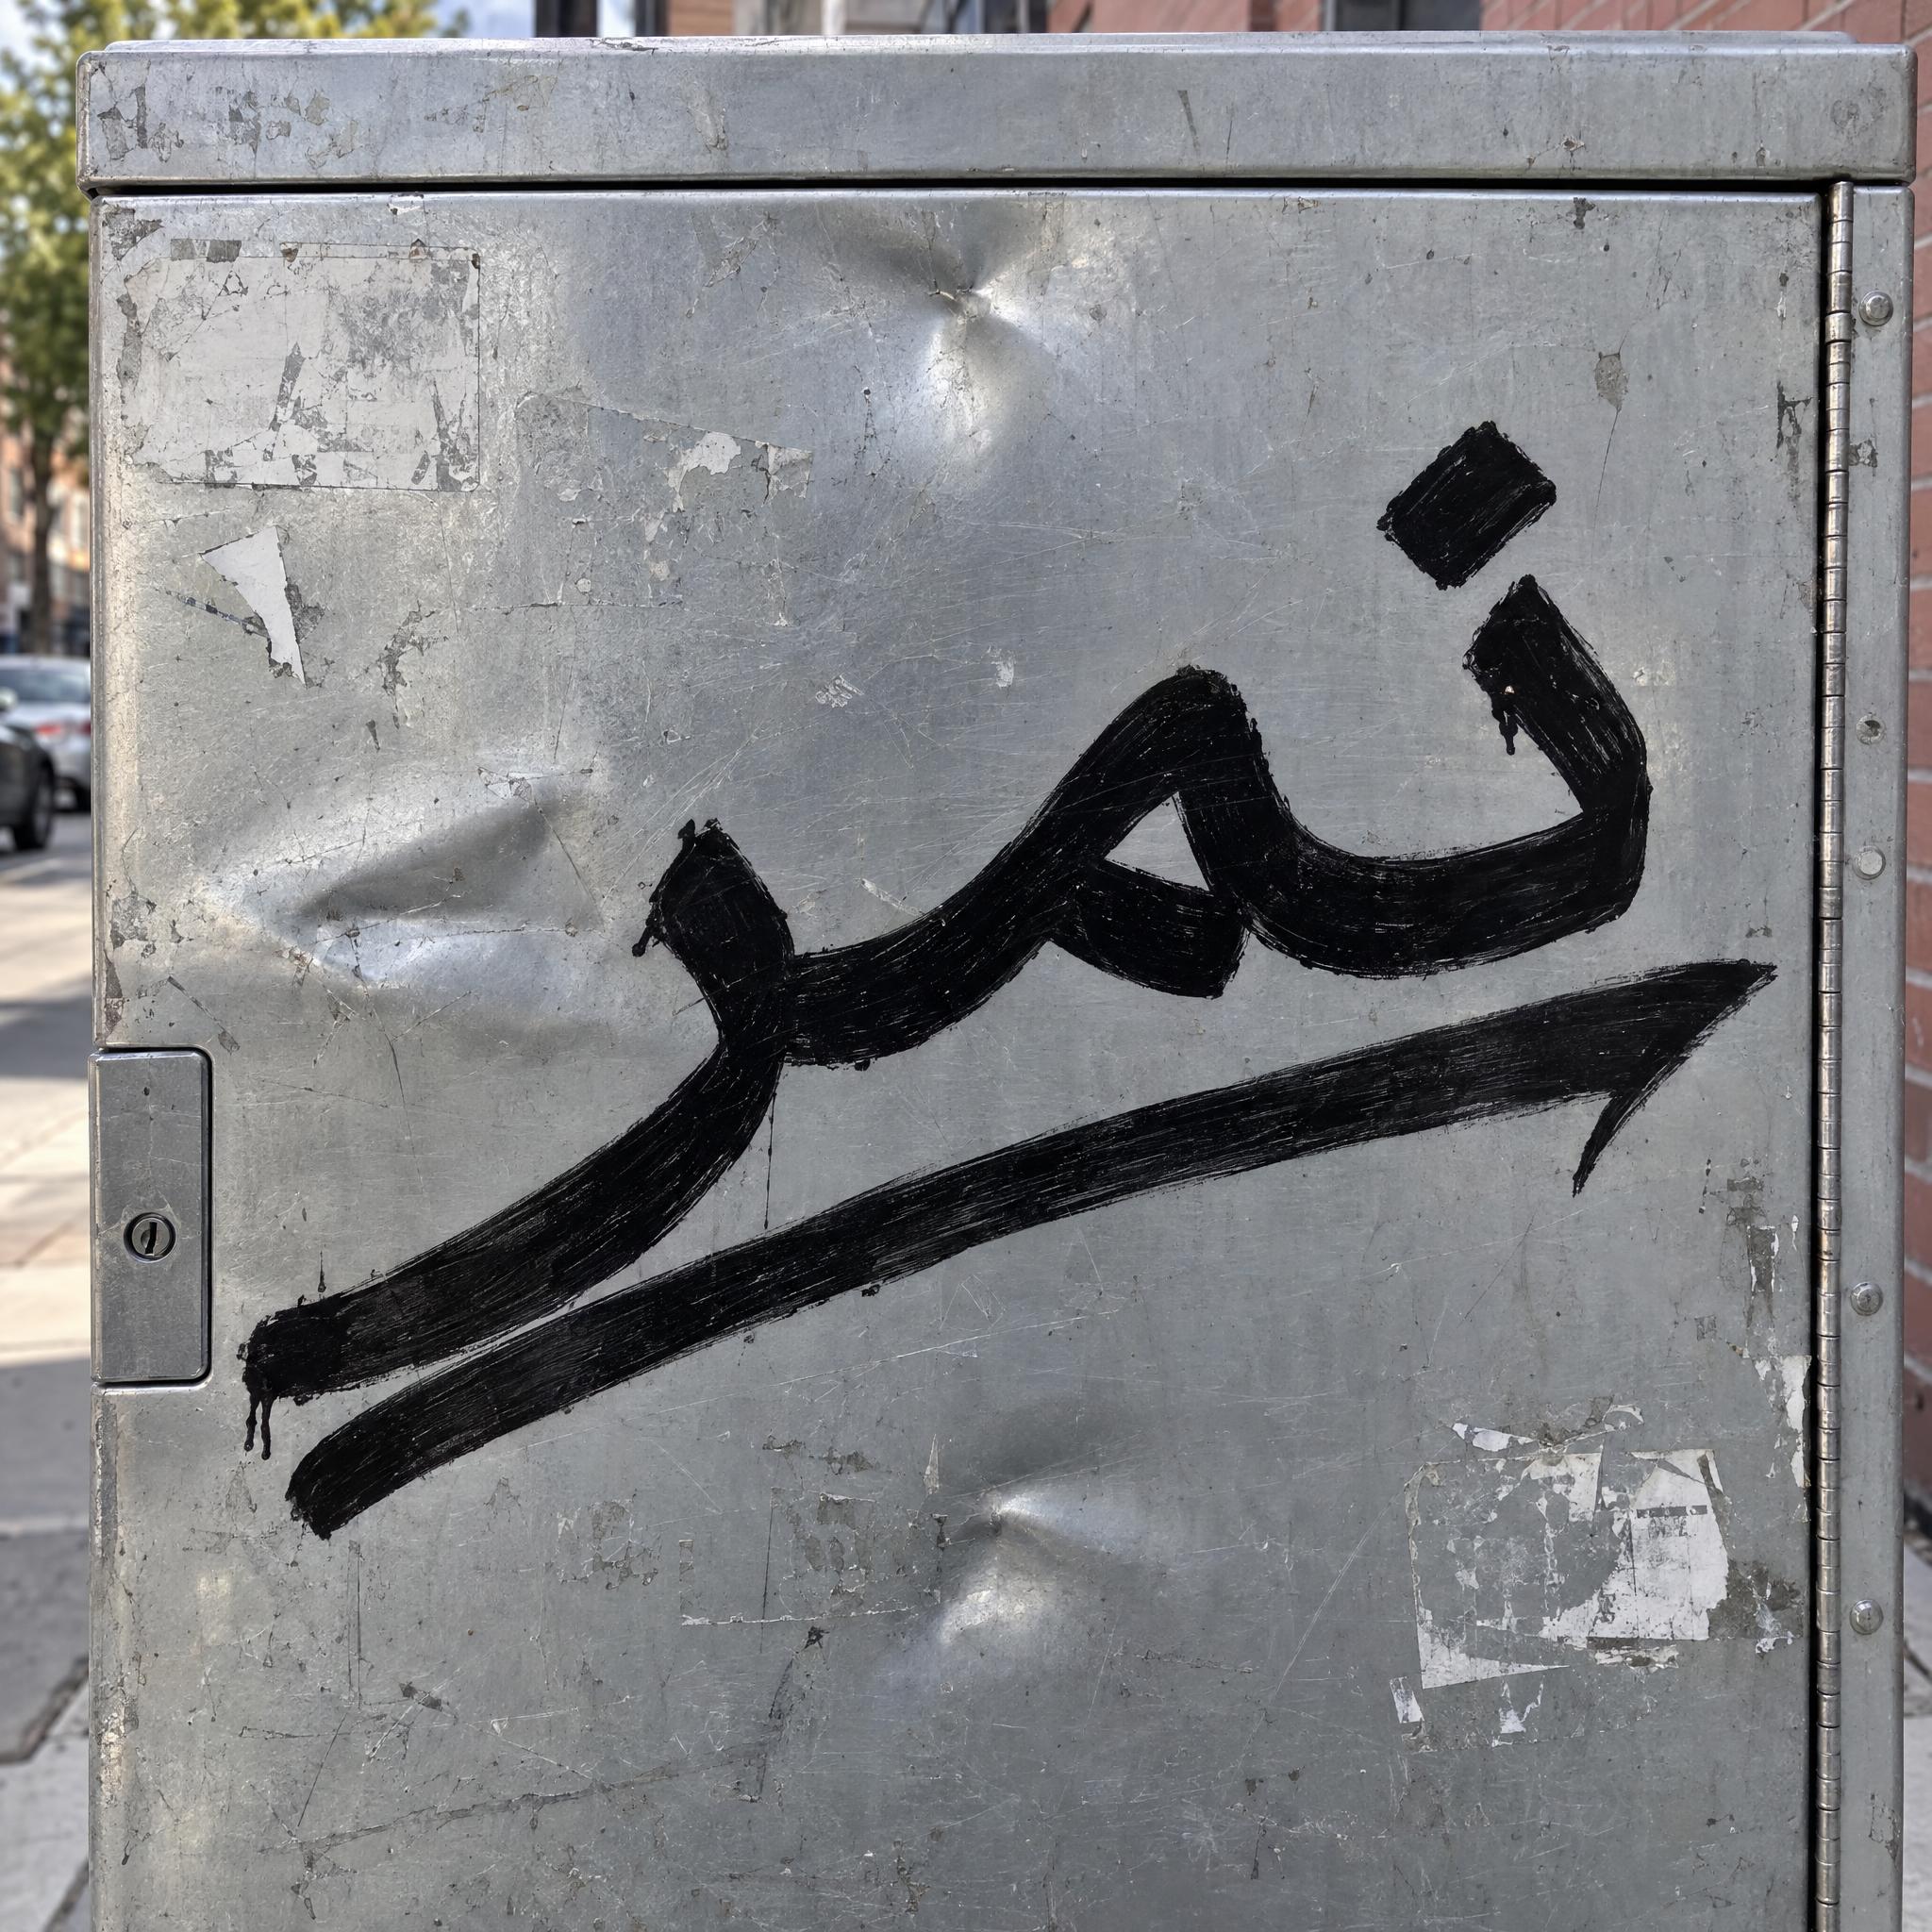
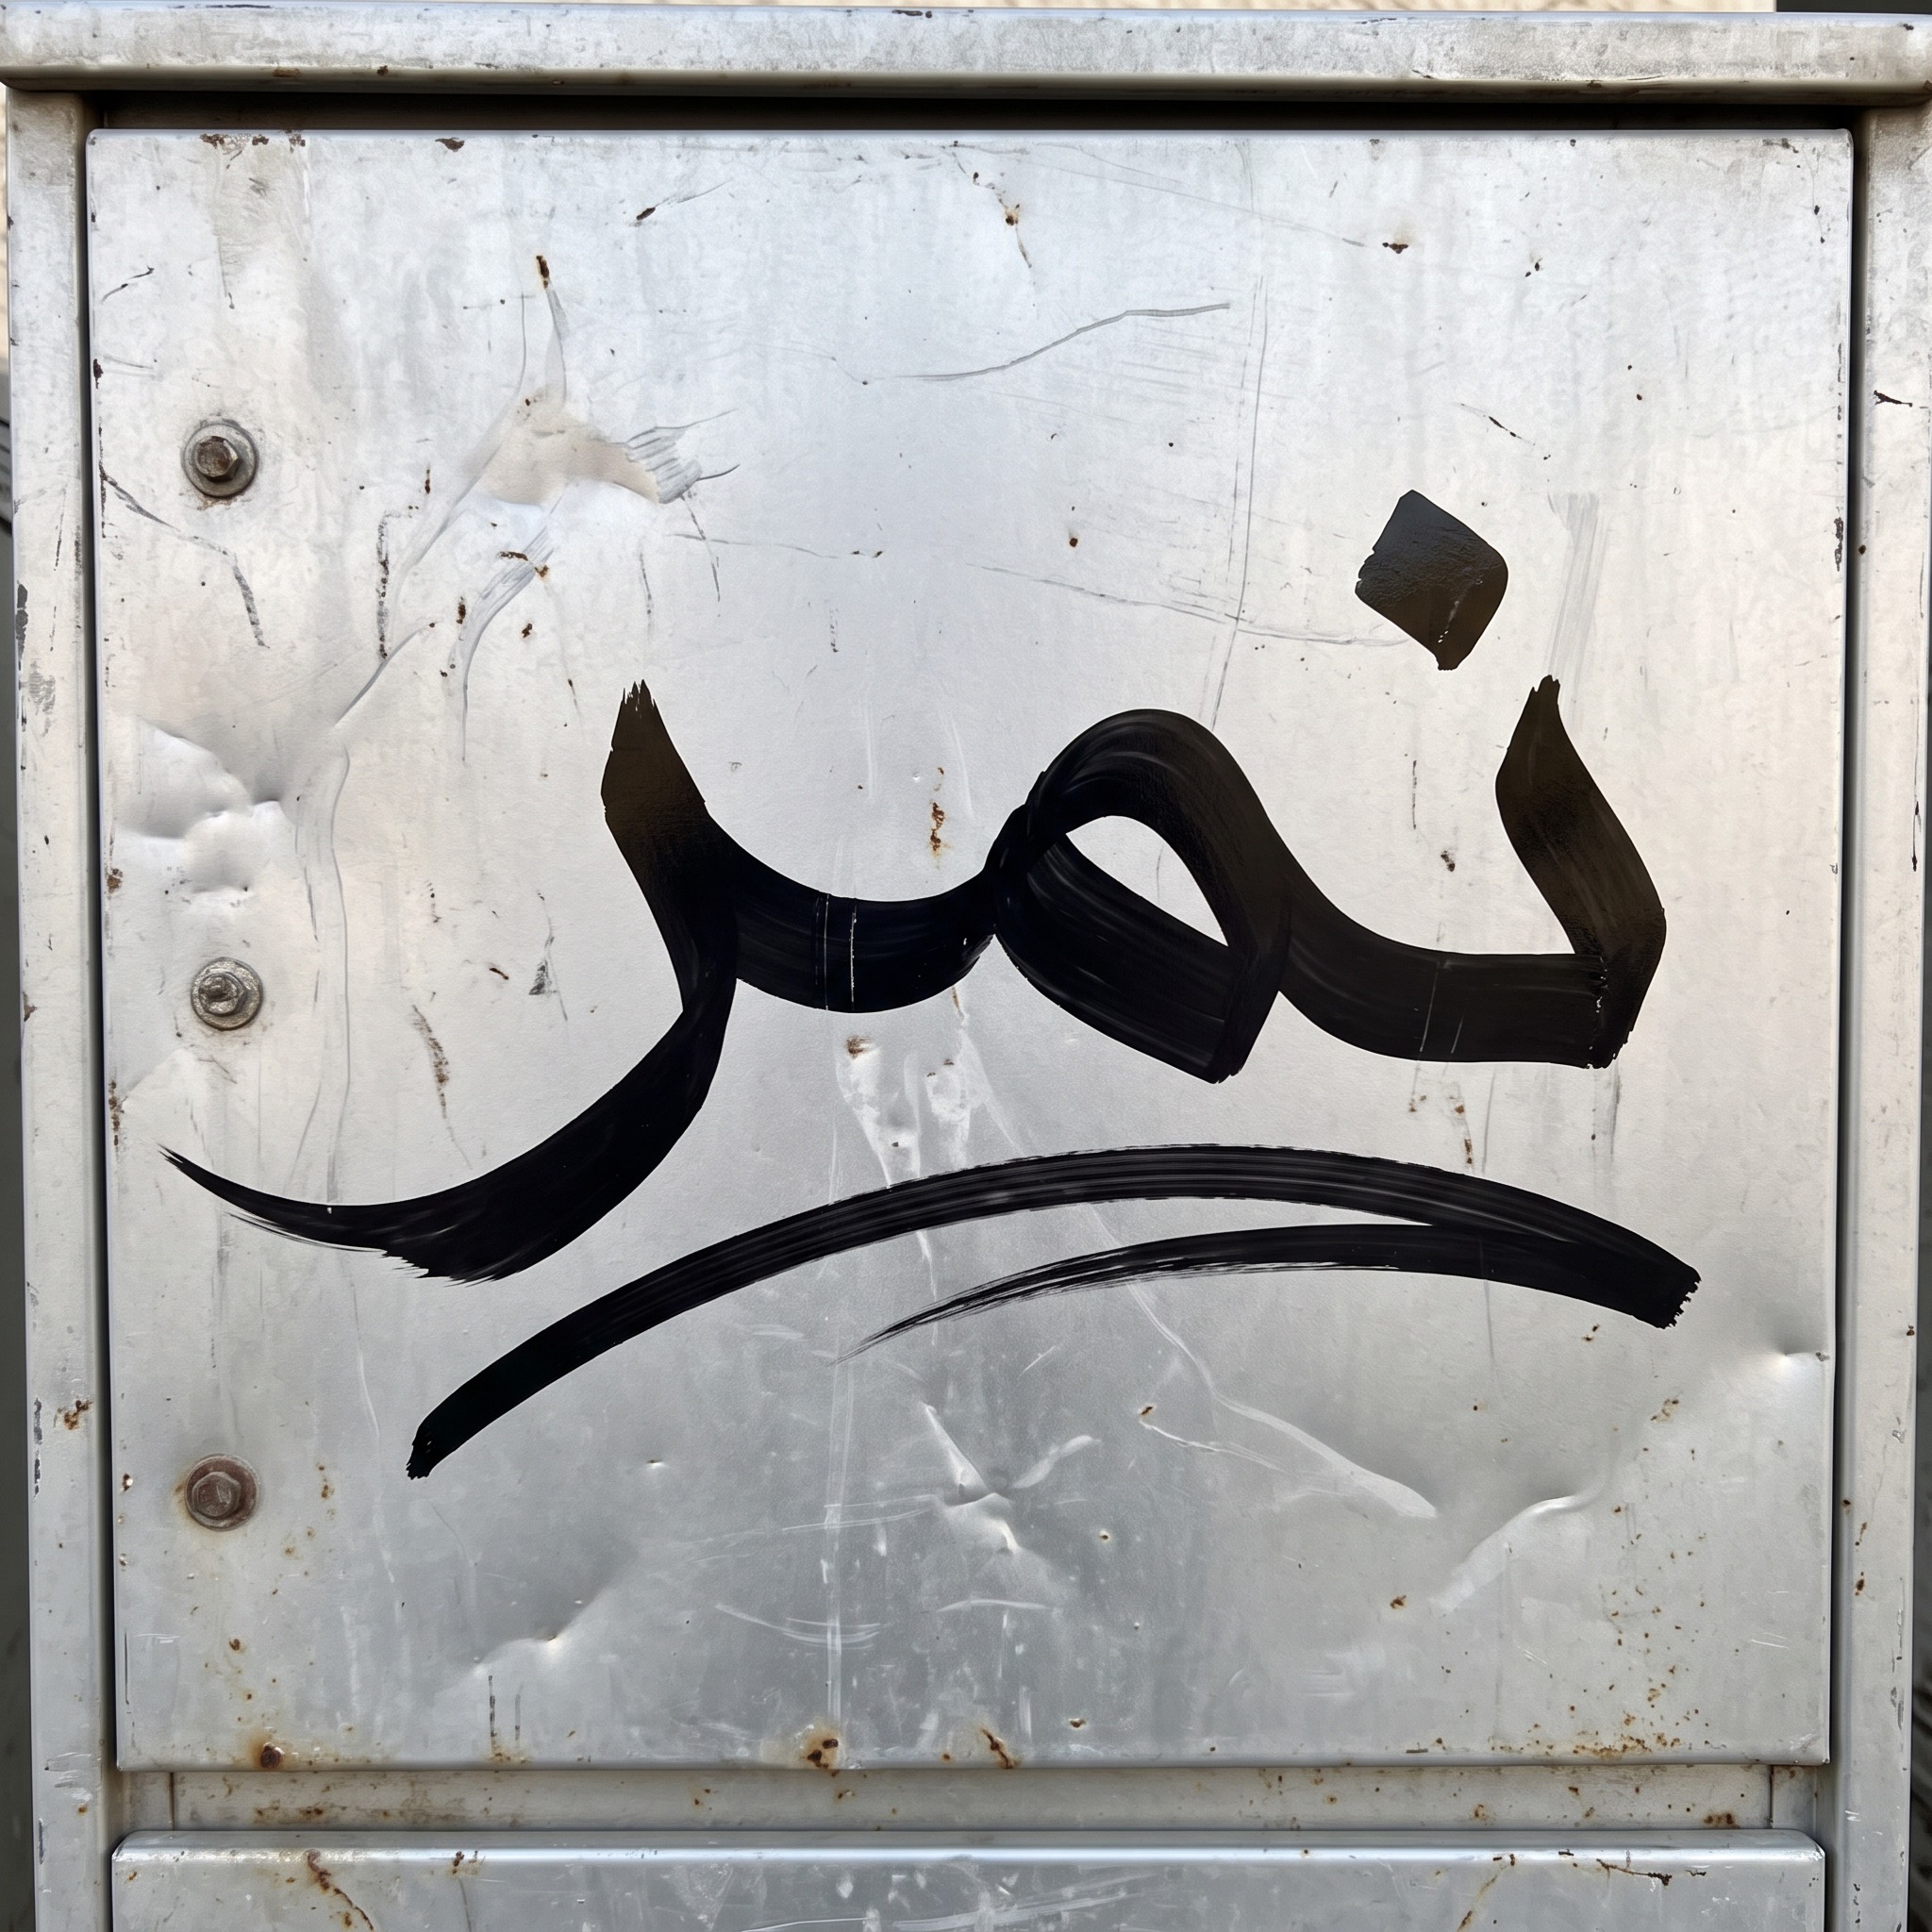
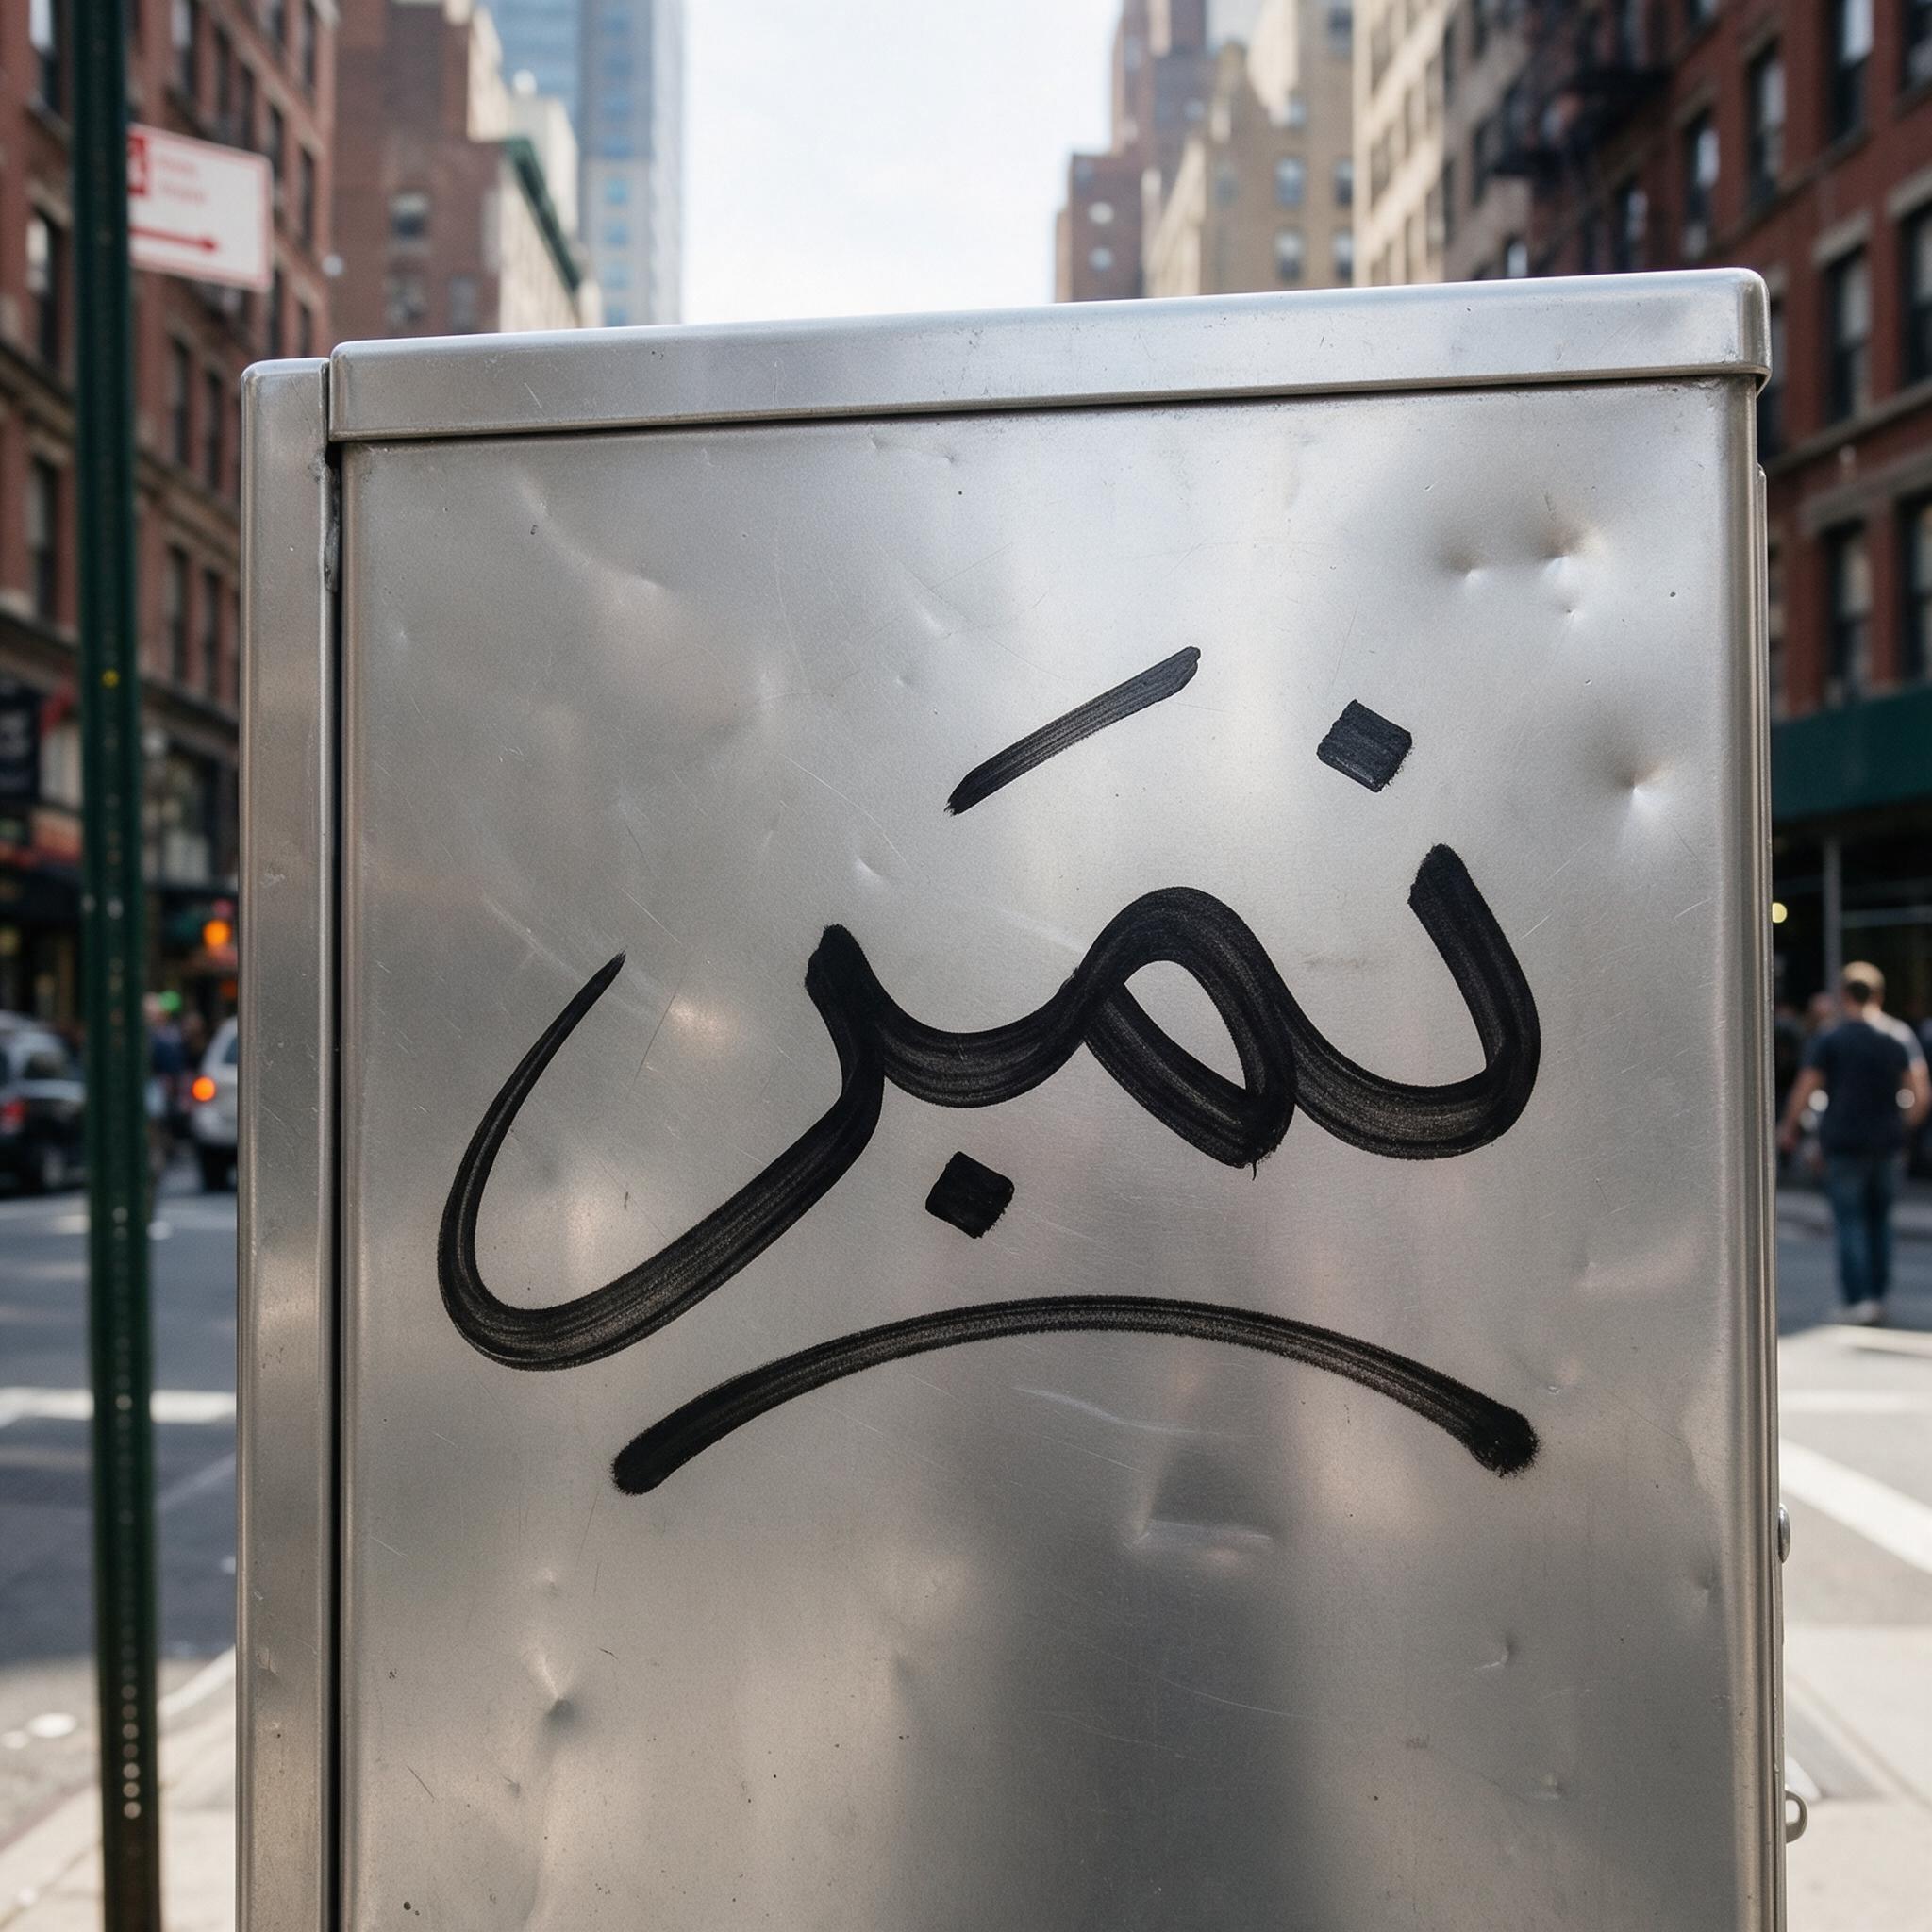
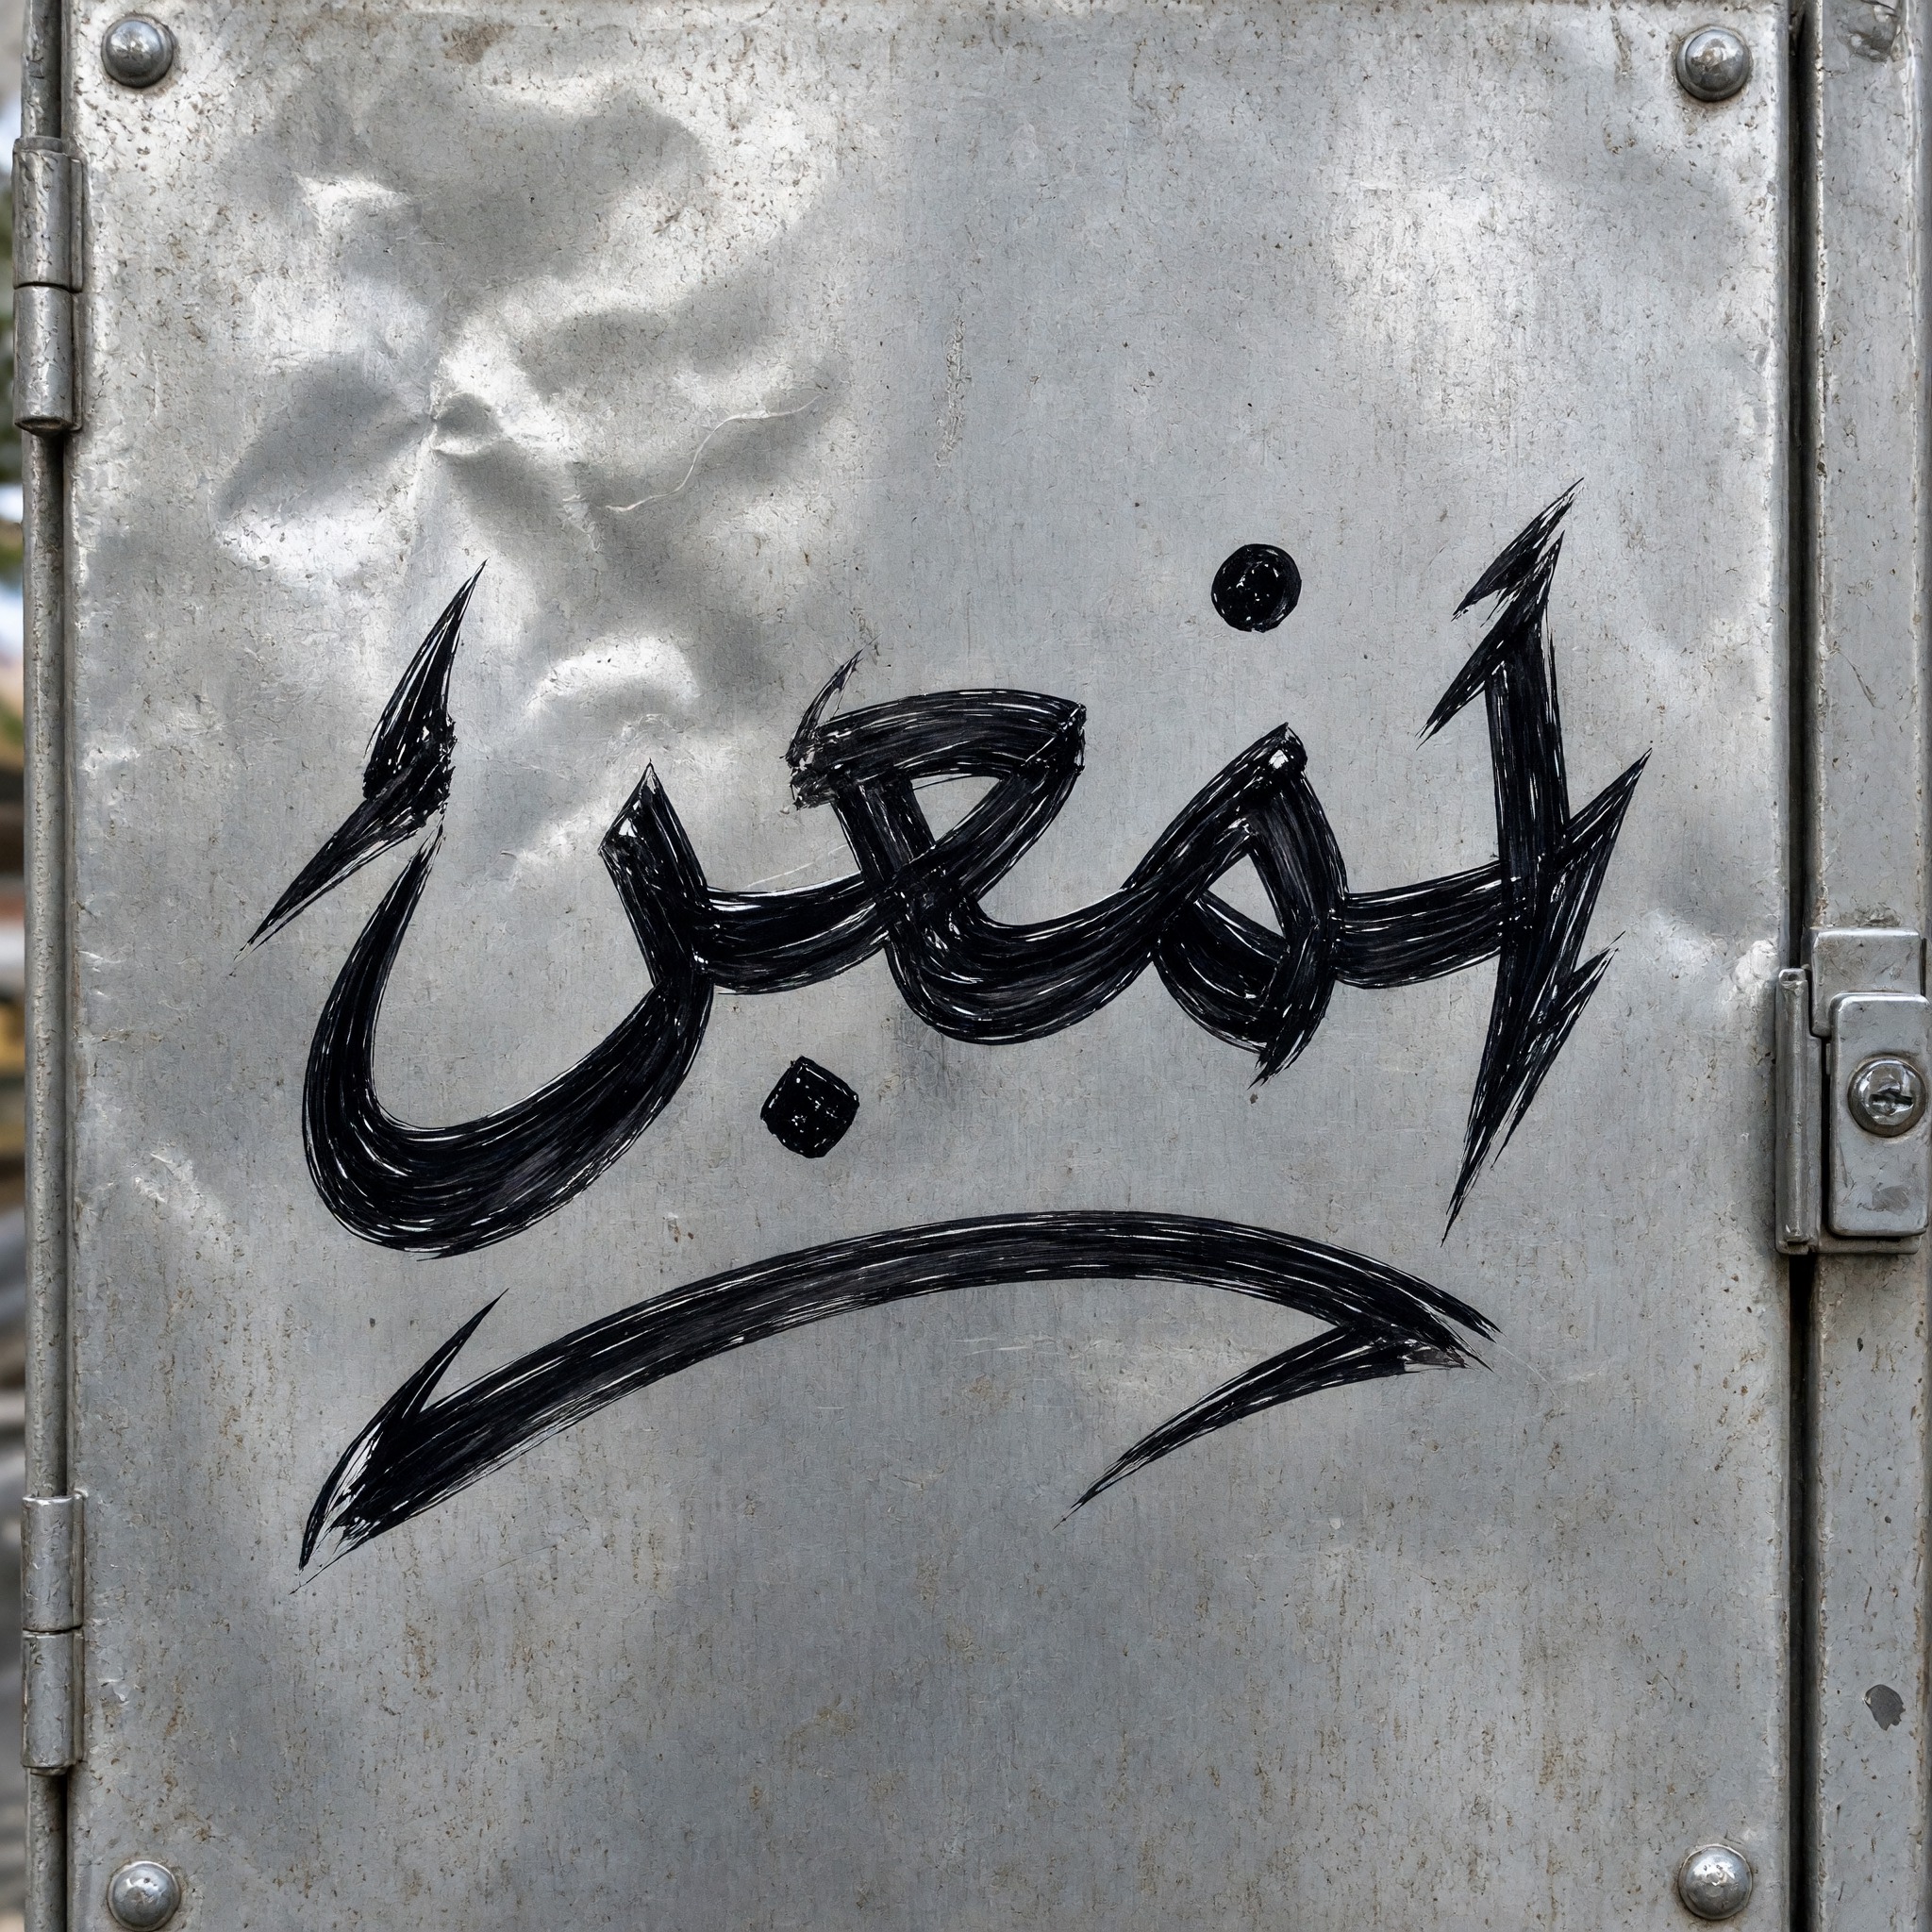
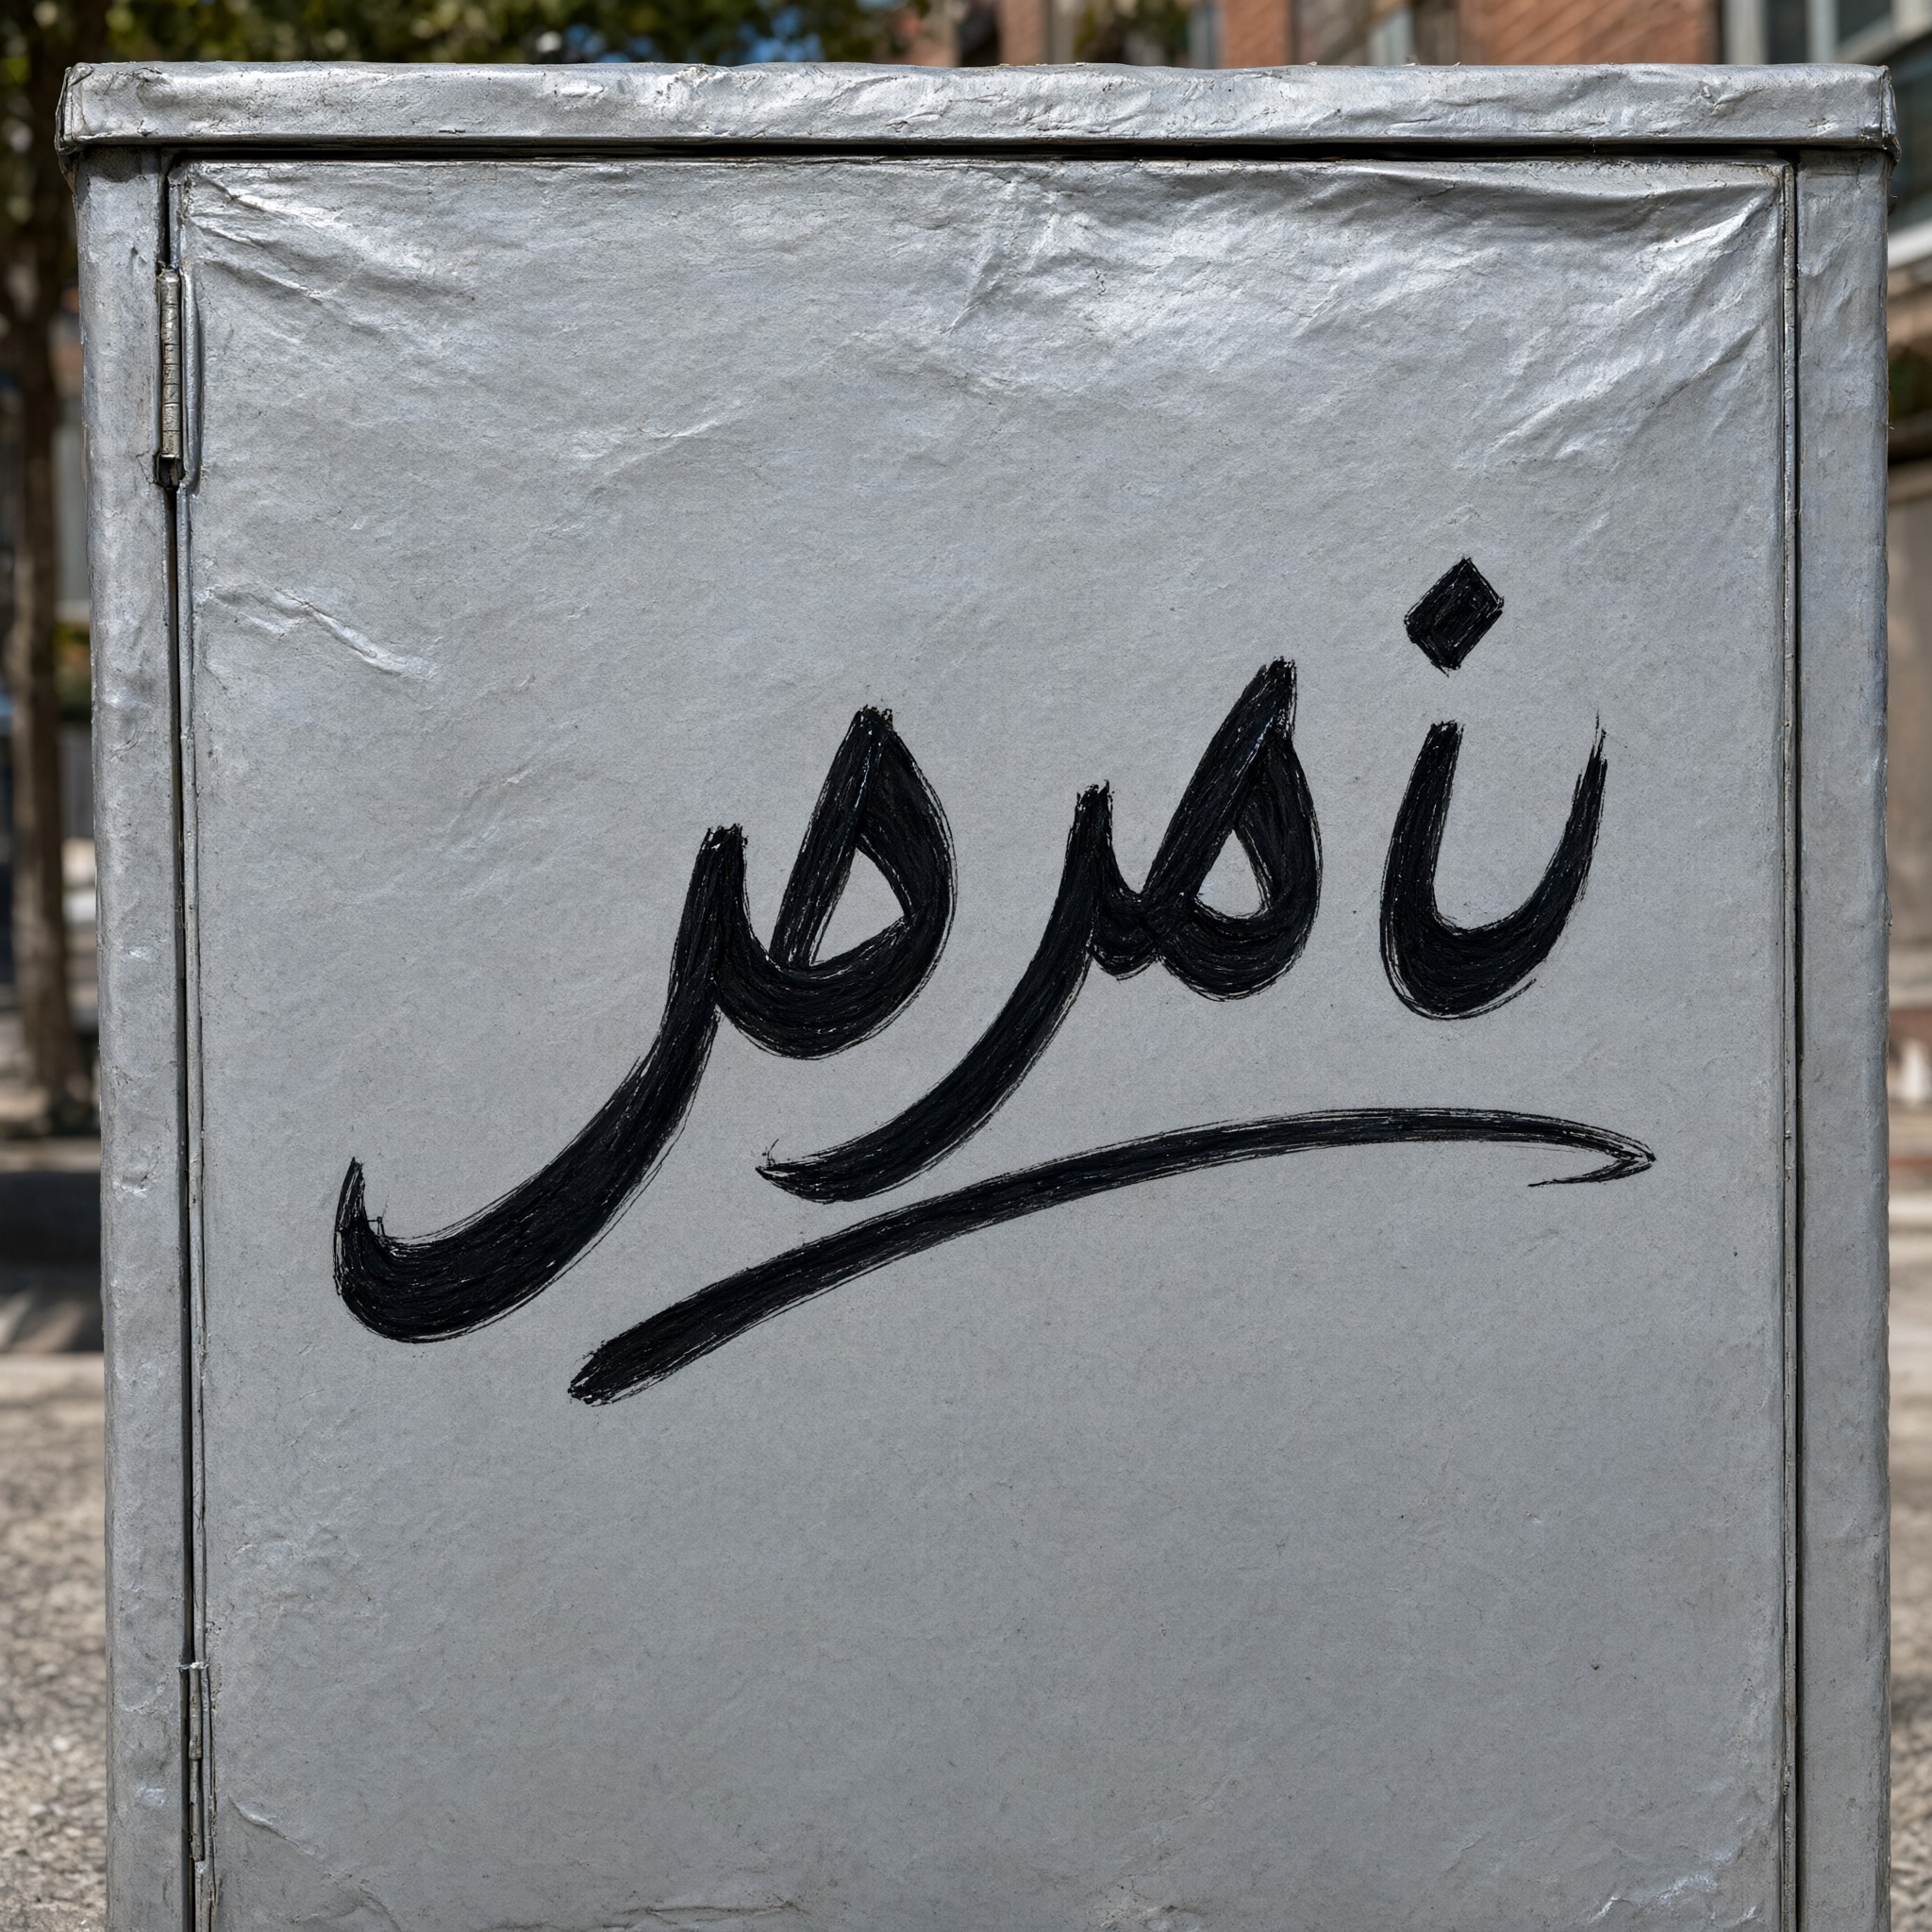
Grok Imagine 和 Seedream 在阿拉伯文上的失分,主要是点和多出来的字母。Grok 的 14 处阿拉伯文错误里,6 处是点少了、多了或位置错了,5 处是多了字母;Seedream 的 20 处里,9 处是点,7 处是多了字母。在姜饼字提示词上,两家都在 كعك 上下撒了圆形小饼干,看起来就成了多出来的点。
Qwen-Image 的阿拉伯文是另一种问题。它很少把要求的词写出来,而是在旁边或干脆代替它写上一行别的阿拉伯字母。
阿拉伯文的数字要打个折扣。 我们的核对人员都不是阿拉伯语母语者,AI 和人工判断不一致的 41 张图没有计入。排名我们有把握,因为 96% 和 11% 的差距远大于任何核对误差;具体百分比会随母语读者给数据集纠错而变动。
第一名也会写错
GPT Image 的三处错误:死亡金属 T 恤上把 VENOM 写成 VENON,还有两个阿拉伯文单词,一个最后一个字母写错(تحية 写成 تحيئ),一个漏了一个字母(فتنة 写成 فتة)。
Nano Banana 的两处:一个日文词里有一个字变了形;还有一张万圣节中文图,要求的「南瓜」两个字写对了,旁边却多了三个小小的「PARTY!」。词本身没错,多出来的字违反了我们的规则。
重跑一次有用吗?
有一部分用,看模型。我们统计了第一张图写错的情况,再看多跑一次能不能写对。
| 第一张写错 | 重跑一次写对 | |
|---|---|---|
| GPT Image | 3 | 1 |
| Nano Banana | 2 | 2 |
| Grok Imagine | 28 | 13 |
| Seedream | 36 | 18 |
| Qwen-Image | 86 | 10 |
Grok Imagine 和 Seedream 错的是细节,一个点或一笔,重跑一次大约一半能写对。Qwen-Image 多画字的毛病重跑也改不掉:86 处只救回 10 处。如果一个模型总是多画字,改提示词比重跑更管用。
写字该用哪个模型?
- 任何语言、只想跑一次: GPT Image 或 Nano Banana,按喜欢的画风挑。写字准不准不是在这两家之间二选一的理由。
- 只写英文或中文: 五家都行。喜欢 Grok Imagine 和 Seedream 的画风也可以用,印出来之前检查一遍。
- 日文: GPT Image 或 Nano Banana。用别家就把每个假名都读一遍,尤其看浊点。
- 阿拉伯文: GPT Image 或 Nano Banana。另外三家写的阿拉伯文,没有母语者看过我们不会拿去用。
- Qwen-Image: 展示词尽量短,检查整张图有没有多出来的字,不只看你要的那个词。
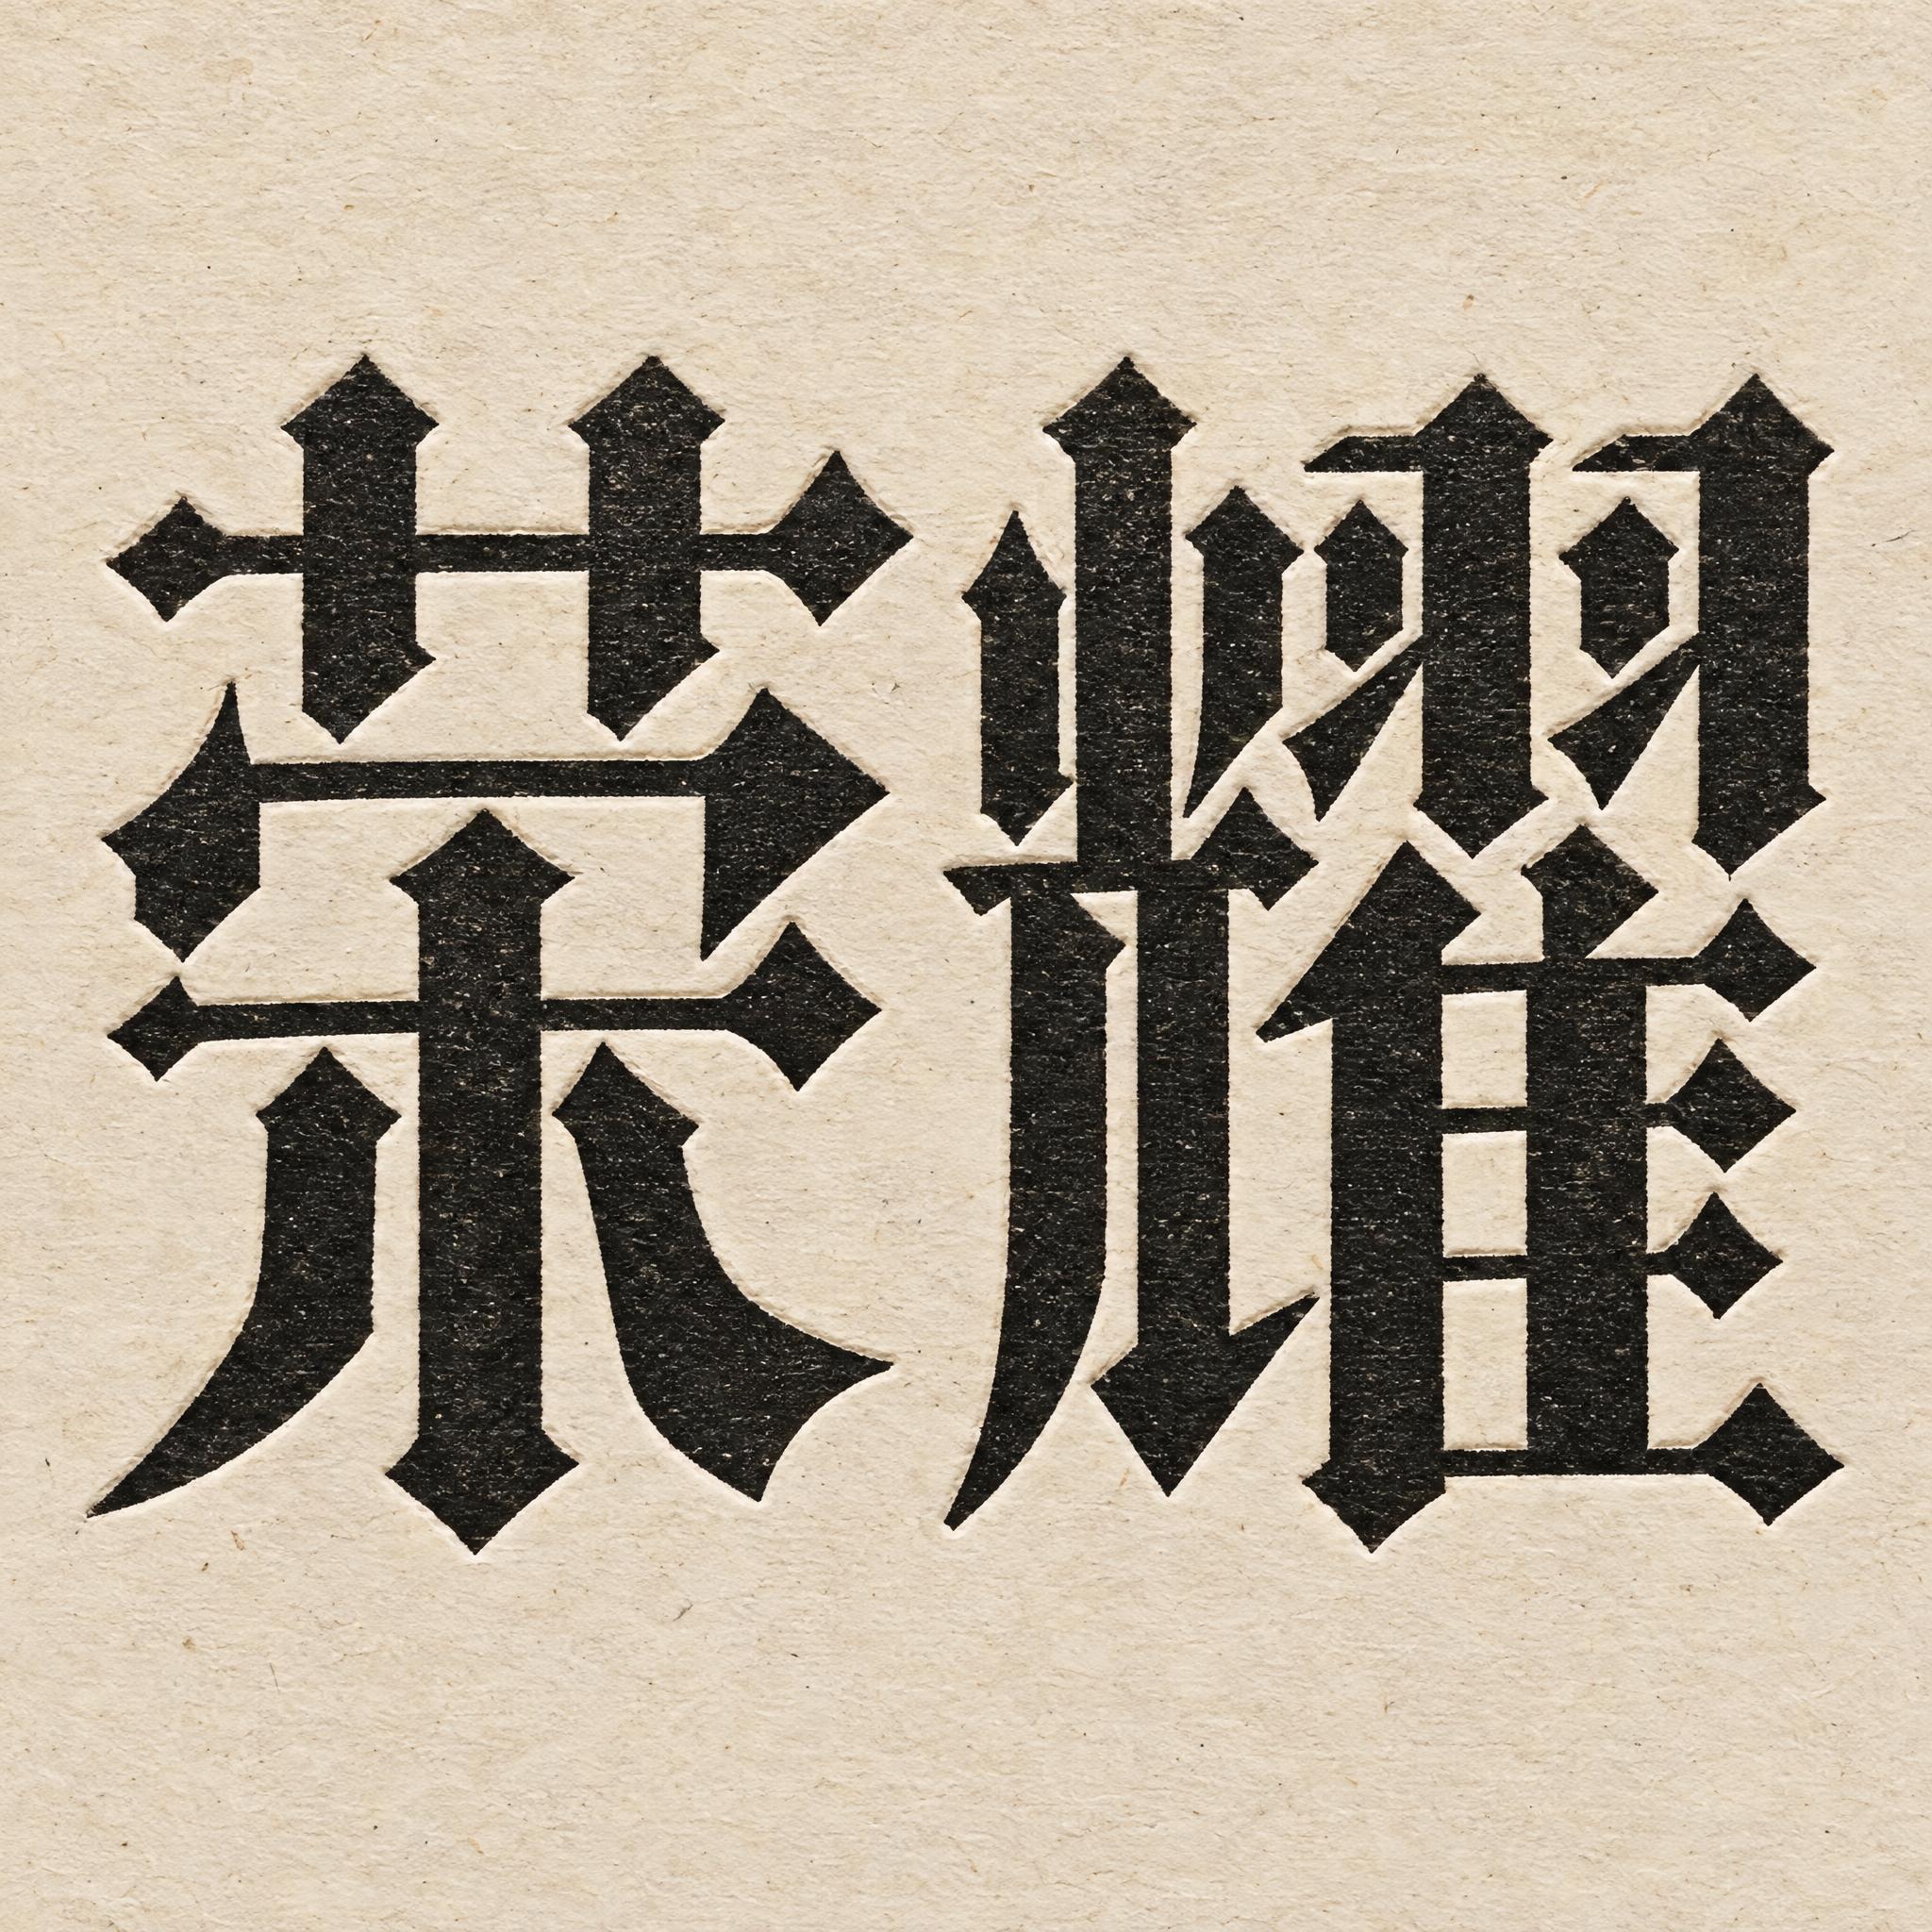
AIFont 每个字体页都放了五家模型在各语言上的出图,复制提示词之前就能看到这款风格写出来是什么样。哥特字体和涂鸦字母合集适合把几家放在一起比。
数据公开
数据集里全部 2,495 张图,连同提示词、判断和核对备注,都以 CC BY 4.0 公开:GitHub 上的 AIFont 文字渲染数据集,并在 Zenodo 存档(DOI 10.5281/zenodo.23815210)。如果你读得懂其中的阿拉伯文、日文或别的语言,发现判断有错,欢迎提 issue。纠错会进下一个版本,也会更新这张表。
上新风格、新语言或模型更新后,我们会重新跑一遍这份对比。
常见问题
2026 年写字最准的 AI 生图模型是哪个?
我们实测的 2,016 张图里,GPT Image 2.5 和 Nano Banana 2.1 并列第一,分别写对了 404 个词里的 401 个和 402 个。两家只差一张图,算打平。两家在测过的每种文字上准确率都在 95% 以上,阿拉伯文也一样。
写日文或阿拉伯文,用哪个 AI 生图模型最好?
GPT Image 和 Nano Banana。日文 59 个词它们写对 58 到 59 个,另外三家是 45 到 52 个。阿拉伯文它们是 96% 和 100%,Grok Imagine 71%、Seedream 57%、Qwen-Image 11%。
Qwen-Image 为什么经常把字写错?
主要是画出了没人要的字。它 86 次出错里有 40 次是要求的词写对了,旁边却又画了一整段多余的字,常常是把提示词本身打乱了写进图里。同一条提示词重跑一次,这个毛病也很少能消失。
测试数据公开吗?
公开。每张图、每条提示词、每个判断和核对备注都在 AIFont 文字渲染数据集里,放在 GitHub 和 Zenodo 上,许可 CC BY 4.0,任何人都可以提交纠错。