Melhor modelo de IA para imagens com texto (2026)
Demos os mesmos 59 prompts em 7 idiomas a 5 modelos de IA. GPT Image e Nano Banana acertaram 99% da escrita. Qwen-Image, 79%.
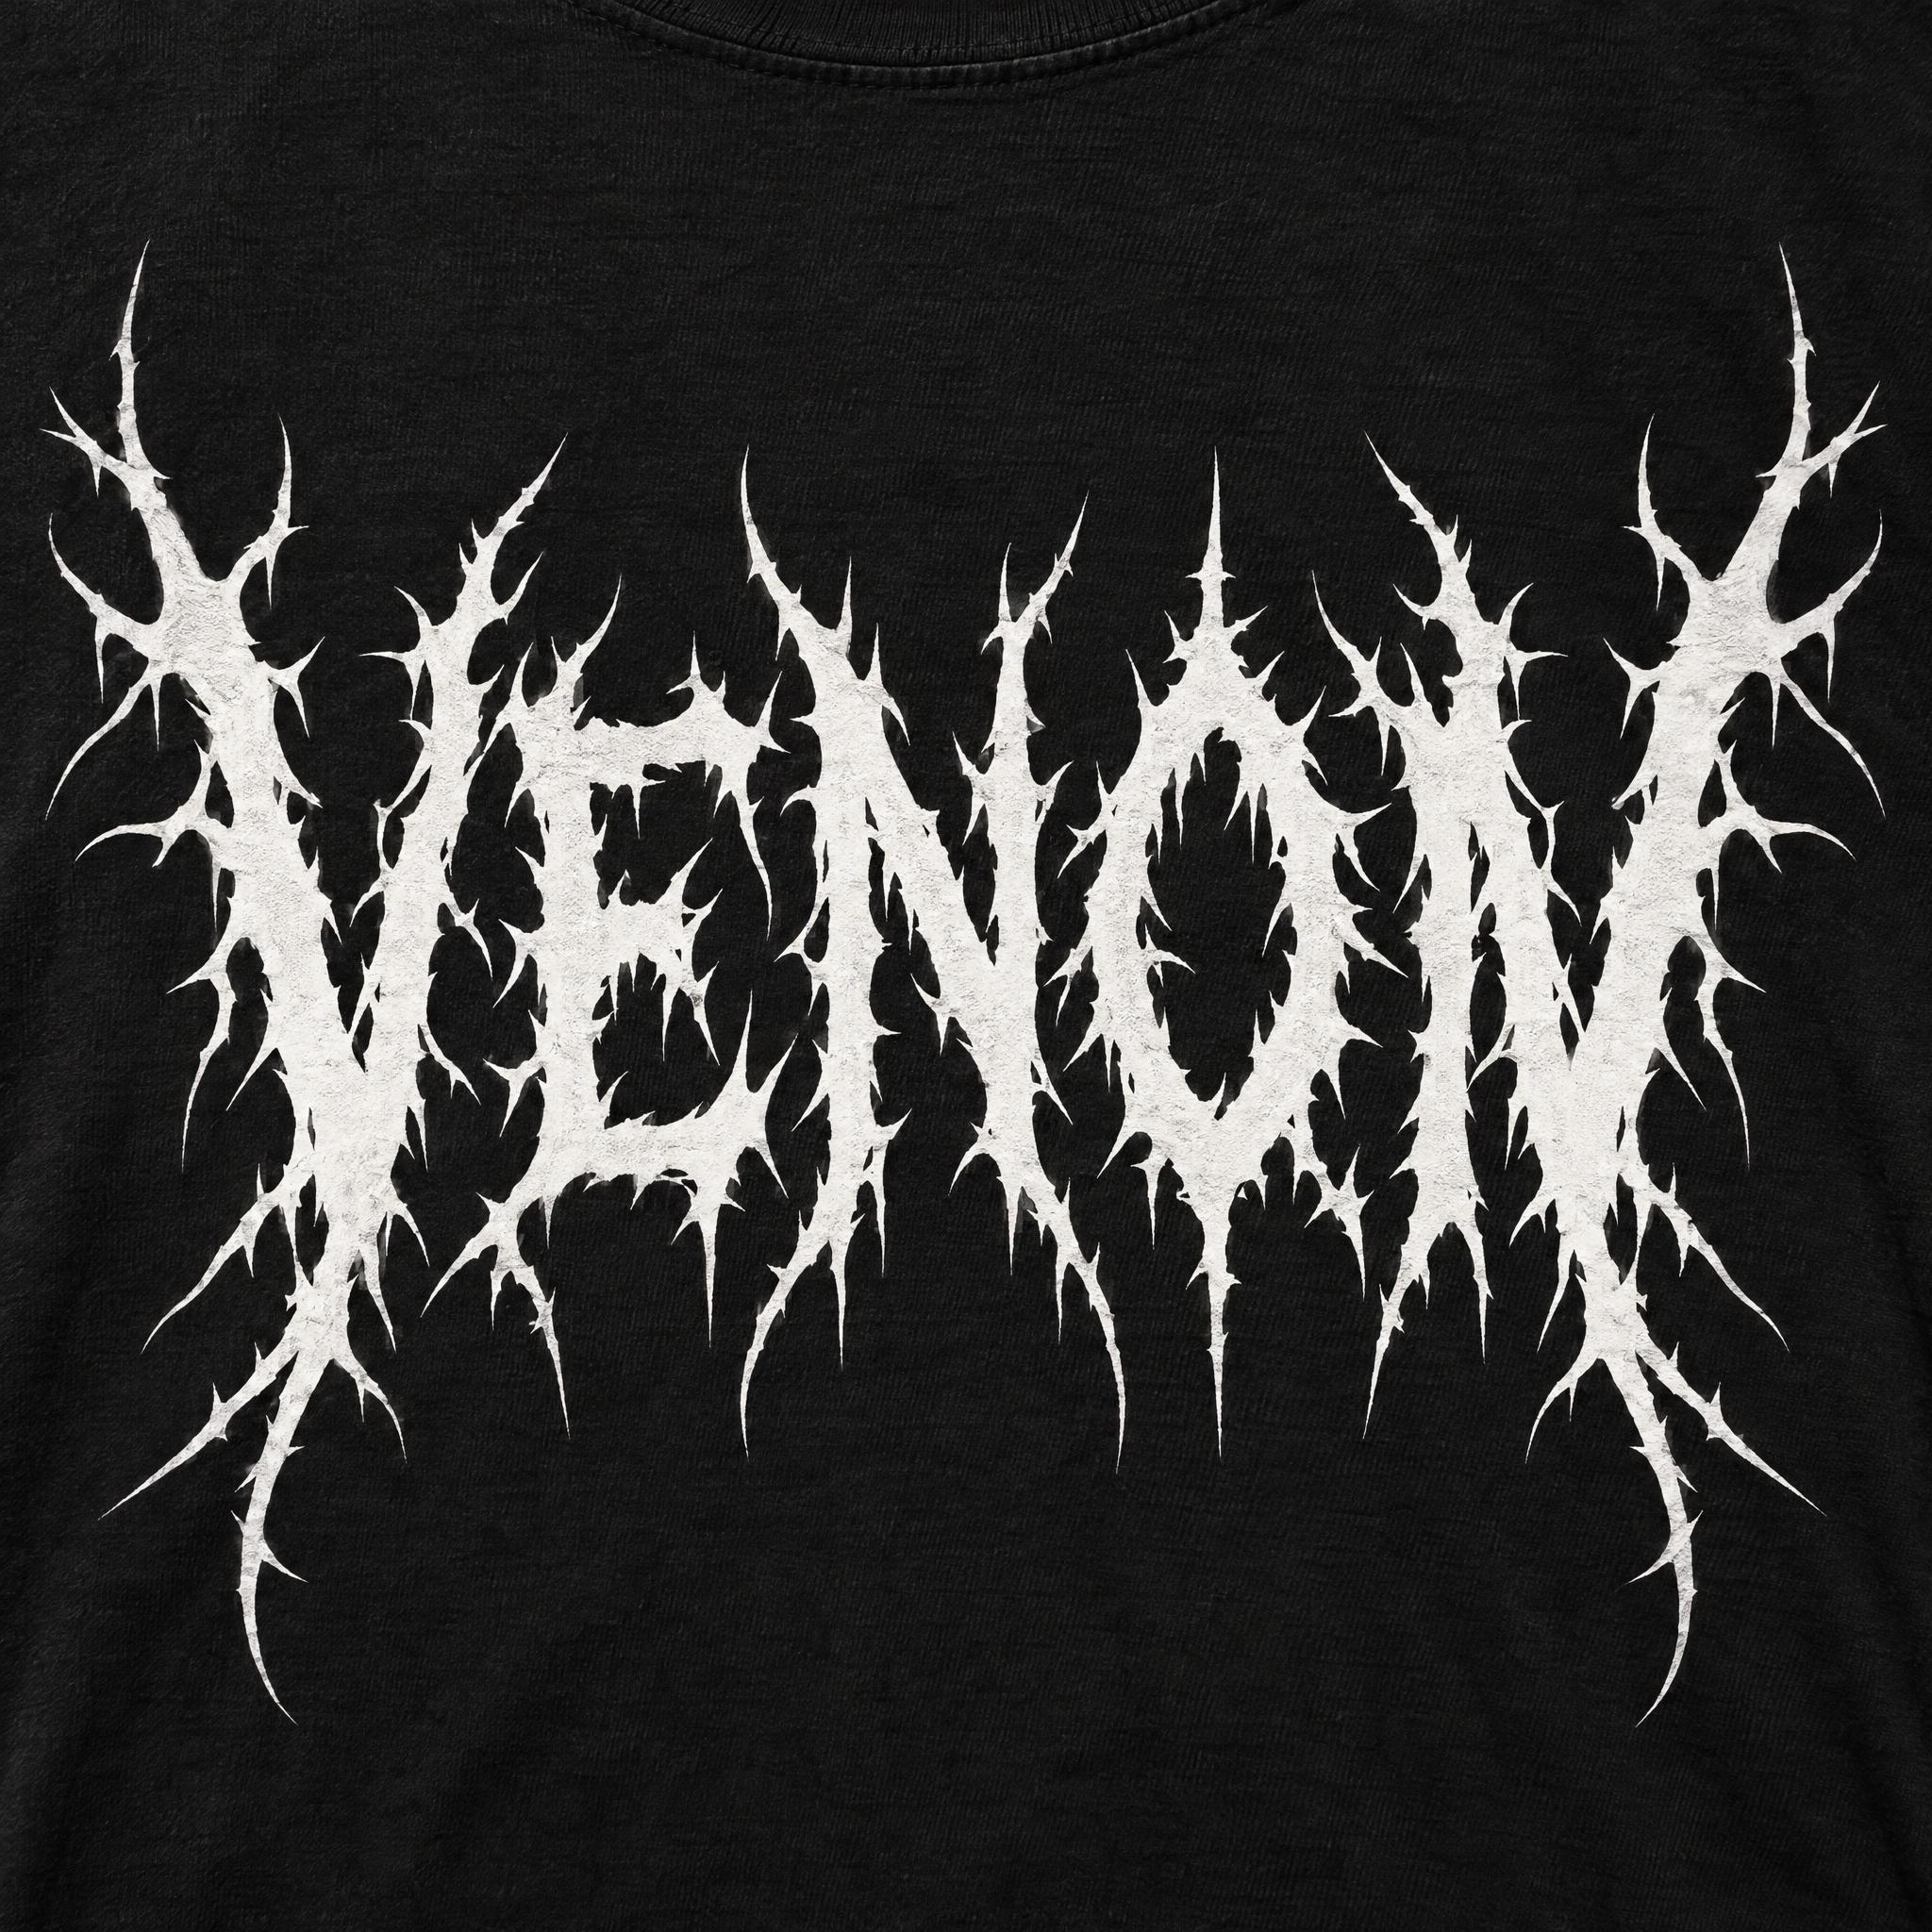
Peça a um modelo de IA uma camiseta de death metal escrita VENOM, e o melhor modelo de IA para gerar imagens com texto que testamos imprimiu VENON. Foi um dos três únicos erros de grafia do GPT Image em 404 imagens. O Qwen-Image cometeu 86.
É no texto que os modelos de geração de imagem ainda se diferenciam. Um modelo consegue renderizar cromado, tinta escorrendo e iluminação de estúdio que passam por foto, e mesmo assim colocar um ponto no lugar errado e transformar uma palavra em outra. Nosso trabalho é criar prompts de fontes com IA, então cada prompt que publicamos roda em cinco modelos e cada imagem é conferida letra por letra. Depois de 59 estilos, essa conferência virou a comparação abaixo.
A resposta curta
| Escrita | GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image |
|---|---|---|---|---|---|
| Latina (inglês, alemão, espanhol, português) | 235/236 | 235/235 | 229/235 | 230/235 | 213/235 |
| Chinês | 59/59 | 58/59 | 58/59 | 56/59 | 56/59 |
| Japonês | 59/59 | 58/59 | 52/59 | 51/59 | 45/59 |
| Árabe | 48/50 | 51/51 | 35/49 | 27/47 | 6/53 |
| Total | 99% | 100% | 93% | 91% | 79% |
- GPT Image 2.5 e Nano Banana 2.1 são os melhores modelos de geração de imagem para texto. Dois ou três erros cada um em cerca de 400 imagens, em todos os sistemas de escrita.
- Grok Imagine 2.0 e Seedream 5.0 Pro dão conta do alfabeto latino e do chinês, começam a errar no japonês e desandam no árabe.
- Qwen-Image 3.0 Pro é o único modelo que perde pontos em palavras simples do alfabeto inglês, e acertou 6 de 53 em árabe.
Como testamos
Cada um dos 59 estilos é um prompt publicado da AIFont, como Textura, Paint Splatter ou Tagging Letters. Cada estilo tem um prompt por idioma, com uma palavra curta de destaque naquele idioma: FRESH, Reino, ばくはつ, كعك.
- O mesmo prompt para todos os modelos. Para cada estilo e idioma, todos os modelos receberam exatamente o mesmo texto de prompt. Contamos só a primeira imagem que cada modelo devolveu, sem escolher a melhor entre várias tentativas.
- Configurações: 2K, formato quadrado, pela API de cada fornecedor, de 22 a 29 de outubro de 2026. O GPT Image rodou na qualidade xhigh e o Grok Imagine em medium, a mais alta dele; os outros três não têm ajuste de qualidade.
- Modelos: GPT Image 2.5 (OpenAI), Nano Banana 2.1 (Google), Grok Imagine Image 2.0 (xAI), Seedream 5.0 Pro (ByteDance), Qwen-Image 3.0 Pro (Alibaba).
- Avaliação: cada imagem foi lida por um revisor de IA, com zoom no chinês, no japonês e no árabe. 489 das imagens pontuadas também passaram por uma pessoa: todas as que a IA marcou como erradas ou duvidosas, a maior parte do conjunto em árabe e uma amostra aleatória do restante.
- O que conta como erro: uma palavra só está errada se dá para dizer o que ela lê no lugar (VENON, não VENOM). Letras estilizadas, traços decorativos e diferenças de maiúsculas e minúsculas contam como certo. Palavras extras que o prompt não pediu contam como erro.
Isso deu 2.057 imagens de primeira tentativa. 41 imagens em árabe ficaram de fora porque a IA e o revisor humano discordaram e nenhum dos dois é falante nativo de árabe, o que deixou 2.016 imagens pontuadas.
Alfabeto latino e chinês: os cinco modelos passam
Todos os modelos passaram de 90% em inglês, alemão, espanhol, português e chinês. Se o seu texto é curto e está em um desses idiomas, qualquer um dos cinco costuma acertar na primeira tentativa.
A única exceção é o Qwen-Image em espanhol e português, onde errou de 9 a 10 palavras por idioma. O erro típico dele não é de grafia.
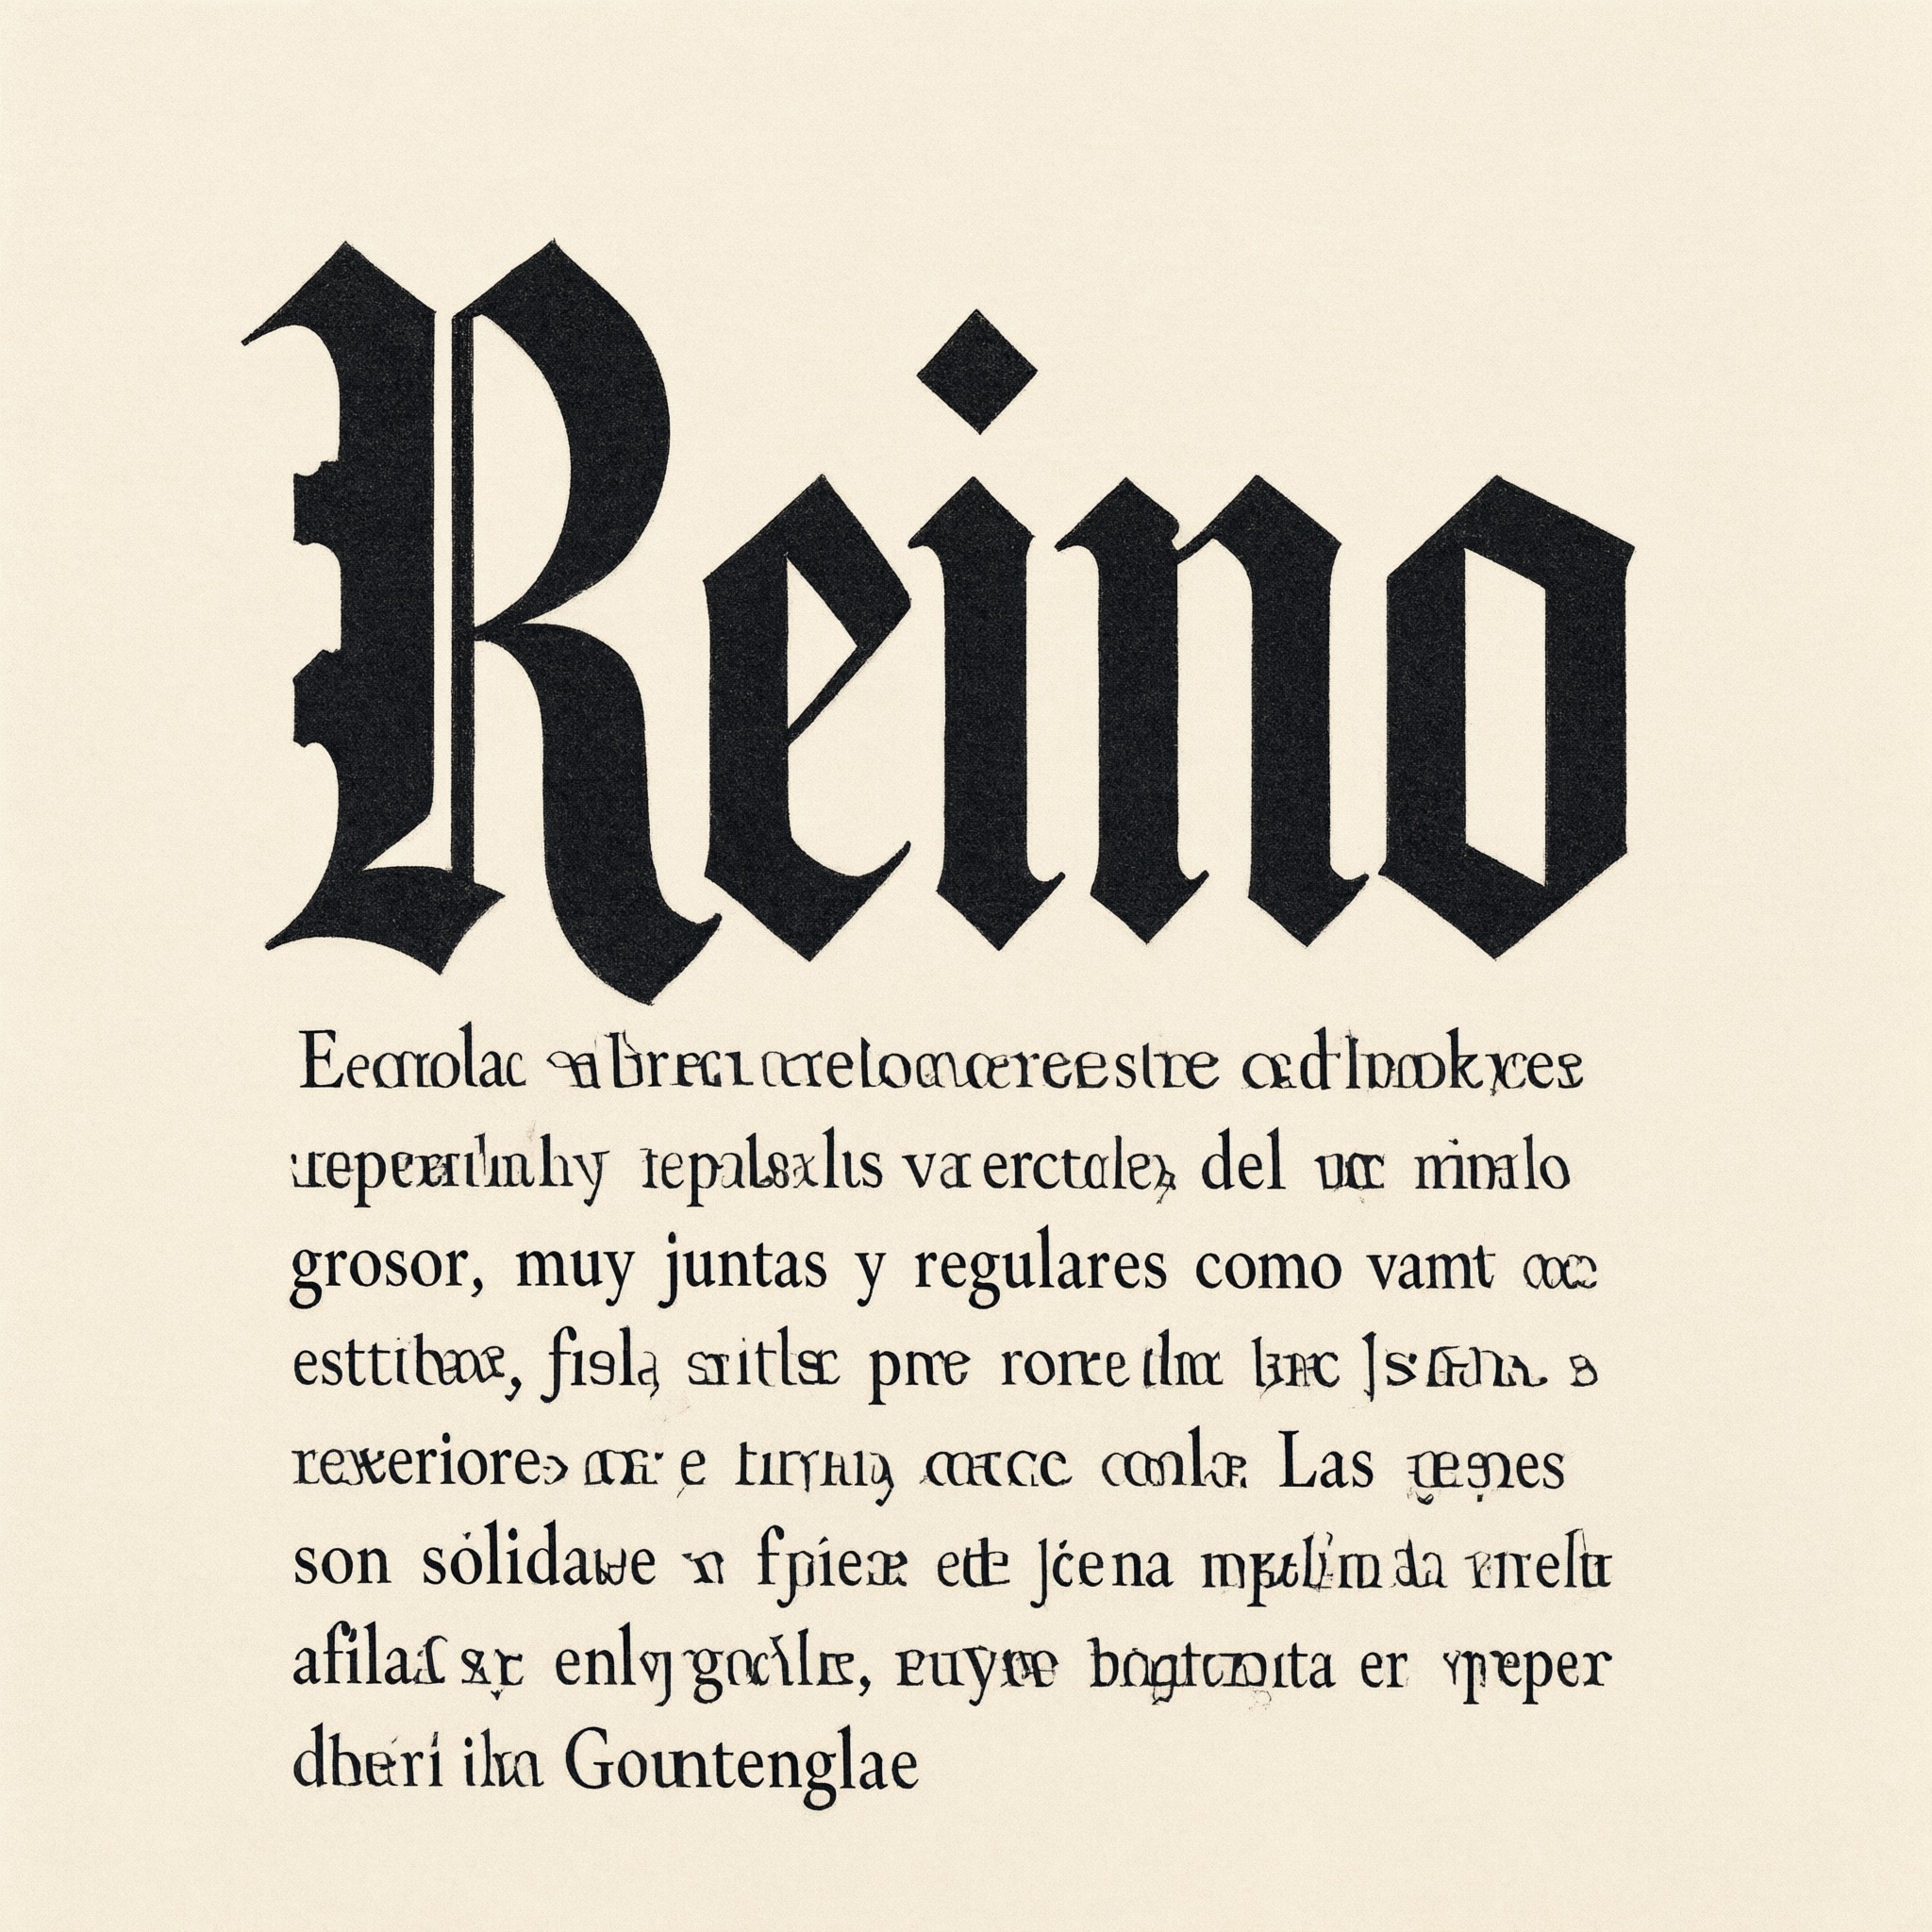
Esse padrão, a palavra pedida mais um bloco de texto não solicitado, responde por 40 dos 86 erros do Qwen-Image. O texto extra muitas vezes é uma cópia embaralhada do próprio prompt.
Japonês: onde a diferença aparece
| GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image | |
|---|---|---|---|---|---|
| Japonês | 59/59 | 58/59 | 52/59 | 51/59 | 45/59 |
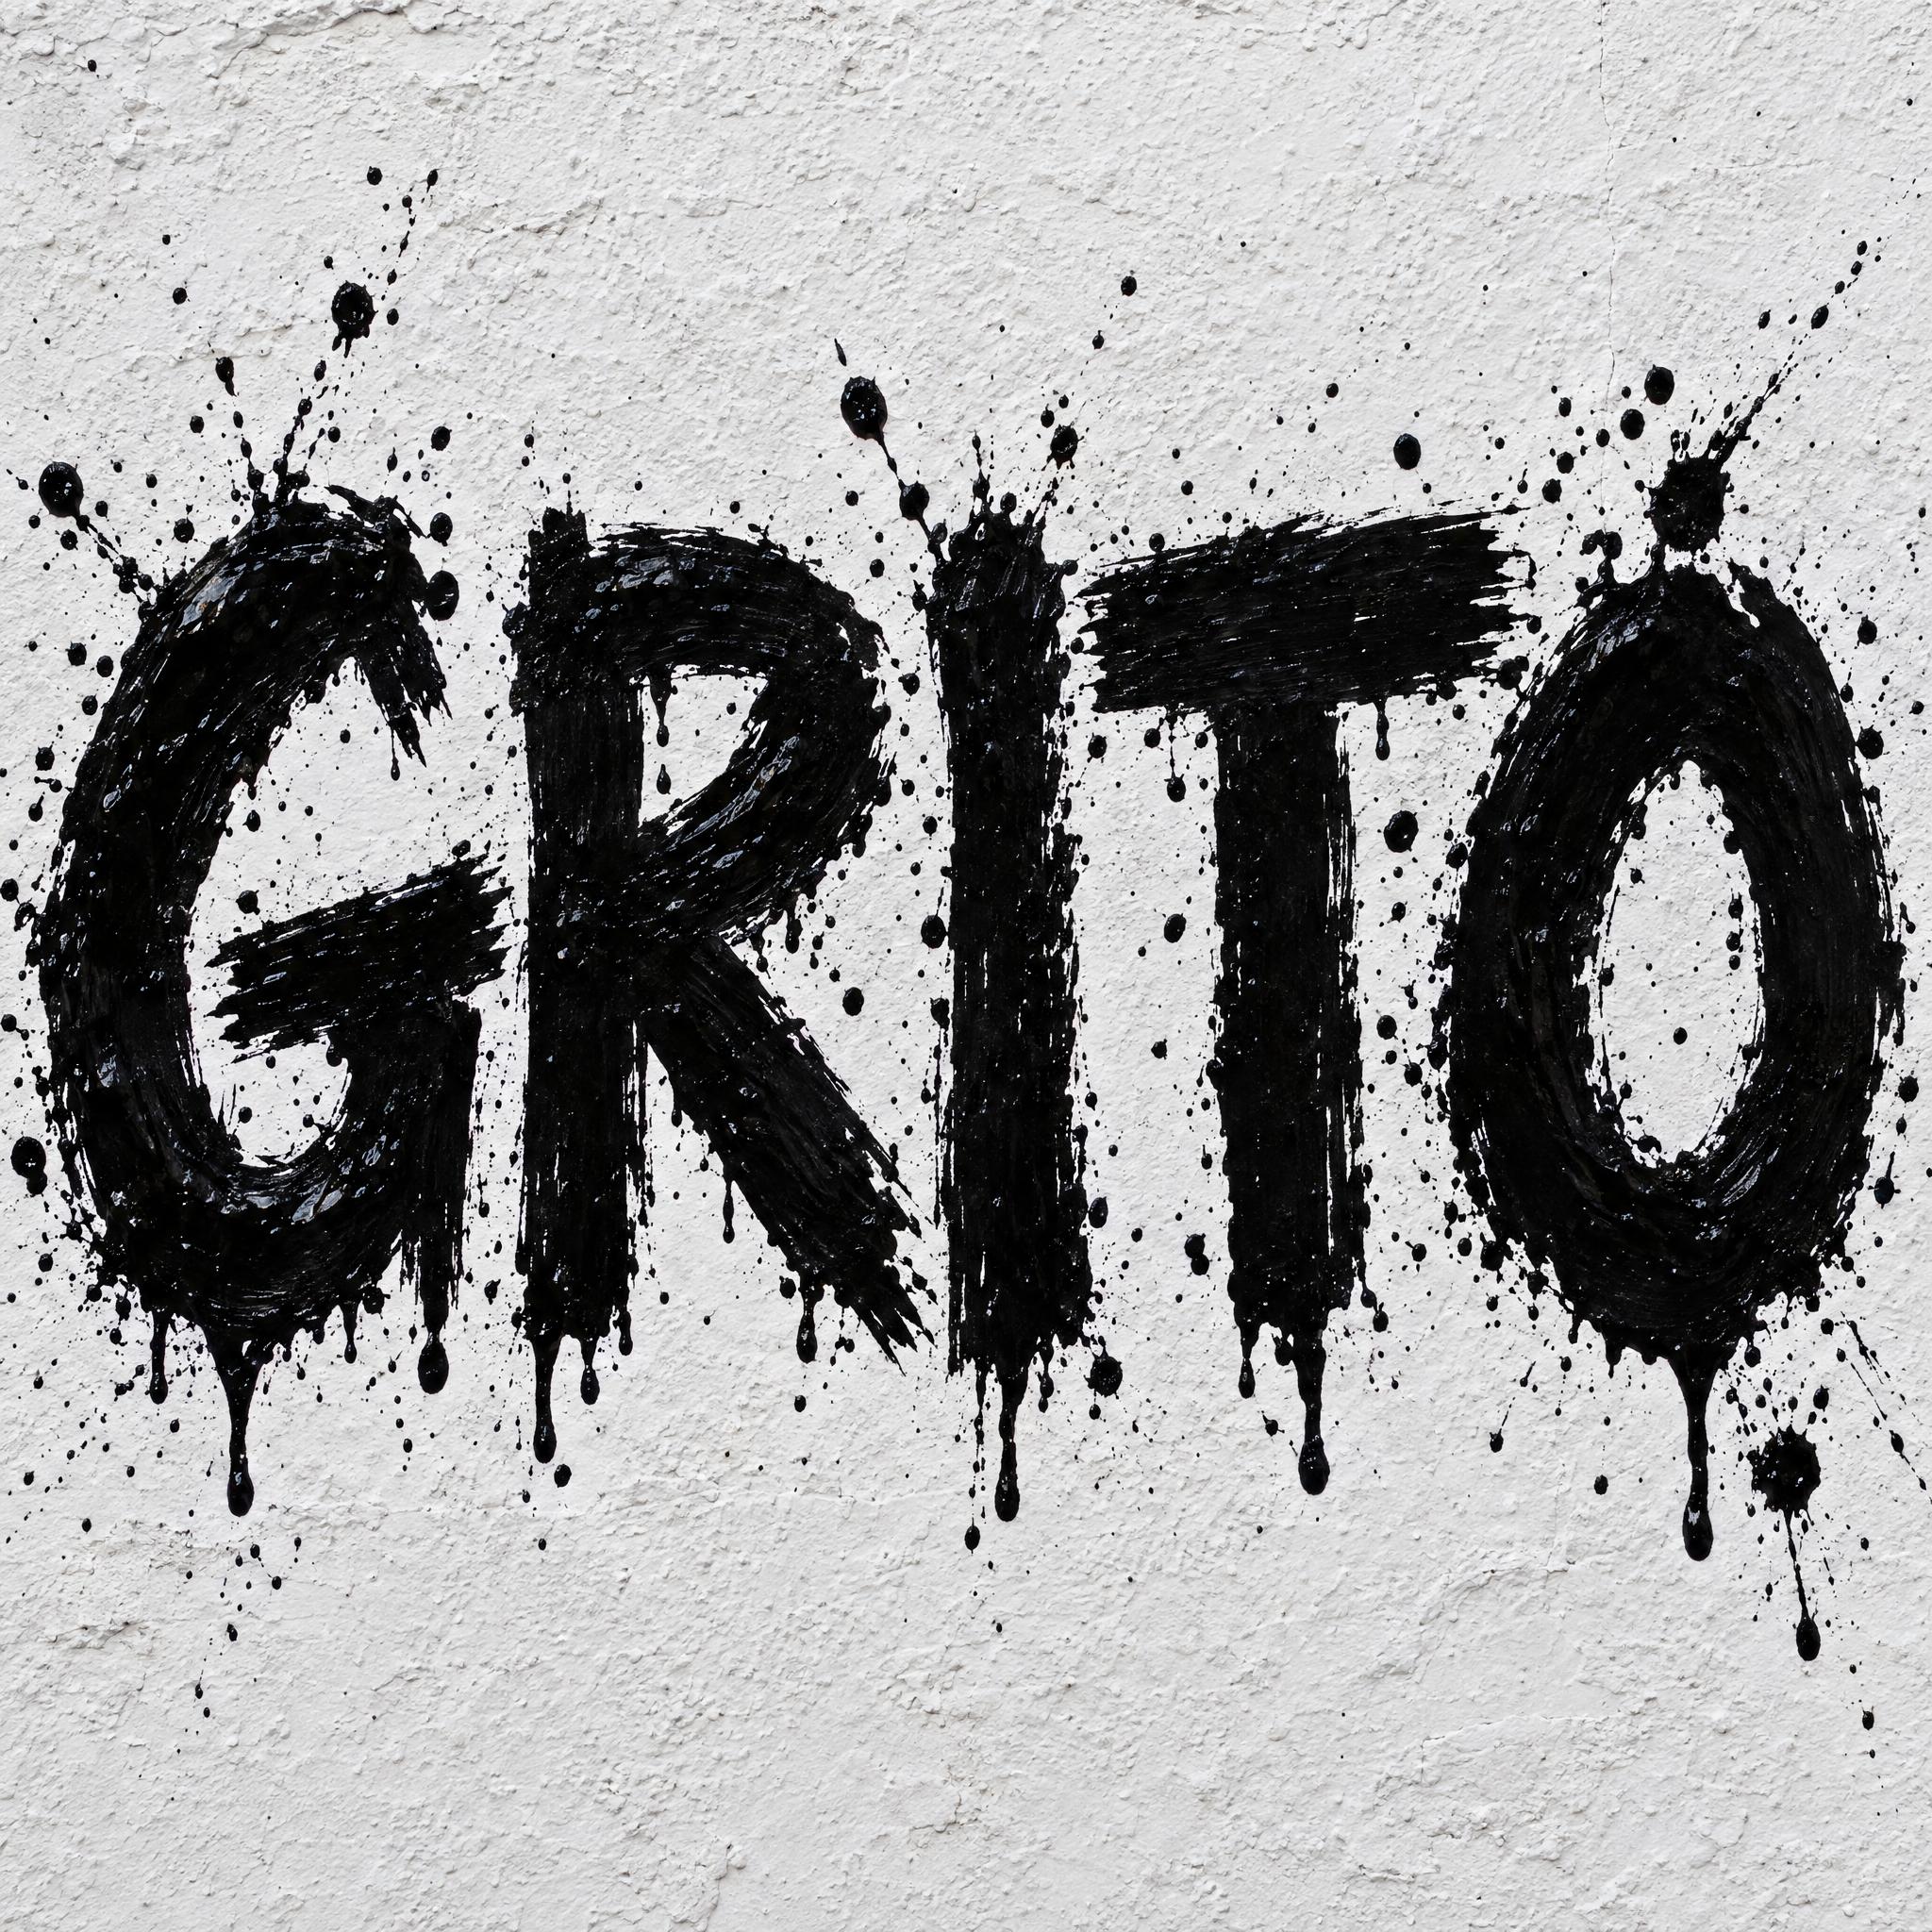
O kana japonês tem marcas pequenas que mudam a palavra: dois tracinhos (dakuten) transformam は em ば. No nosso prompt de paint splatter, Grok Imagine e Seedream colocaram dakuten onde não devia haver.
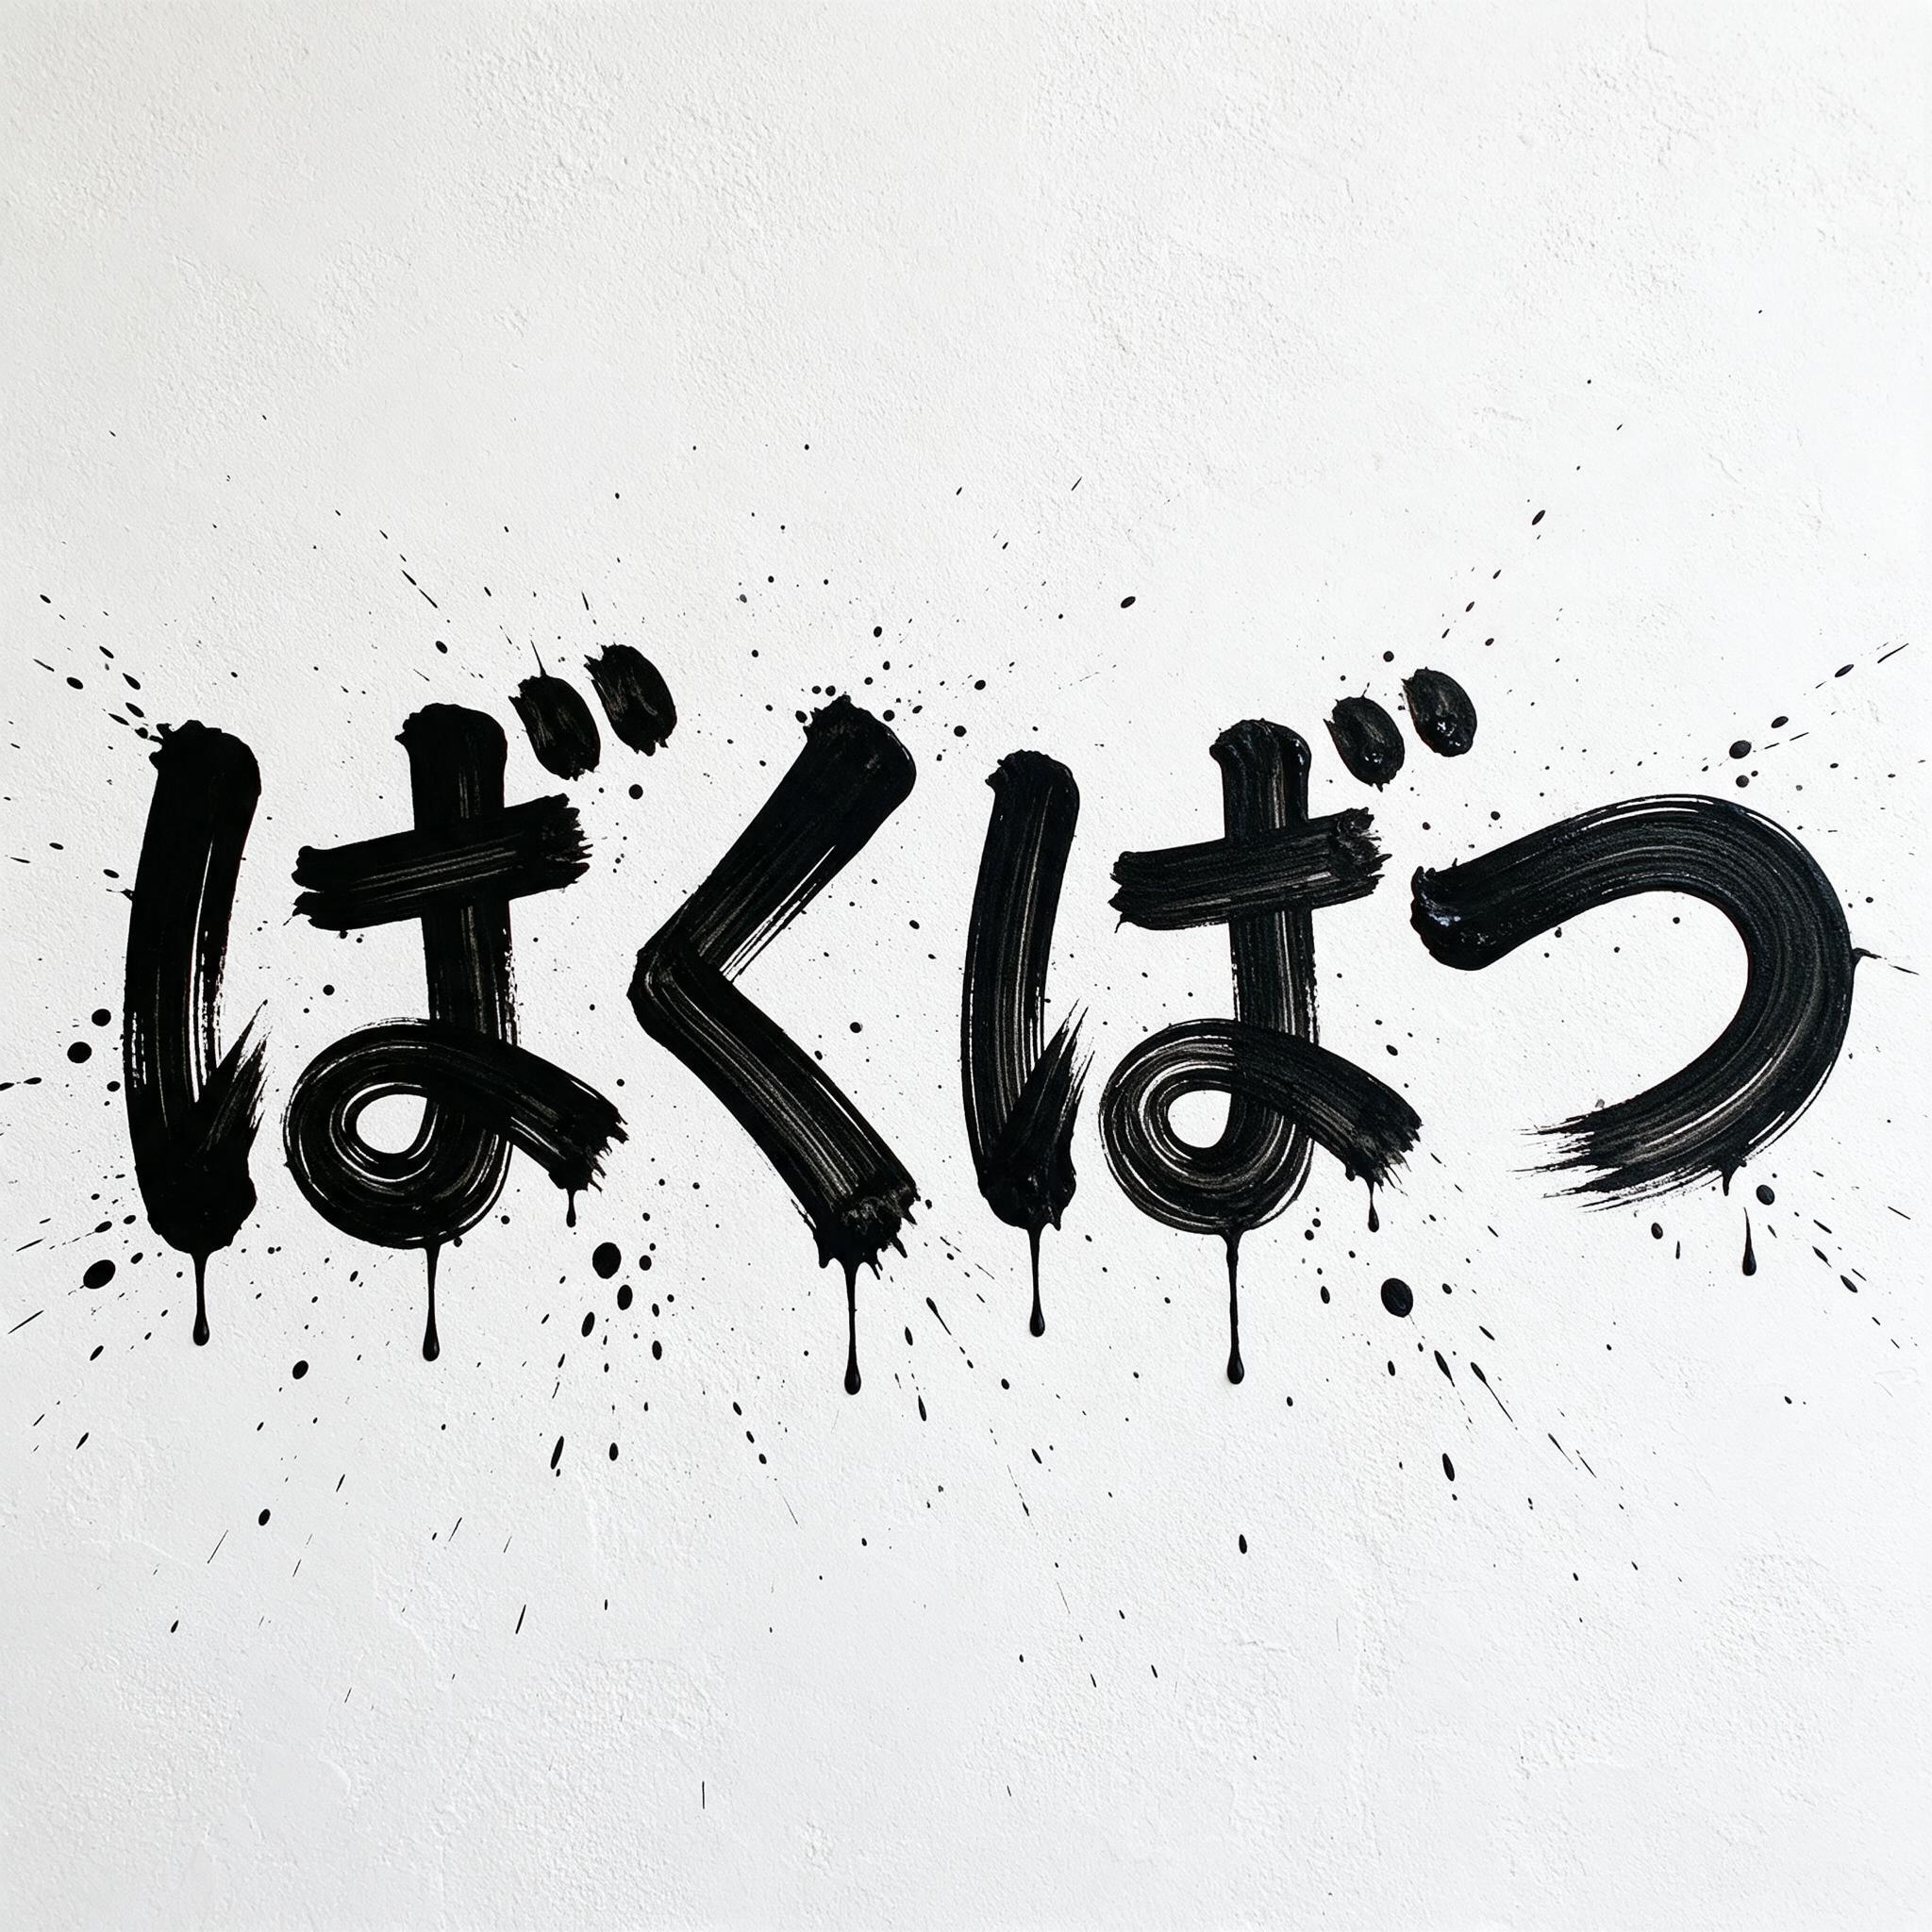
Os outros erros de japonês do Grok Imagine e do Seedream seguem o mesmo formato: um caractere trocado, não uma palavra embaralhada. O Grok escreveu ストリトト em vez de ストリート, ジングス em vez de ジンクス e ぼうげん em vez de ぼうけん; o Seedream escreveu かくどう em vez de かくとう e ねがいの em vez de ねがい. Um leitor japonês percebe cada um desses na hora.
Árabe: só dois modelos aguentam
| GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image | |
|---|---|---|---|---|---|
| Árabe | 48/50 (96%) | 51/51 (100%) | 35/49 (71%) | 27/47 (57%) | 6/53 (11%) |
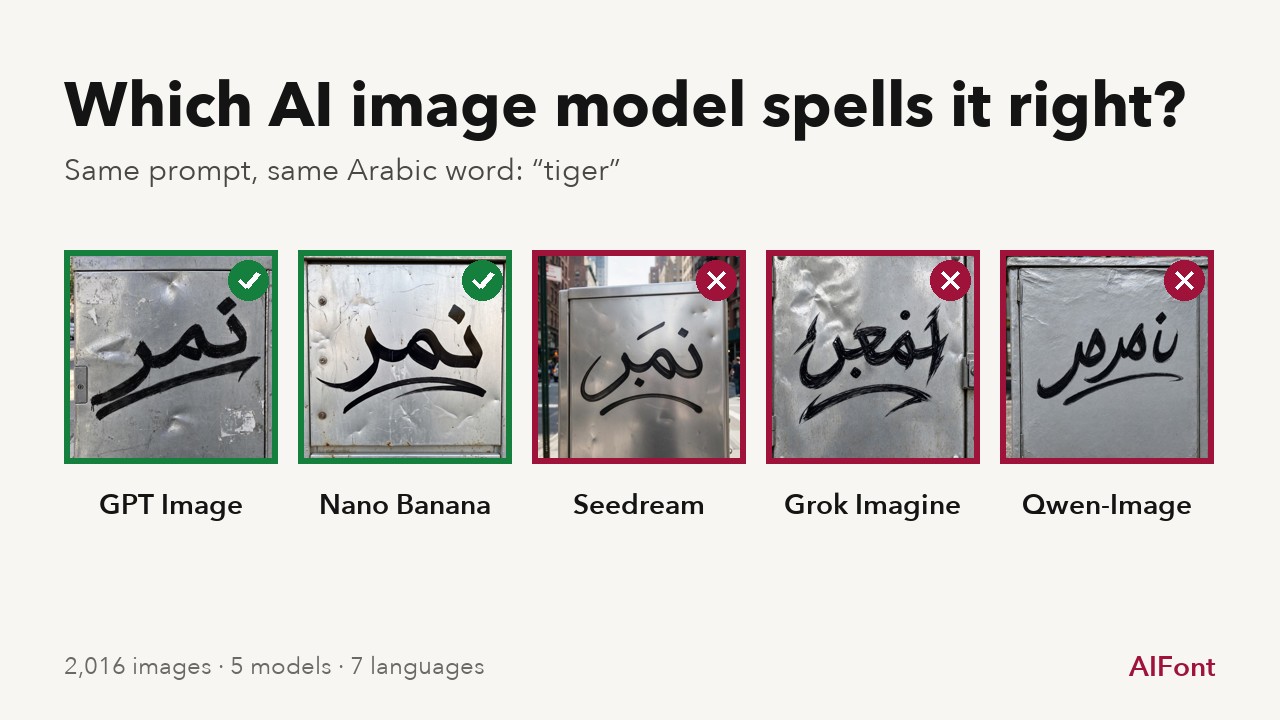
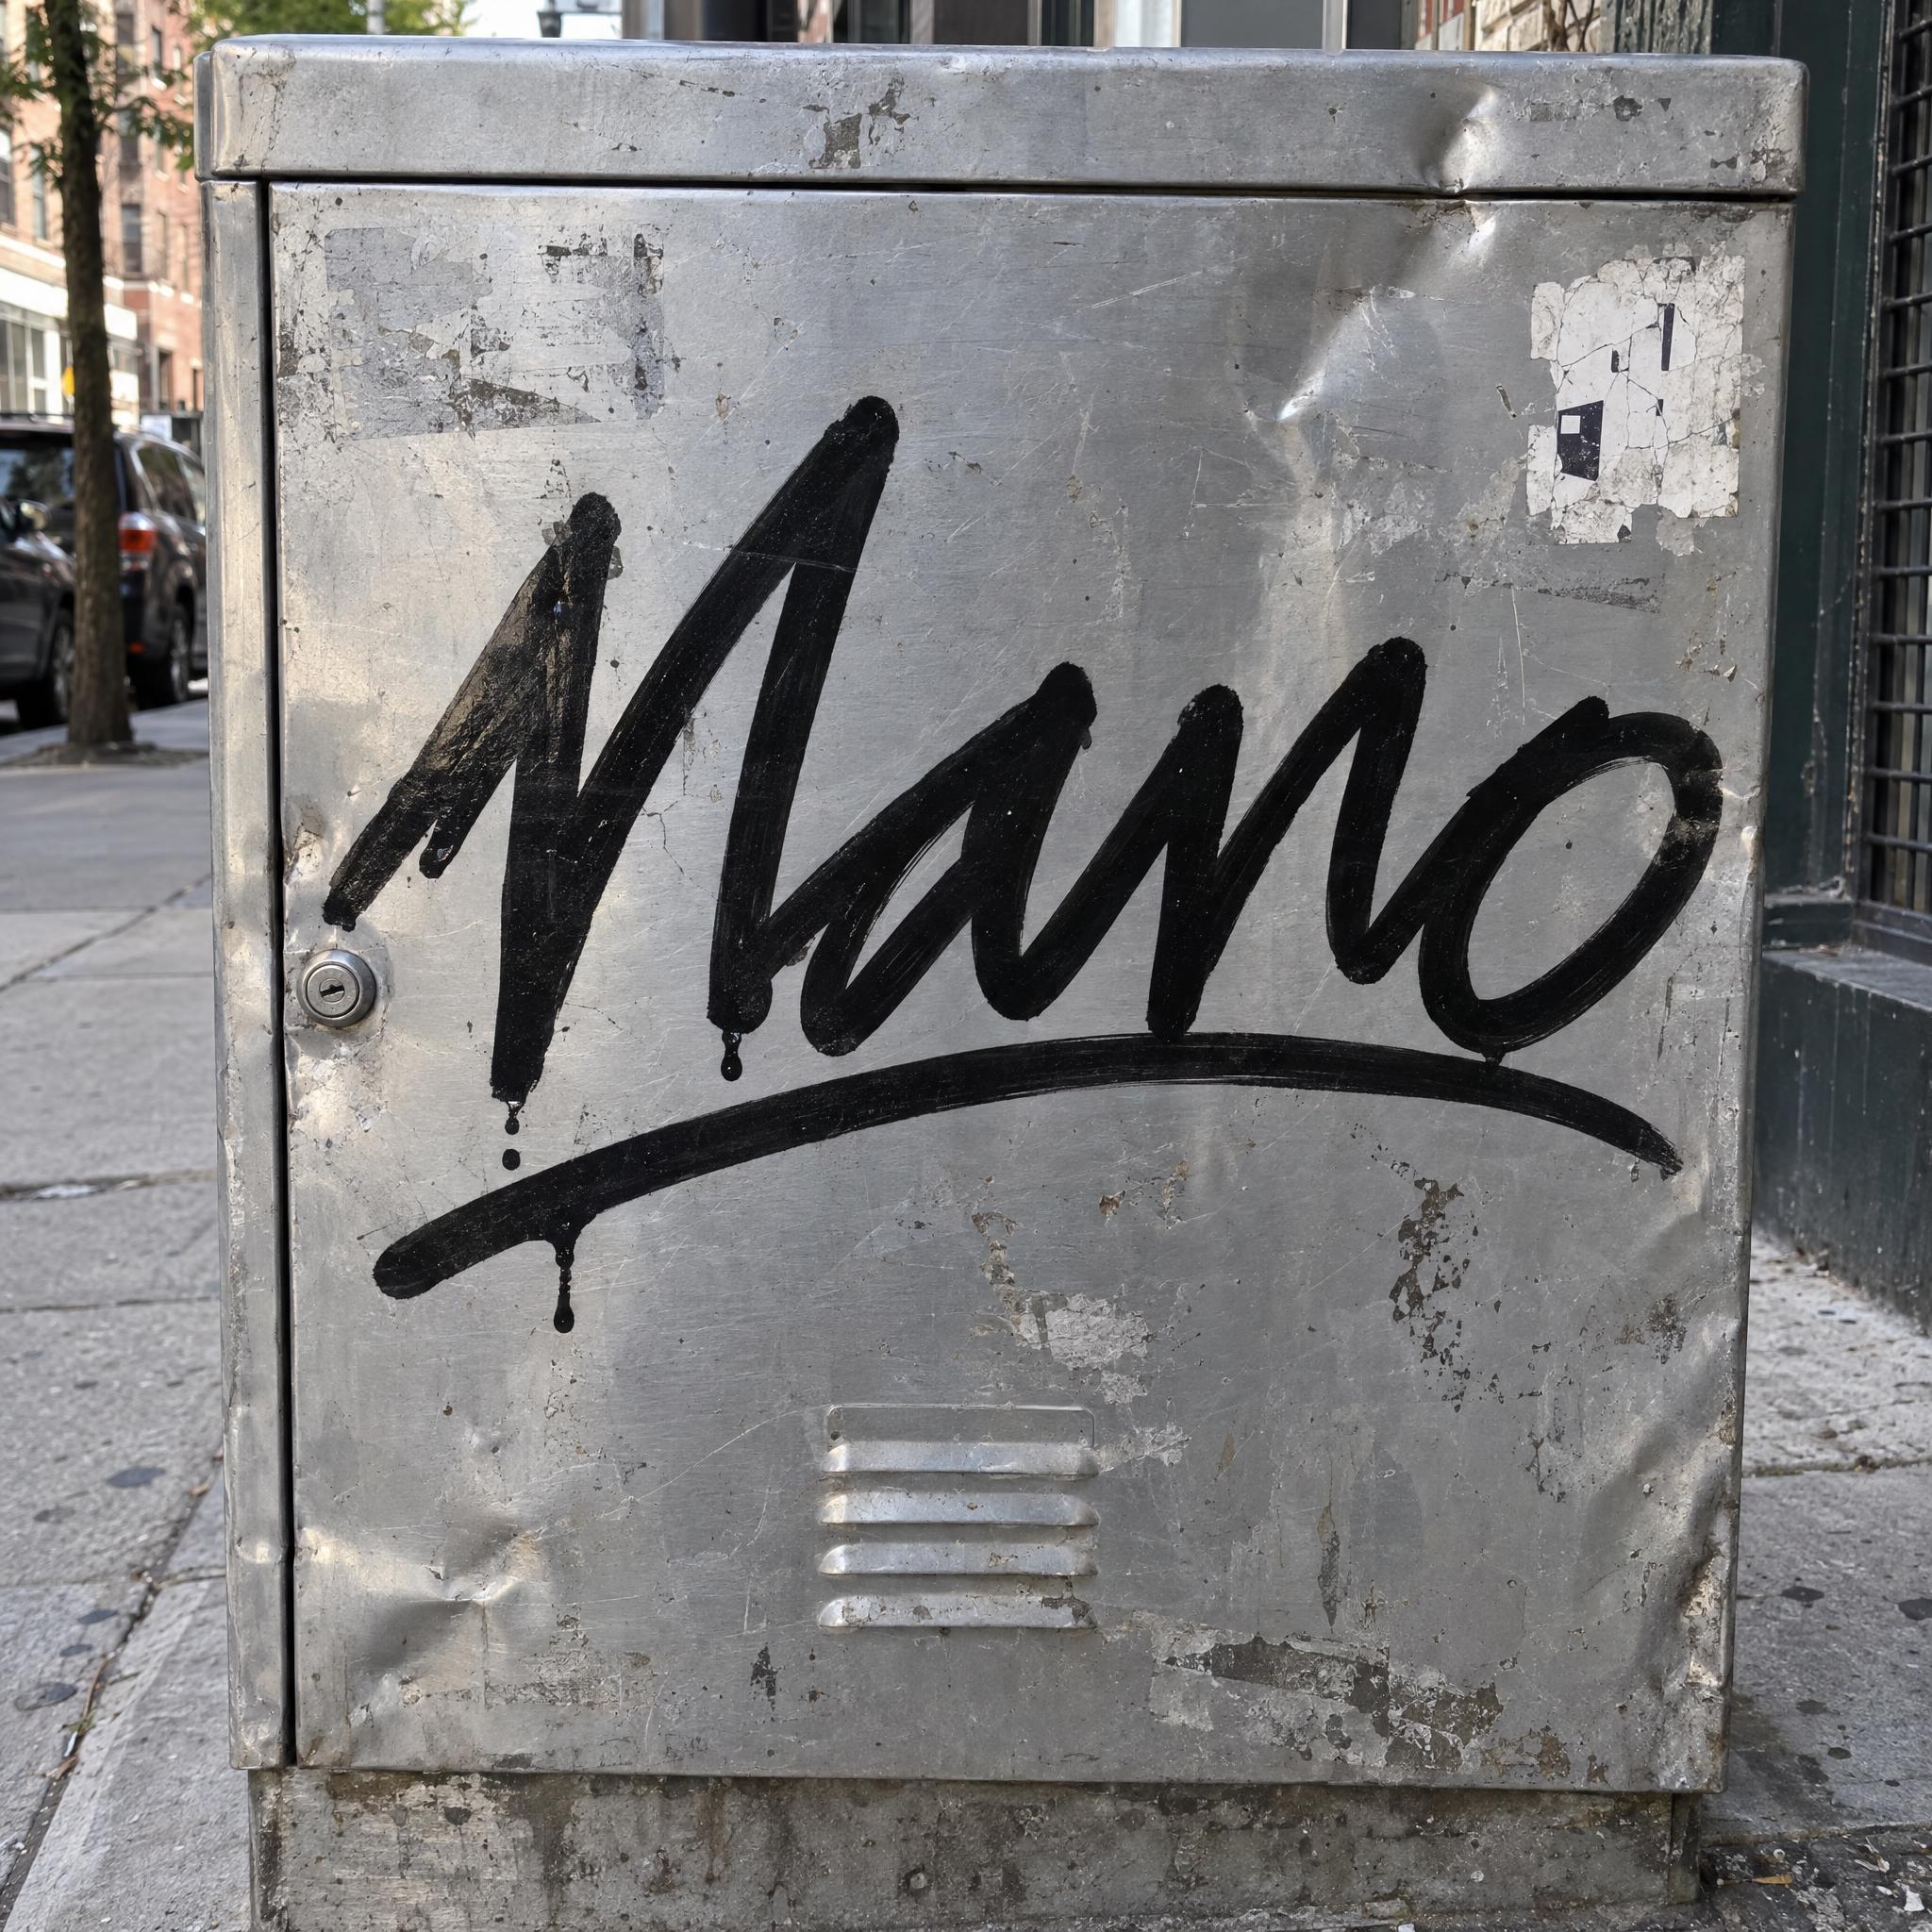
O árabe é a escrita mais difícil deste teste. As letras se ligam, mudam de forma conforme a posição, e muitas só se distinguem pelo número ou pela posição dos pontos. Um único prompt mostra toda a variação: a palavra نمر (tigre) como grafite numa caixa de luz de rua.
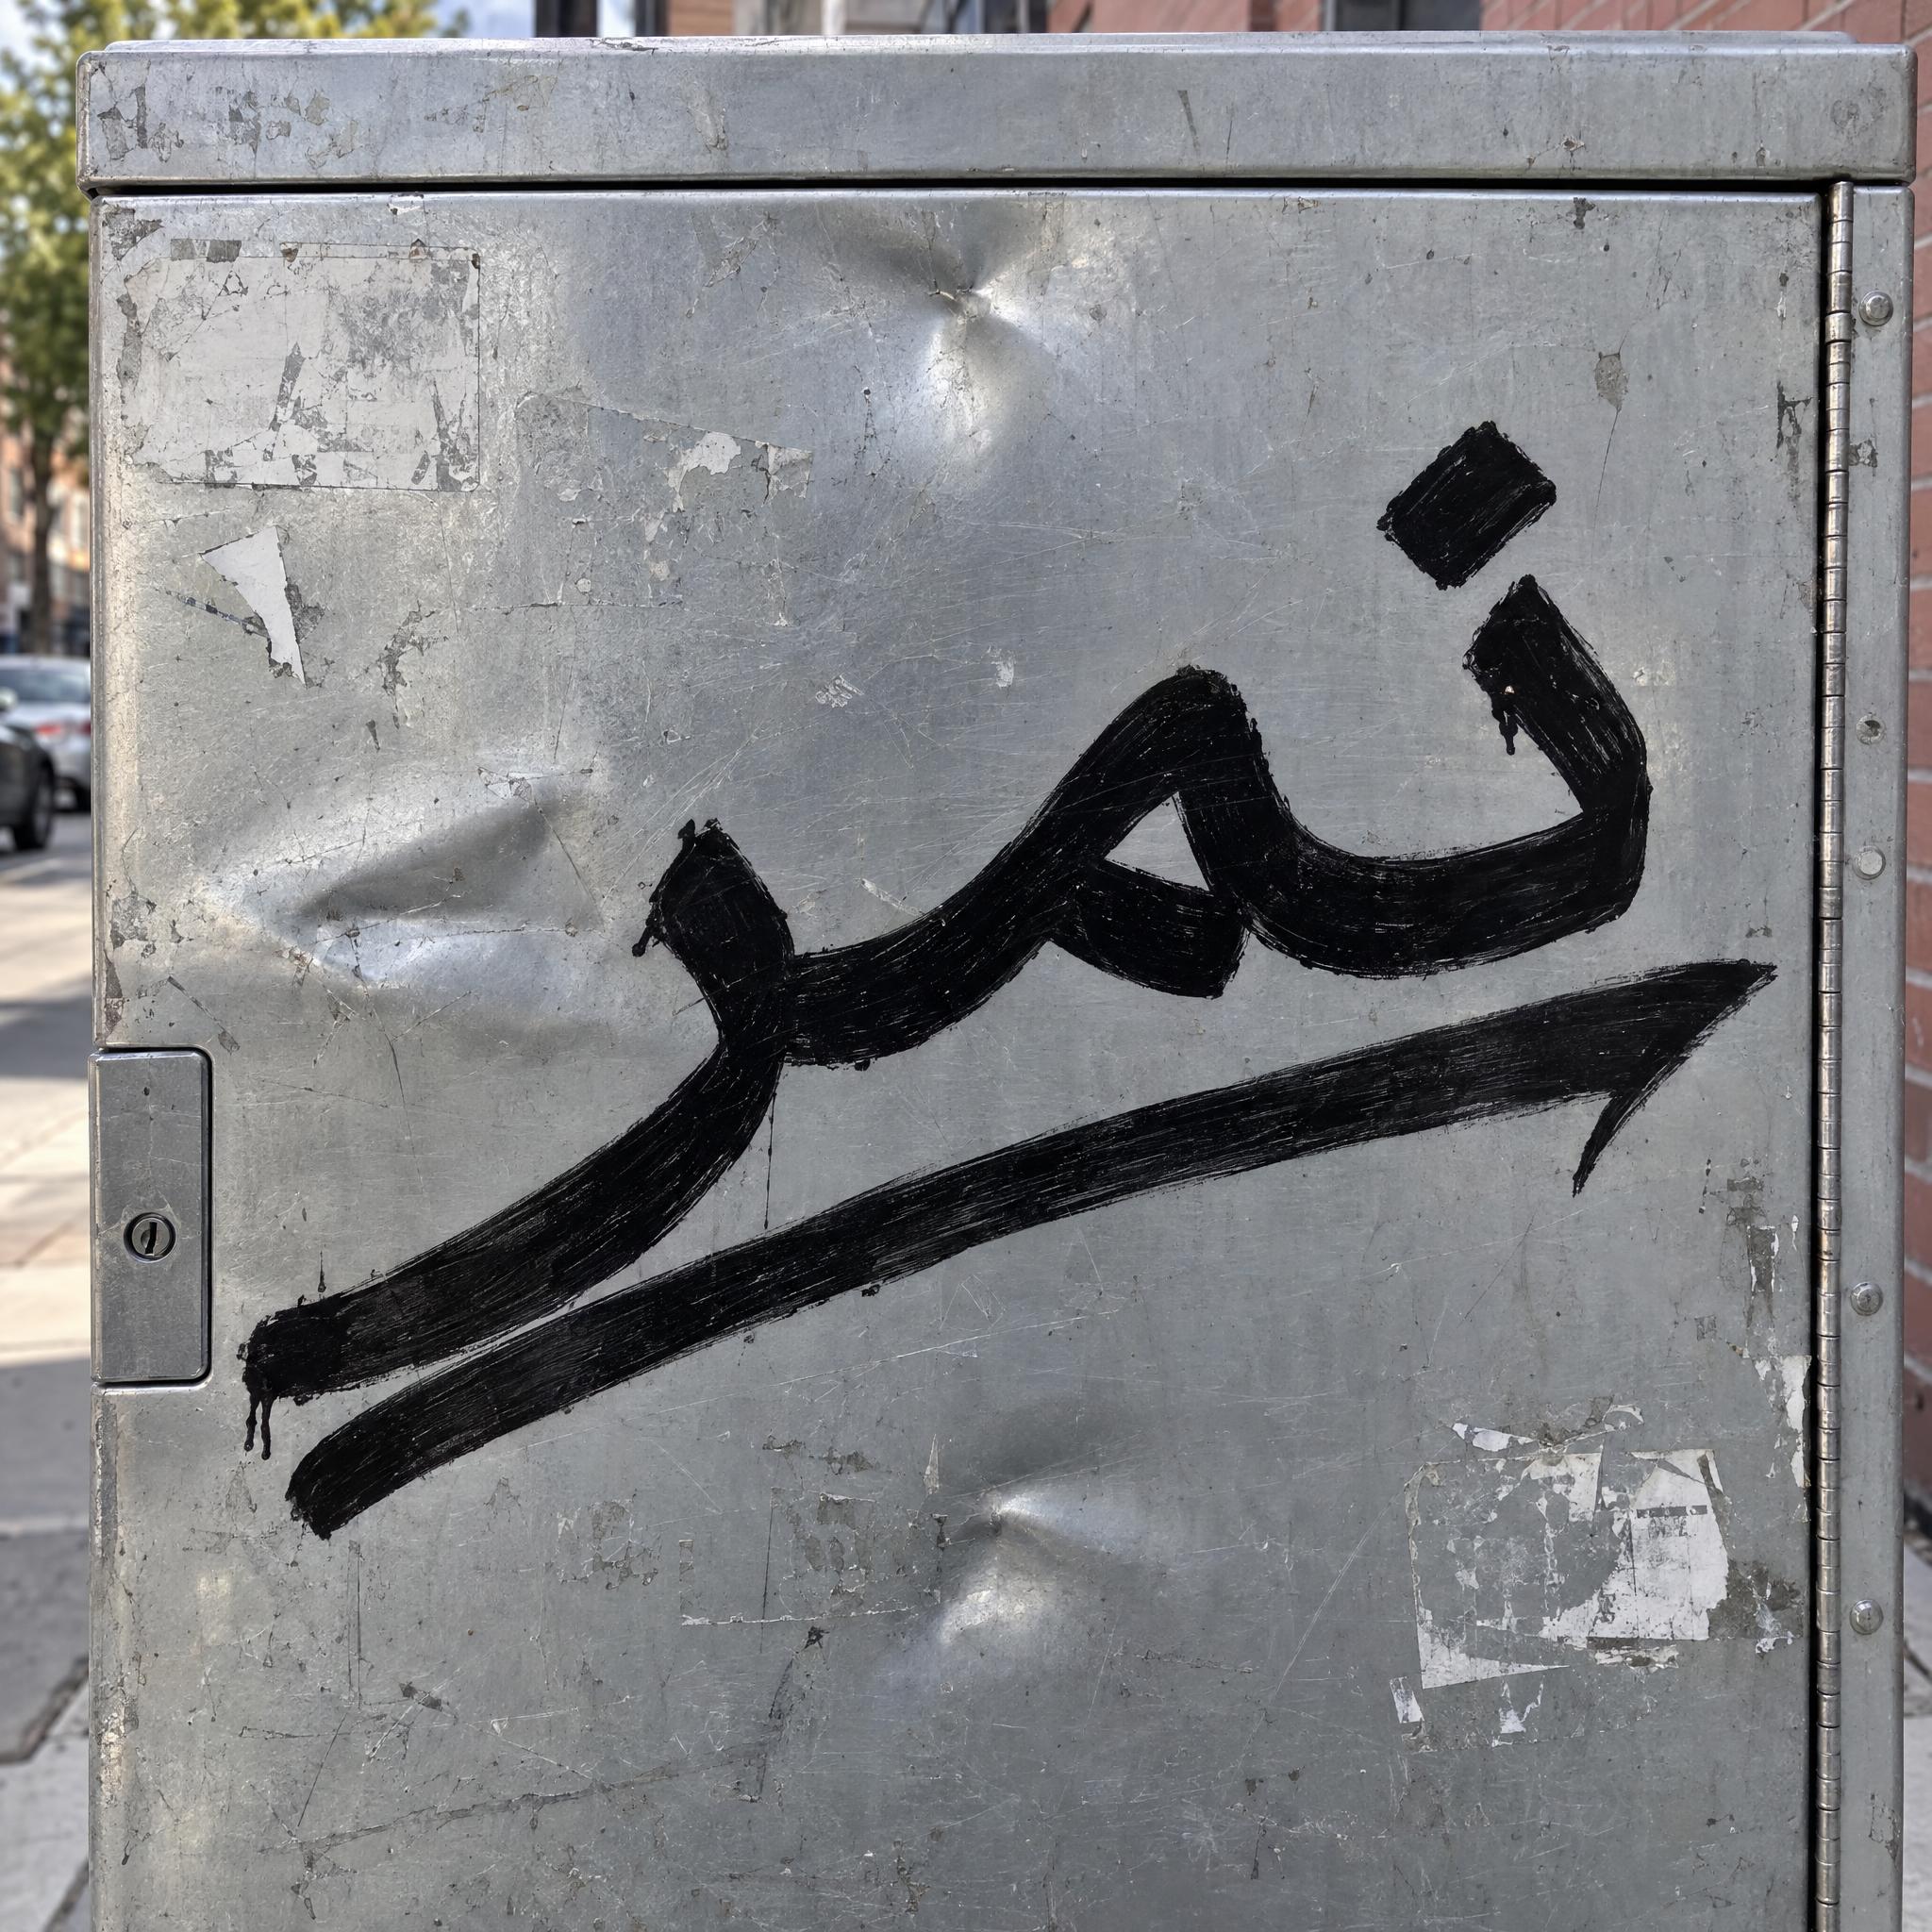
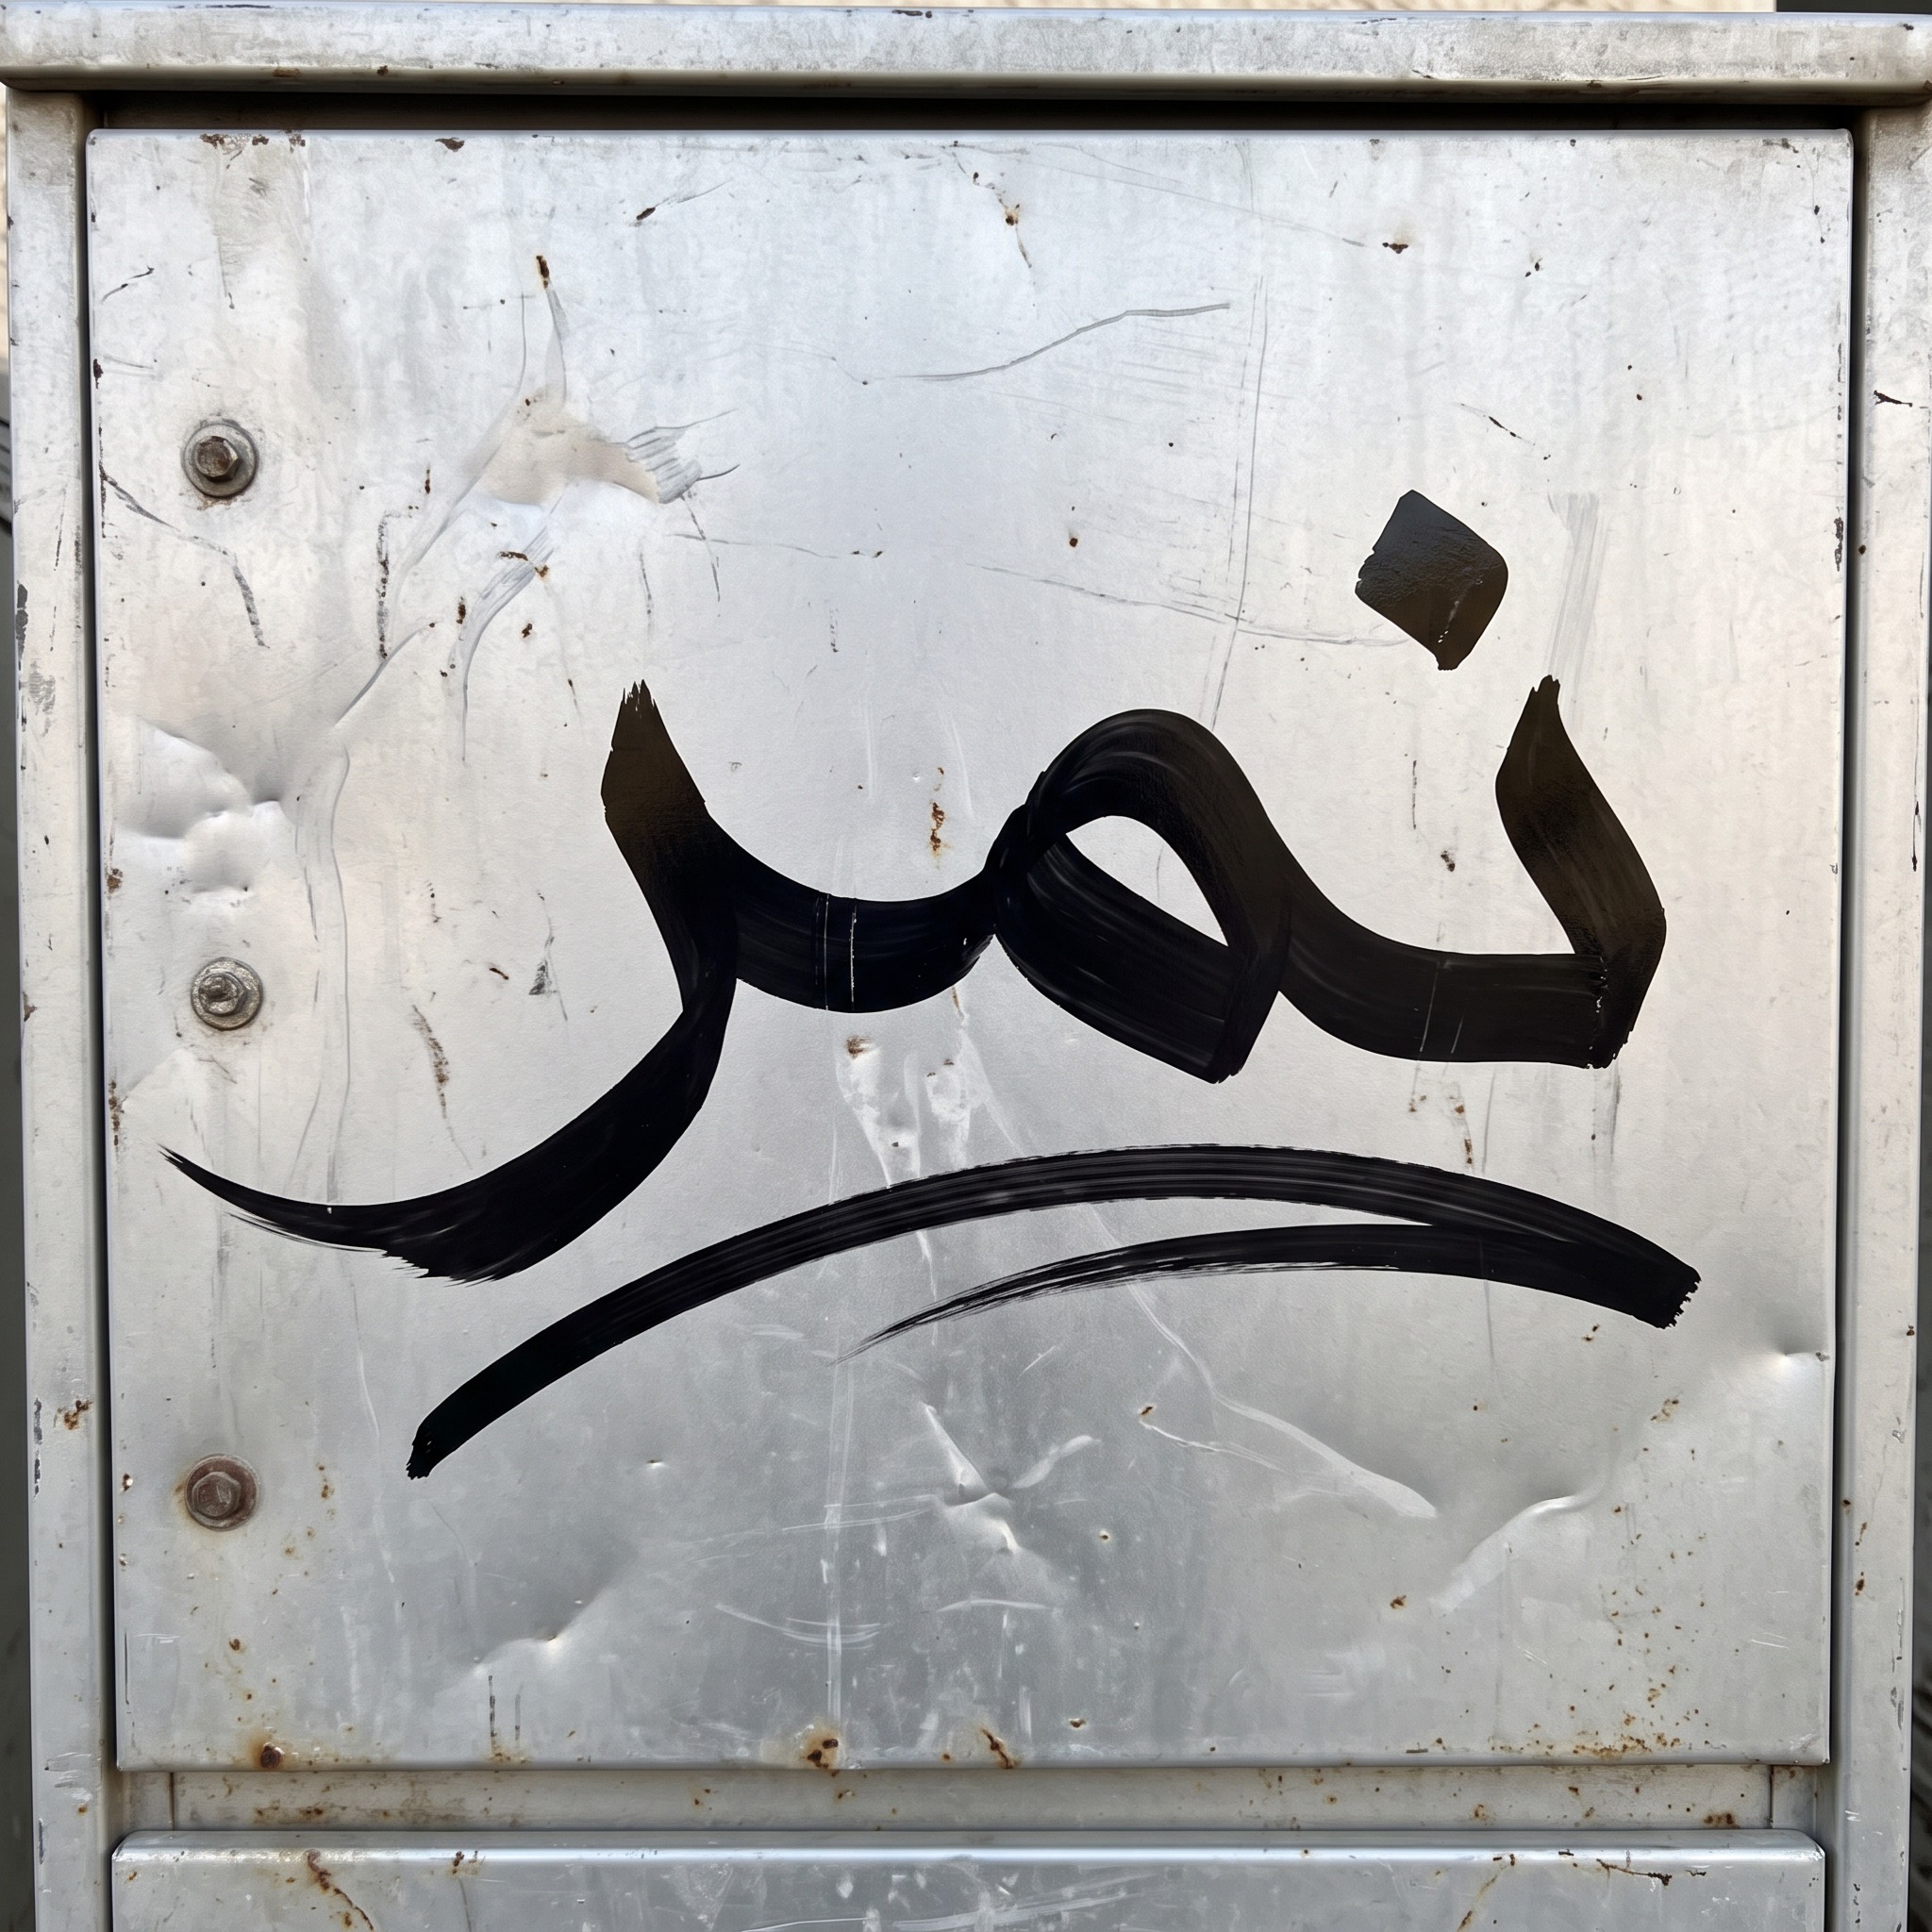
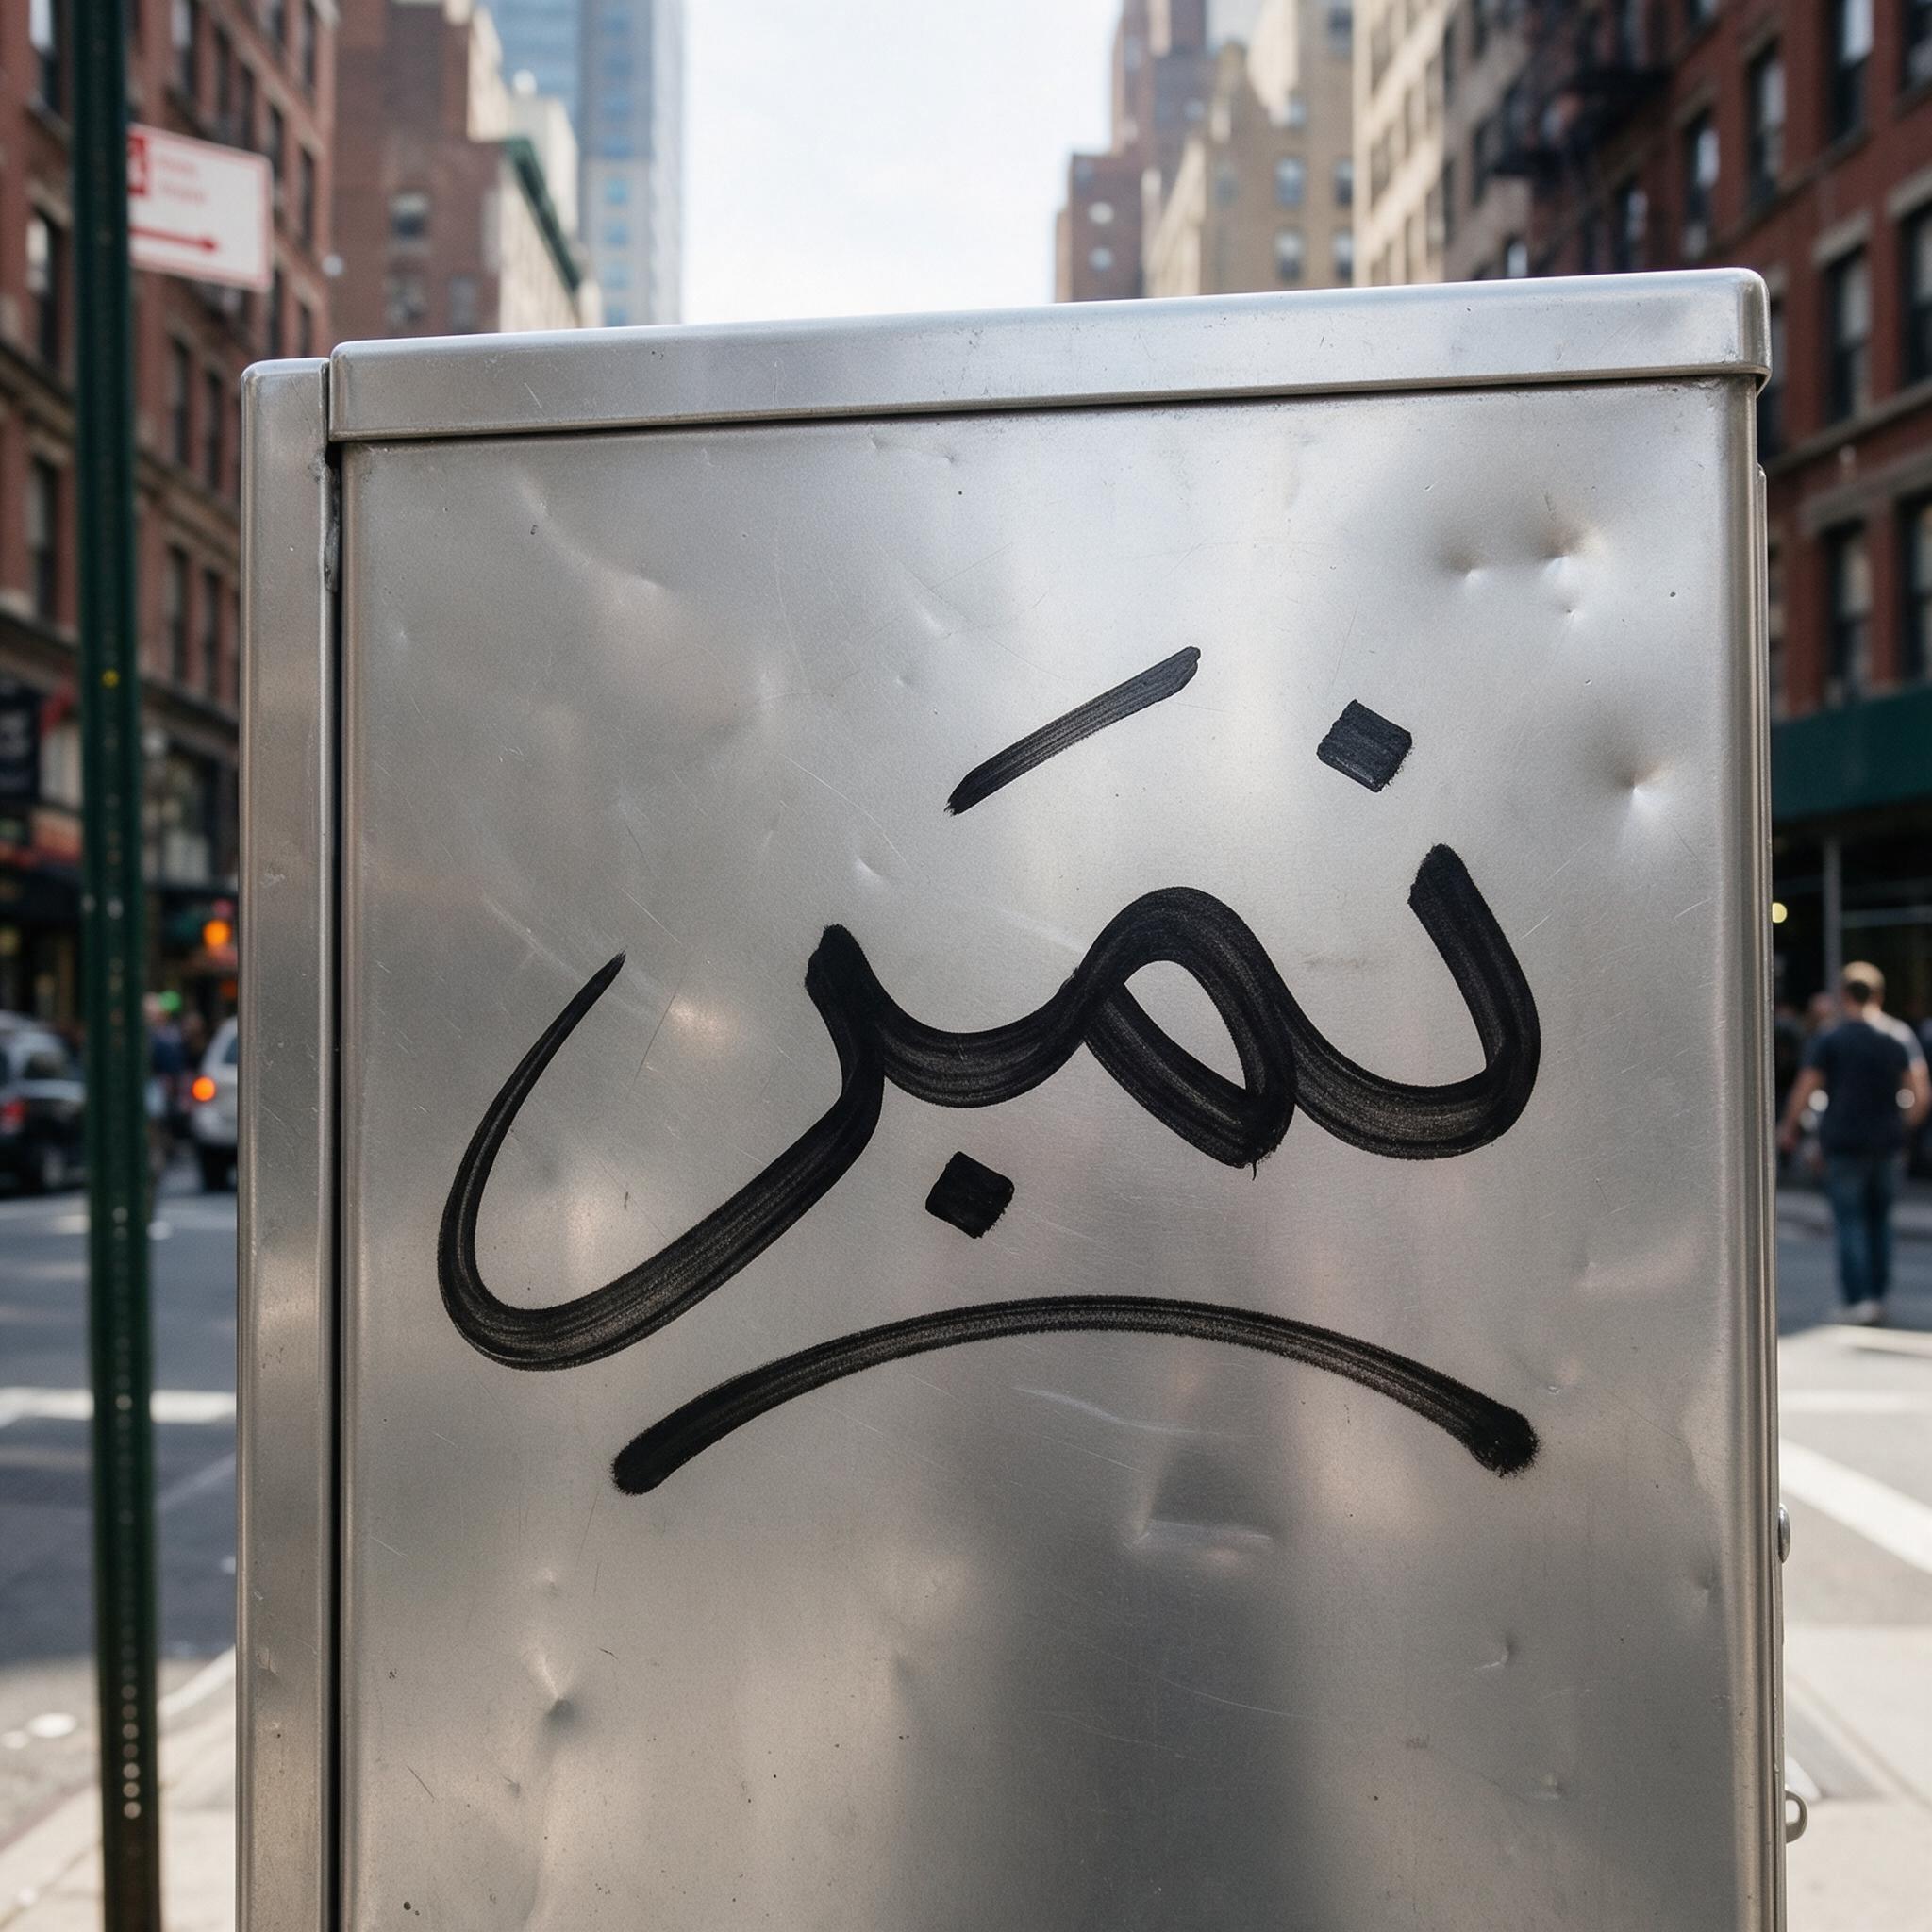
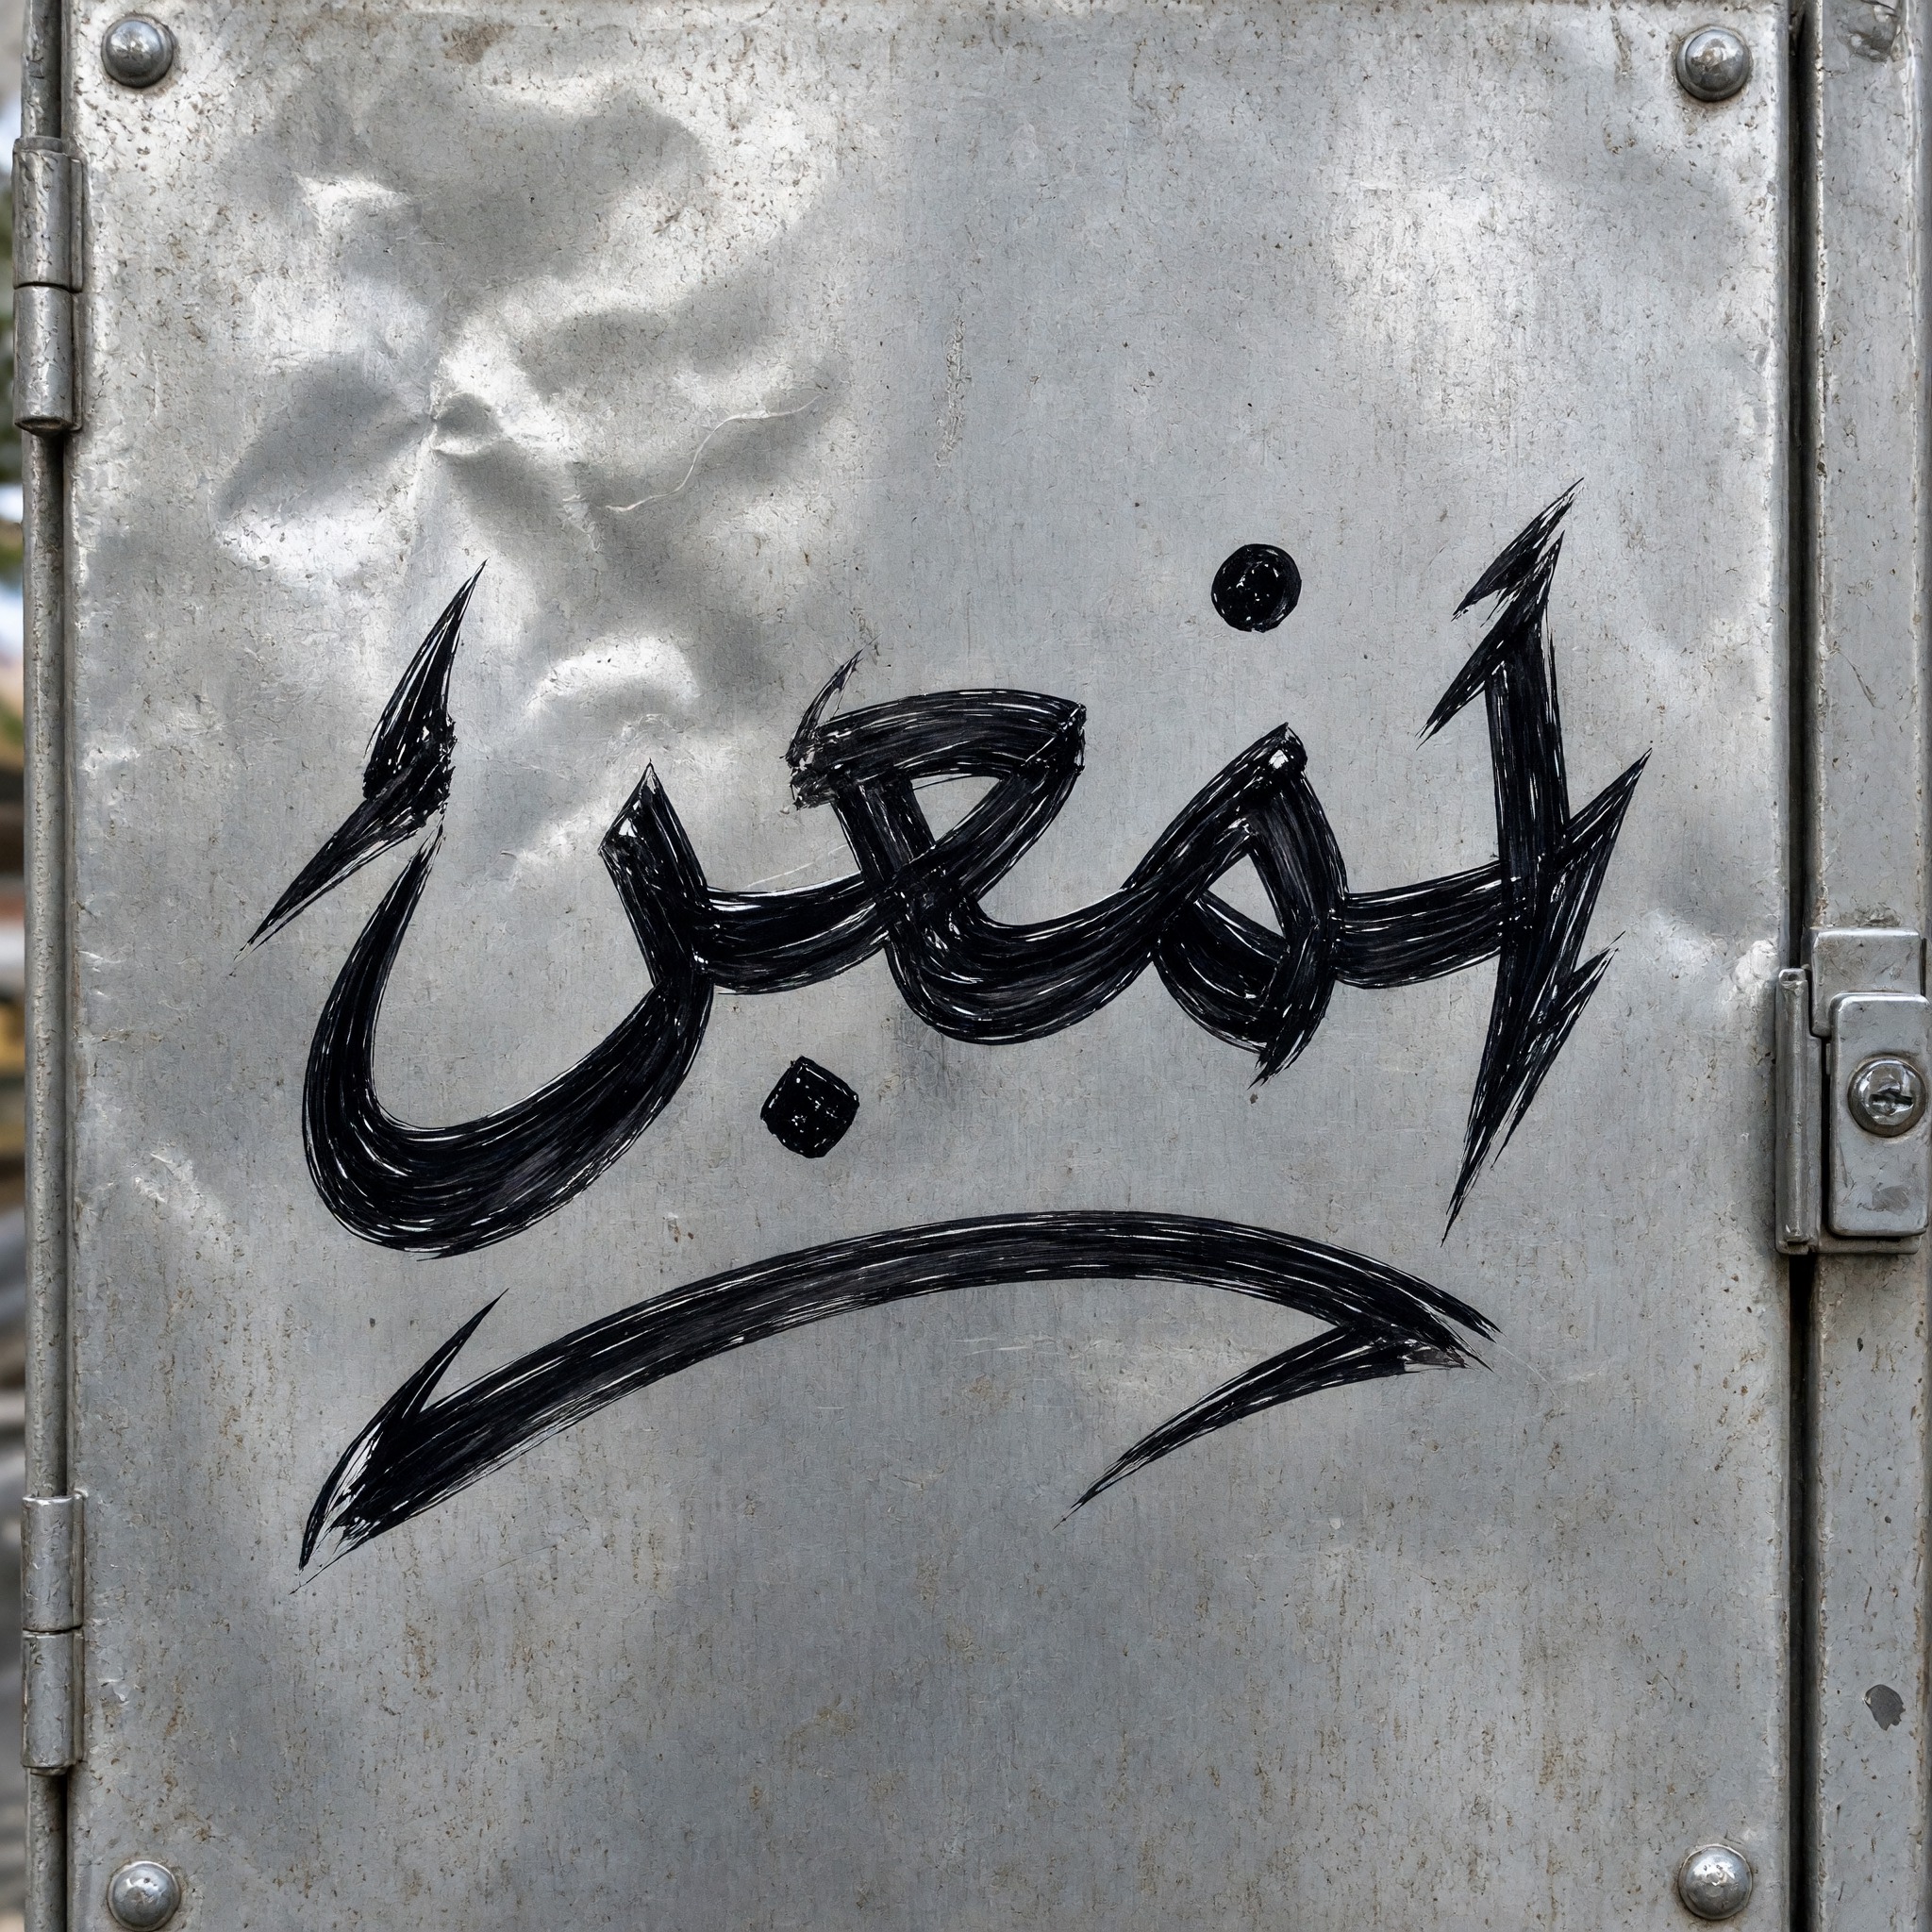
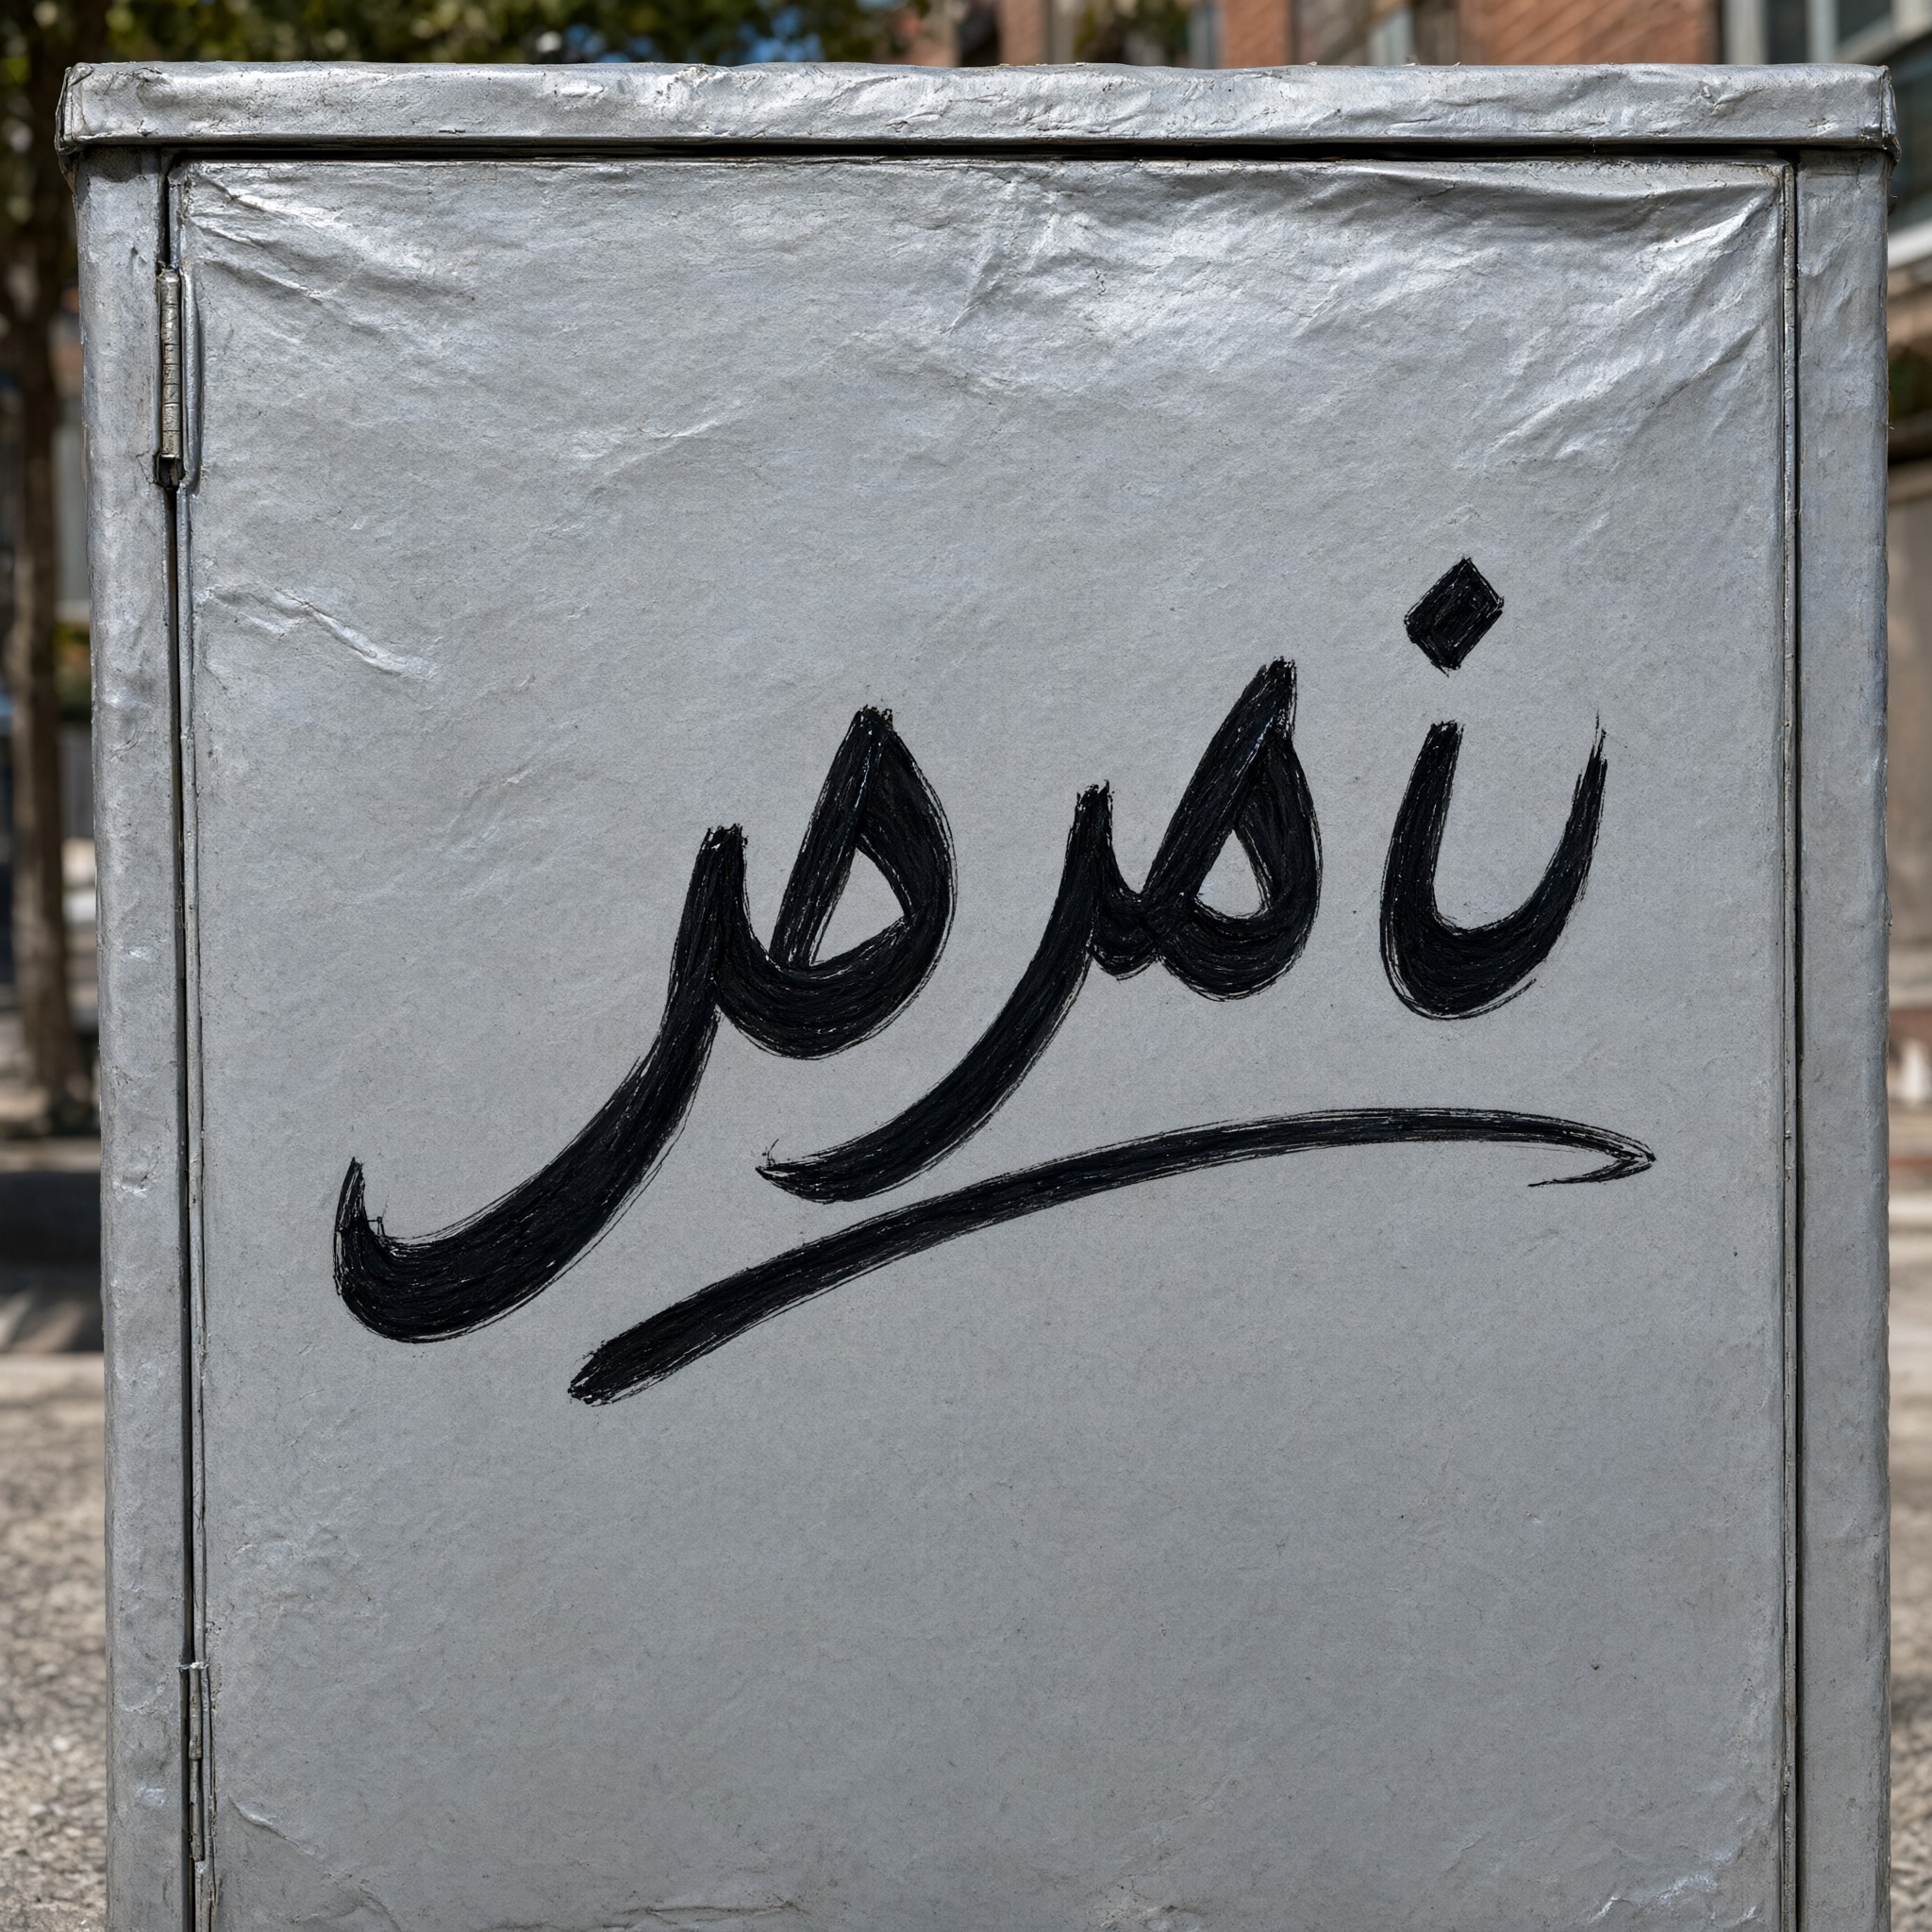
Grok Imagine e Seedream perdem pontos no árabe por causa de pontos e letras extras. Dos 14 erros do Grok em árabe, 6 são um ponto faltando, sobrando ou fora do lugar e 5 uma letra a mais; dos 20 do Seedream, 9 são pontos e 7 letras extras. No nosso prompt de gingerbread, os dois modelos espalharam pedacinhos redondos de biscoito em cima e em volta de كعك, que acabam lidos como pontos extras.
O árabe do Qwen-Image é outro problema. Ele raramente escreve a palavra pedida; escreve uma linha de outras letras árabes em volta dela ou no lugar dela.
Os números do árabe têm uma ressalva. Nenhum dos nossos revisores é falante nativo de árabe, e 41 imagens em que a IA e a pessoa discordaram ficaram de fora. Temos confiança no ranking, já que a distância entre 96% e 11% é muito maior que qualquer erro de revisão. As porcentagens exatas podem mudar à medida que falantes nativos corrigirem o dataset.
Até os líderes erram
Os três erros do GPT Image: VENON em vez de VENOM numa camiseta de death metal, e duas palavras em árabe, uma com a última letra errada (تحيئ em vez de تحية) e outra com uma letra a menos (فتة em vez de فتنة).
Os dois do Nano Banana: uma palavra em japonês com um caractere deformado, e uma imagem de Halloween em chinês que acrescentou três pequenos rótulos "PARTY!" em volta da palavra pedida, 南瓜. A palavra em si estava certa; o texto extra quebrou a nossa regra.
Rodar de novo ajuda?
Em parte, e depende do modelo. Contamos os casos em que a primeira imagem saiu errada e verificamos se mais uma rodada resolvia.
| Primeira imagem errada | Corrigida com mais uma tentativa | |
|---|---|---|
| GPT Image | 3 | 1 |
| Nano Banana | 2 | 2 |
| Grok Imagine | 28 | 13 |
| Seedream | 36 | 18 |
| Qwen-Image | 86 | 10 |
Grok Imagine e Seedream cometem erros de detalhe, um ponto ou um traço, e cerca de metade some na segunda tentativa. A mania do Qwen-Image de acrescentar texto resiste a novas rodadas: só 10 de 86 foram corrigidos. Se um modelo insiste em acrescentar texto, reescrever o prompt ajuda mais do que rodá-lo de novo.
Qual modelo usar para texto?
- Qualquer idioma, uma tentativa só: GPT Image ou Nano Banana. Escolha pelo visual. A precisão do texto não é motivo para preferir um ao outro.
- Só inglês ou chinês: os cinco funcionam. Grok Imagine e Seedream são boas escolhas se você gosta do estilo deles; confira o resultado antes de imprimir.
- Japonês: GPT Image ou Nano Banana. Com os outros, leia cada kana e confira os dakuten.
- Árabe: GPT Image ou Nano Banana. Não publicaríamos texto em árabe dos outros três sem um falante nativo revisar.
- Qwen-Image: mantenha a palavra de destaque curta e confira a imagem inteira em busca de letras extras, não só a palavra que você pediu.
Cada página de fonte da AIFont mostra os resultados dos cinco modelos em cada idioma, para você ver como um estilo fica escrito antes de copiar o prompt. As coleções de fonte gótica e letras de grafite são um bom lugar para compará-los lado a lado.
Os dados são abertos
Todas as 2.495 imagens do dataset, com prompts, veredictos e notas de revisão, são públicas sob CC BY 4.0: dataset de renderização de texto da AIFont no GitHub, arquivado no Zenodo (DOI 10.5281/zenodo.23815210). Se você lê árabe, japonês ou qualquer outro idioma do dataset e encontrar um veredicto errado, abra uma issue. As correções entram na próxima versão e nesta tabela.
Vamos refazer a comparação conforme novos estilos e idiomas forem lançados, e quando os modelos forem atualizados.
Perguntas frequentes
Qual é o melhor modelo de IA para gerar imagens com texto em 2026?
No nosso teste com 2.016 imagens, GPT Image 2.5 e Nano Banana 2.1 empataram no topo, escrevendo certo 401 e 402 de 404 palavras. A diferença entre eles é de uma imagem, então vale como empate. Os dois ficaram acima de 95% em todos os sistemas de escrita testados, inclusive o árabe.
Qual modelo de IA de imagem é melhor para texto em japonês ou árabe?
GPT Image e Nano Banana. Em japonês, os dois acertaram 58 ou 59 de 59 palavras, contra 45 a 52 dos outros três modelos. Em árabe, marcaram 96% e 100%, enquanto Grok Imagine ficou com 71%, Seedream com 57% e Qwen-Image com 11%.
Por que o Qwen-Image erra o texto?
Principalmente porque acrescenta texto que ninguém pediu. Em 40 dos seus erros, o Qwen-Image escreveu a palavra pedida corretamente e depois encheu a imagem com um parágrafo de letras extras, muitas vezes uma cópia embaralhada do próprio prompt. Rodar o mesmo prompt de novo raramente resolve.
Os dados do teste são públicos?
Sim. Todas as imagens, prompts, veredictos e notas de revisão estão no dataset de renderização de texto da AIFont, no GitHub e no Zenodo, sob CC BY 4.0, e qualquer pessoa pode enviar uma correção.
Copie um prompt, cole no ChatGPT, no Gemini ou em qualquer modelo de imagem e troque o texto pelo seu.
Ver todas as fontes com IA