Bestes KI-Bildmodell für Text (Test 2026)
5 KI-Bildmodelle, dieselben 59 Prompts in 7 Sprachen. GPT Image und Nano Banana schrieben 99 % richtig, Qwen-Image 79 %.
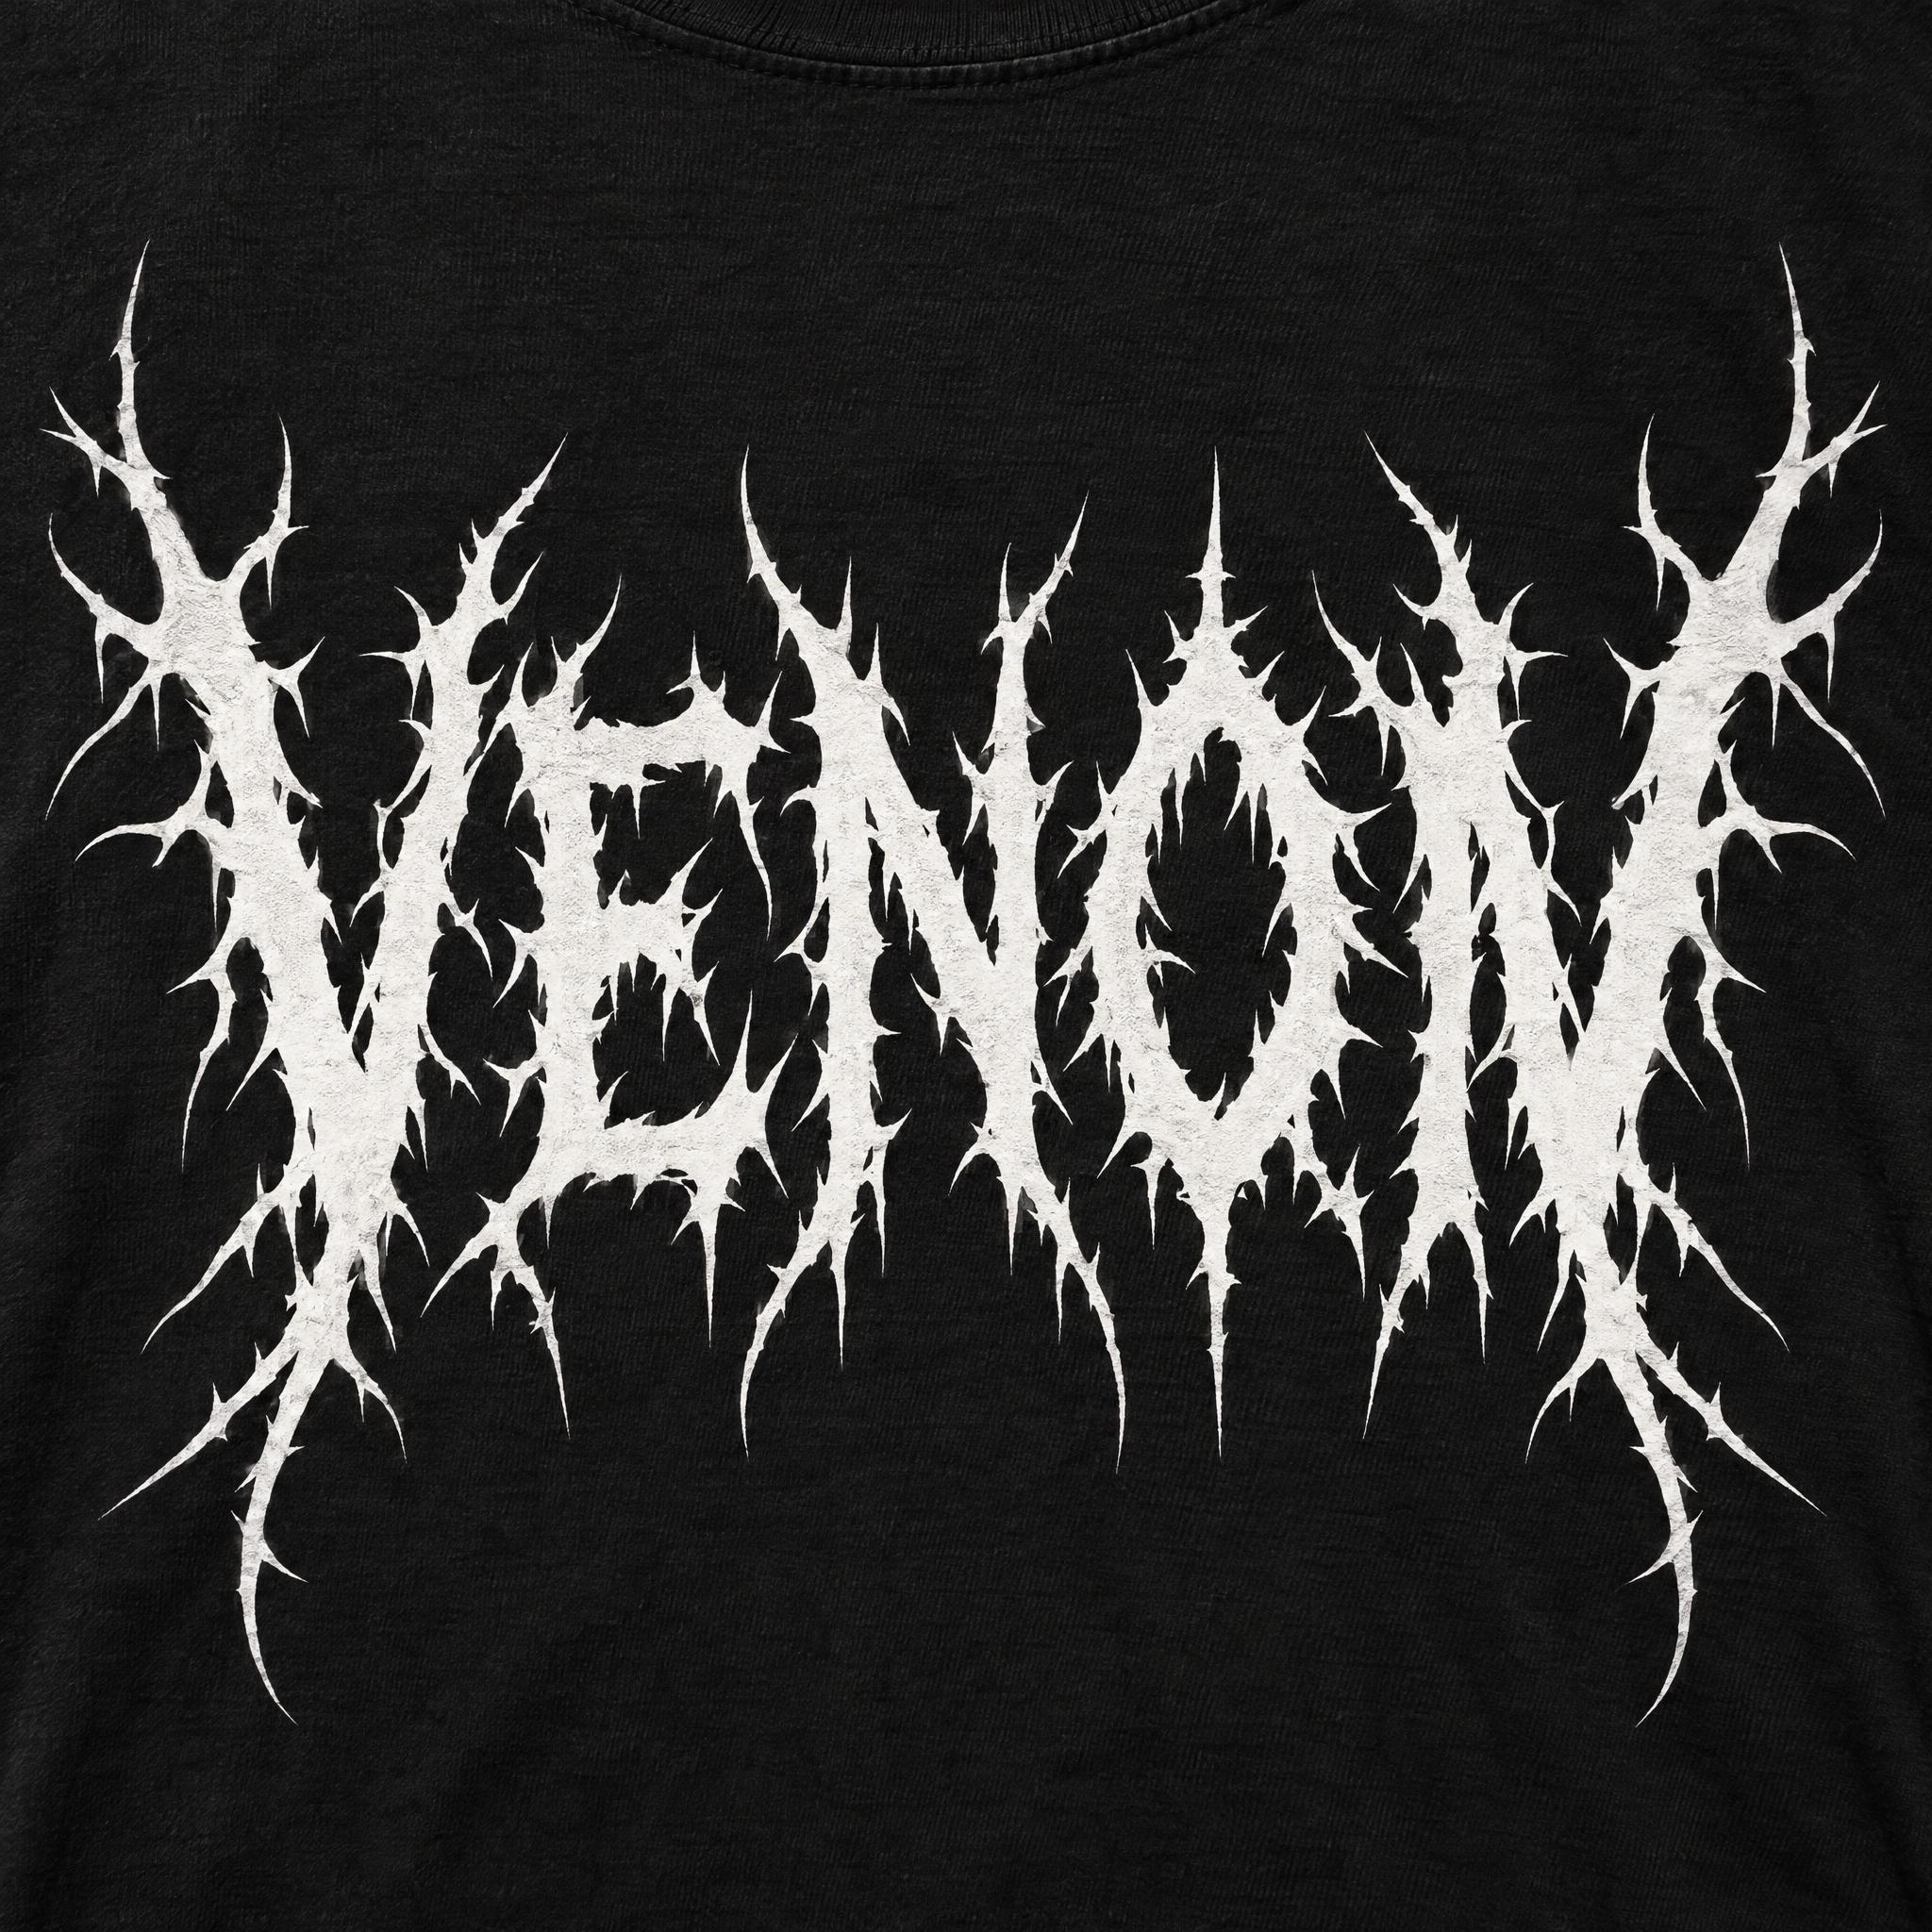
Bitte ein KI-Bildmodell um ein Death-Metal-T-Shirt mit dem Schriftzug VENOM, und das beste Modell in unserem Test druckt VENON. Das war einer von nur drei Rechtschreibfehlern, die GPT Image in 404 Bildern gemacht hat. Qwen-Image machte 86.
Beim Text trennen sich die Bildmodelle bis heute. Ein Modell rendert Chrom, Farbtropfen und Studiolicht, die als Foto durchgehen, setzt dann einen Punkt falsch und macht aus einem Wort ein anderes. Wir bauen beruflich KI-Schrift-Prompts, also läuft jeder Prompt, den wir veröffentlichen, auf fünf Modellen, und jedes Bild wird Buchstabe für Buchstabe geprüft. Nach 59 Stilen ergab diese Prüfarbeit den folgenden Vergleich der KI-Bildmodelle.
Das beste KI-Bildmodell für Text: die Kurzfassung
| Schrift | GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image |
|---|---|---|---|---|---|
| Lateinisch (Englisch, Deutsch, Spanisch, Portugiesisch) | 235/236 | 235/235 | 229/235 | 230/235 | 213/235 |
| Chinesisch | 59/59 | 58/59 | 58/59 | 56/59 | 56/59 |
| Japanisch | 59/59 | 58/59 | 52/59 | 51/59 | 45/59 |
| Arabisch | 48/50 | 51/51 | 35/49 | 27/47 | 6/53 |
| Gesamt | 99 % | 100 % | 93 % | 91 % | 79 % |
- GPT Image 2.5 und Nano Banana 2.1 sind die besten Bildmodelle für Text. Je zwei oder drei Fehler in rund 400 Bildern, in jeder Schrift.
- Grok Imagine 2.0 und Seedream 5.0 Pro kommen mit lateinischer Schrift und Chinesisch zurecht, patzen beim Japanischen und brechen beim Arabischen ein.
- Qwen-Image 3.0 Pro ist das einzige Modell, das schon bei gewöhnlichen Wörtern im lateinischen Alphabet Punkte verliert, und im Arabischen kam es auf 6 von 53.
So haben wir getestet
Jeder der 59 Stile ist ein veröffentlichter AIFont-Prompt, etwa Textura, Paint Splatter oder Tagging Letters. Jeder Stil hat pro Sprache einen Prompt mit einem kurzen Schriftzug in dieser Sprache: FRESH, Reino, ばくはつ, كعك.
- Derselbe Prompt für jedes Modell. Jedes Modell bekam für jeden Stil und jede Sprache exakt denselben Prompt-Text. Gezählt haben wir nur das erste Bild, das jedes Modell lieferte, ohne ausgesuchte Wiederholungen.
- Einstellungen: 2K, quadratisch, über die API des jeweiligen Anbieters, 22.–29. Oktober 2026. GPT Image lief mit der Qualitätsstufe xhigh, Grok Imagine mit medium, seiner höchsten; die anderen drei haben keine Qualitätseinstellung.
- Modelle: GPT Image 2.5 (OpenAI), Nano Banana 2.1 (Google), Grok Imagine Image 2.0 (xAI), Seedream 5.0 Pro (ByteDance), Qwen-Image 3.0 Pro (Alibaba).
- Bewertung: Jedes Bild wurde von einem KI-Prüfer gelesen, bei Chinesisch, Japanisch und Arabisch vergrößert. 489 der gewerteten Bilder hat zusätzlich ein Mensch geprüft: jedes Bild, das die KI als falsch oder unsicher markiert hatte, den Großteil der arabischen Bilder und eine Zufallsstichprobe der übrigen.
- Was als falsch zählt: Ein Wort ist nur dann falsch, wenn man sagen kann, was stattdessen dasteht (VENON statt VENOM). Stilisierte Buchstabenformen, Zierstriche und abweichende Groß- und Kleinschreibung zählen als richtig. Zusätzliche Wörter, die der Prompt nie verlangt hat, zählen als falsch.
Das ergab 2.057 Bilder aus dem ersten Versuch. 41 arabische Bilder sind ausgenommen, weil KI und menschlicher Prüfer uneins waren und keiner von beiden Arabisch als Muttersprache liest. Gewertet wurden 2.016 Bilder.
Lateinische Schrift und Chinesisch: alle fünf Modelle bestehen
Jedes Modell lag bei Englisch, Deutsch, Spanisch, Portugiesisch und Chinesisch über 90 %. Ist dein Text kurz und in einer dieser Sprachen, trifft ihn jedes der fünf Modelle meist schon beim ersten Versuch.
Die einzige Ausnahme ist Qwen-Image bei Spanisch und Portugiesisch, wo es pro Sprache 9 bis 10 Wörter falsch schrieb. Sein typischer Fehler ist kein Tippfehler.
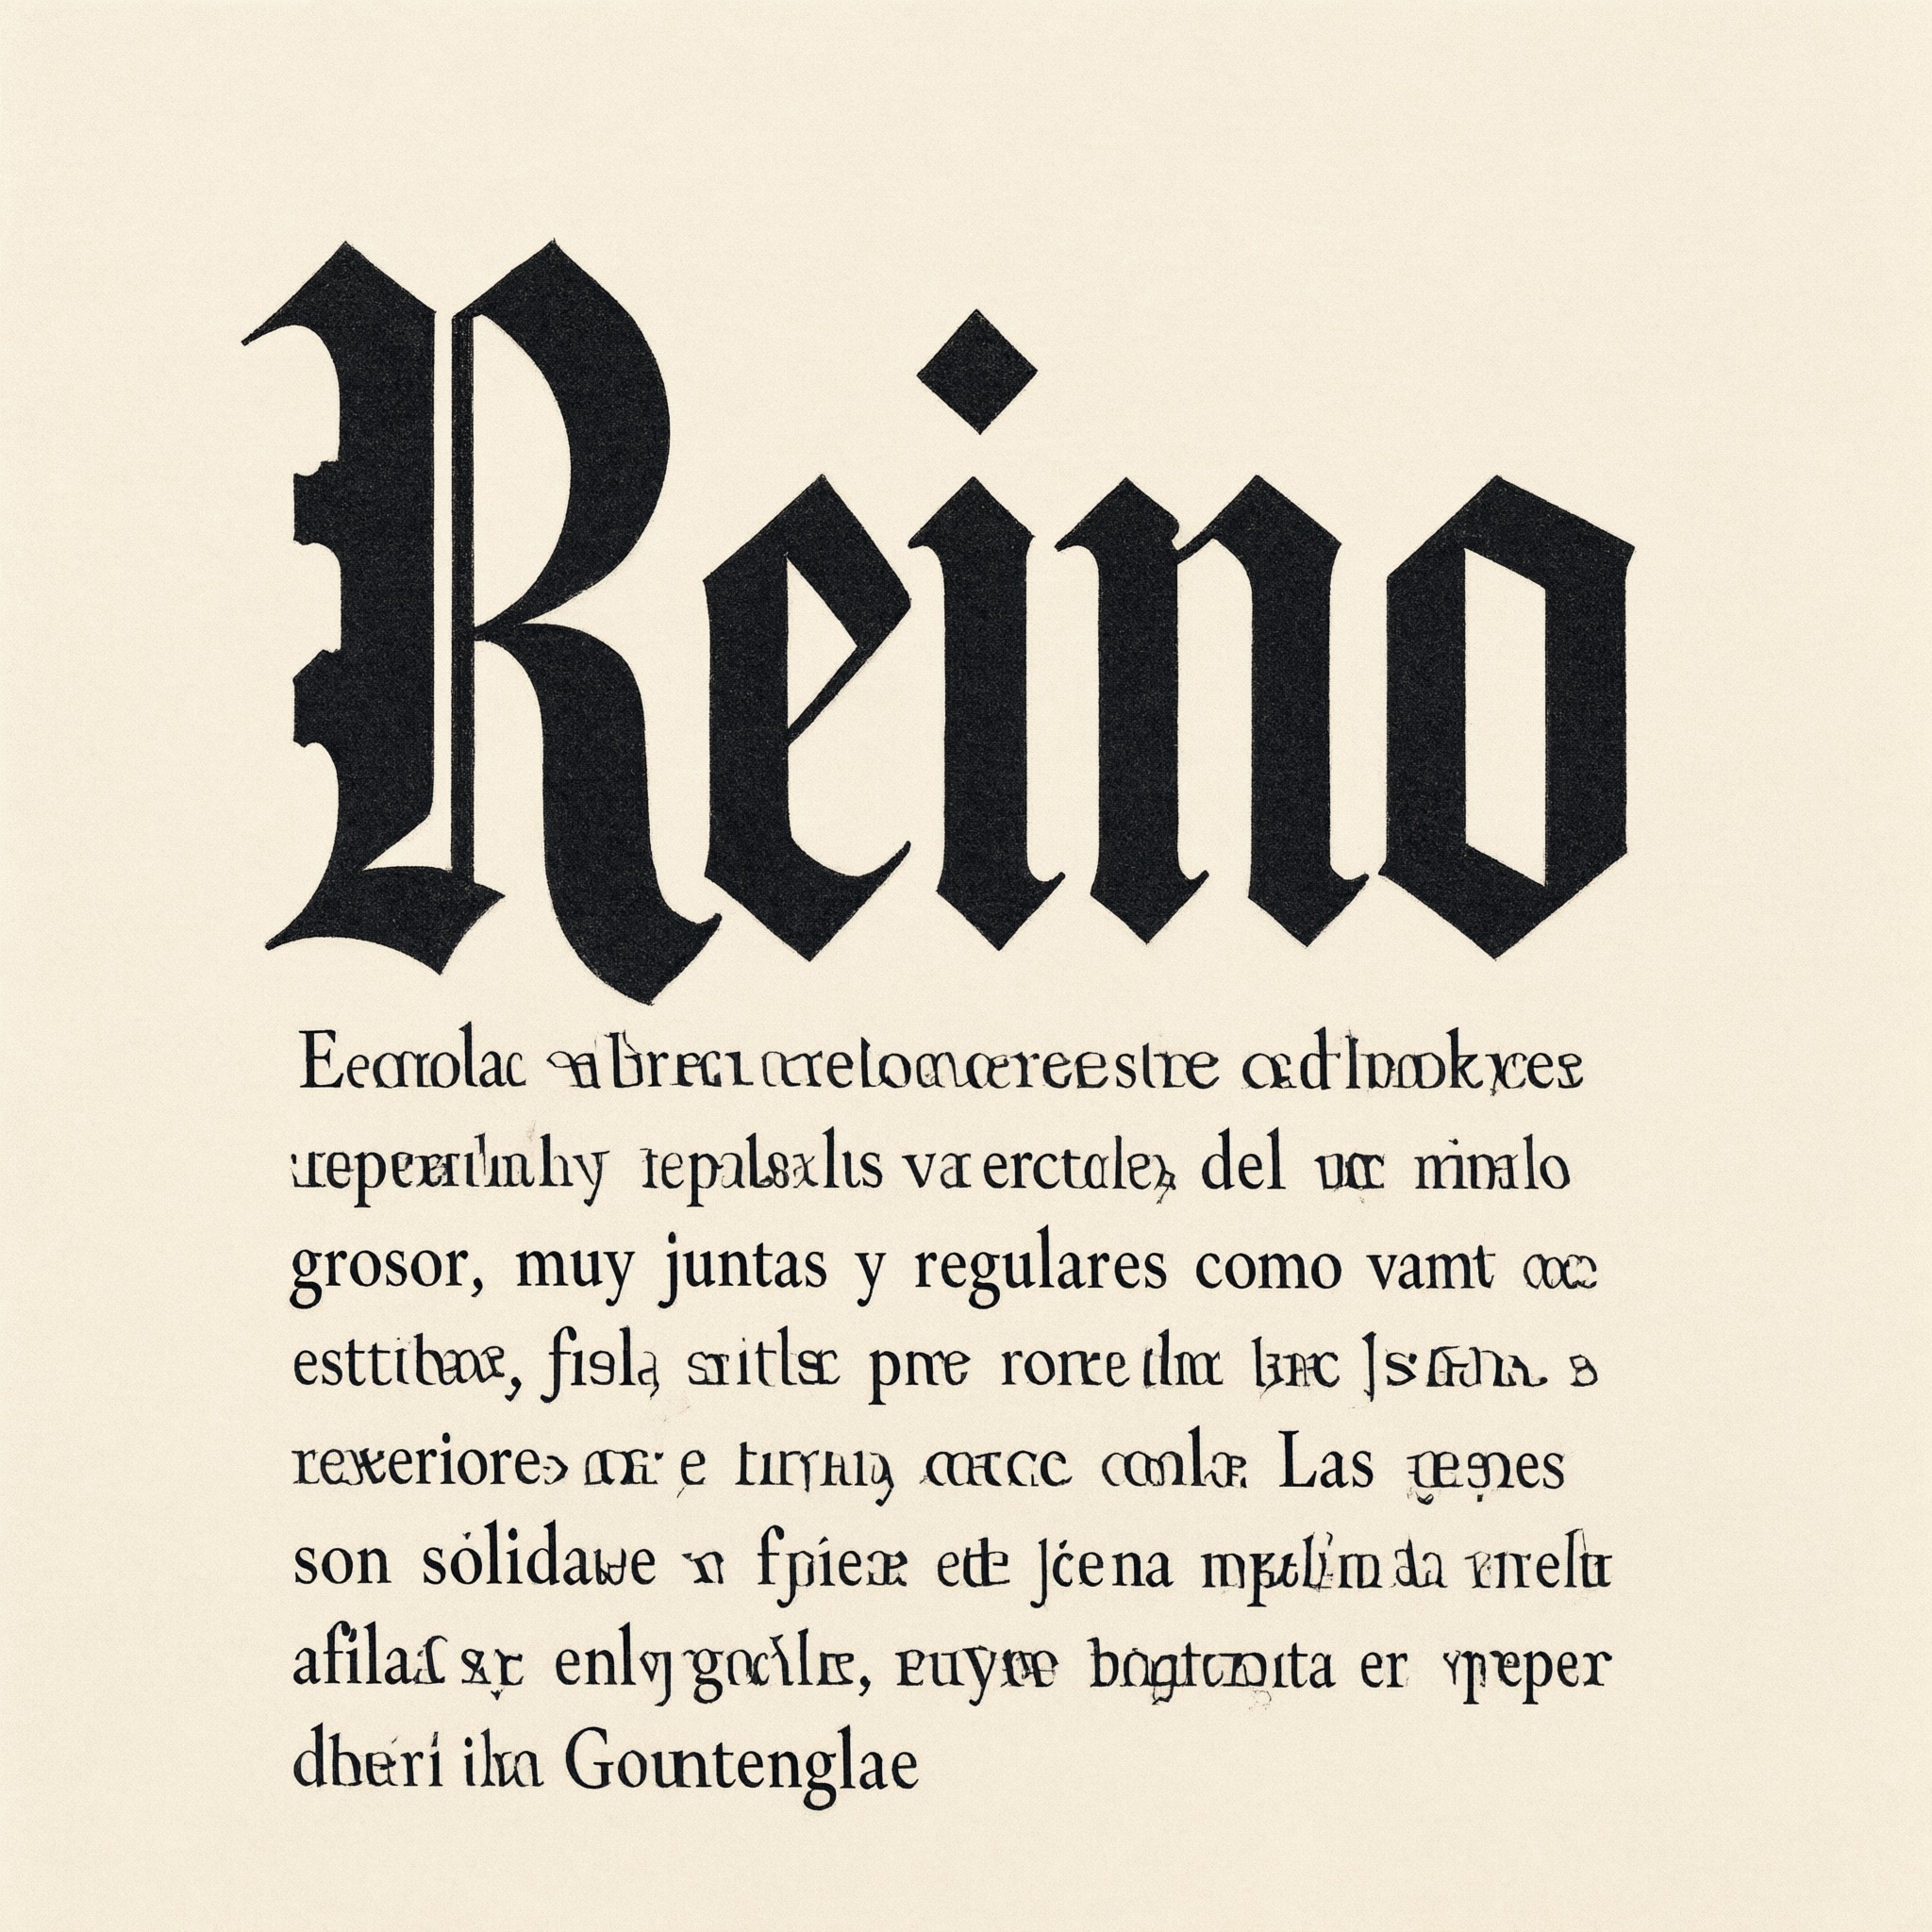
Dieses Muster, das gewünschte Wort plus ein Block nicht verlangten Texts, macht 40 der 86 Fehler von Qwen-Image aus. Der zusätzliche Text ist oft eine durcheinandergewürfelte Kopie des Prompts selbst.
Japanisch: hier öffnet sich die Lücke
| GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image | |
|---|---|---|---|---|---|
| Japanisch | 59/59 | 58/59 | 52/59 | 51/59 | 45/59 |
Japanische Kana haben kleine Zeichen, die das Wort verändern: zwei Striche (Dakuten) machen aus は ein ば. Bei unserem Paint-Splatter-Prompt setzten Grok Imagine und Seedream beide Dakuten an Stellen, an die sie nicht gehören.
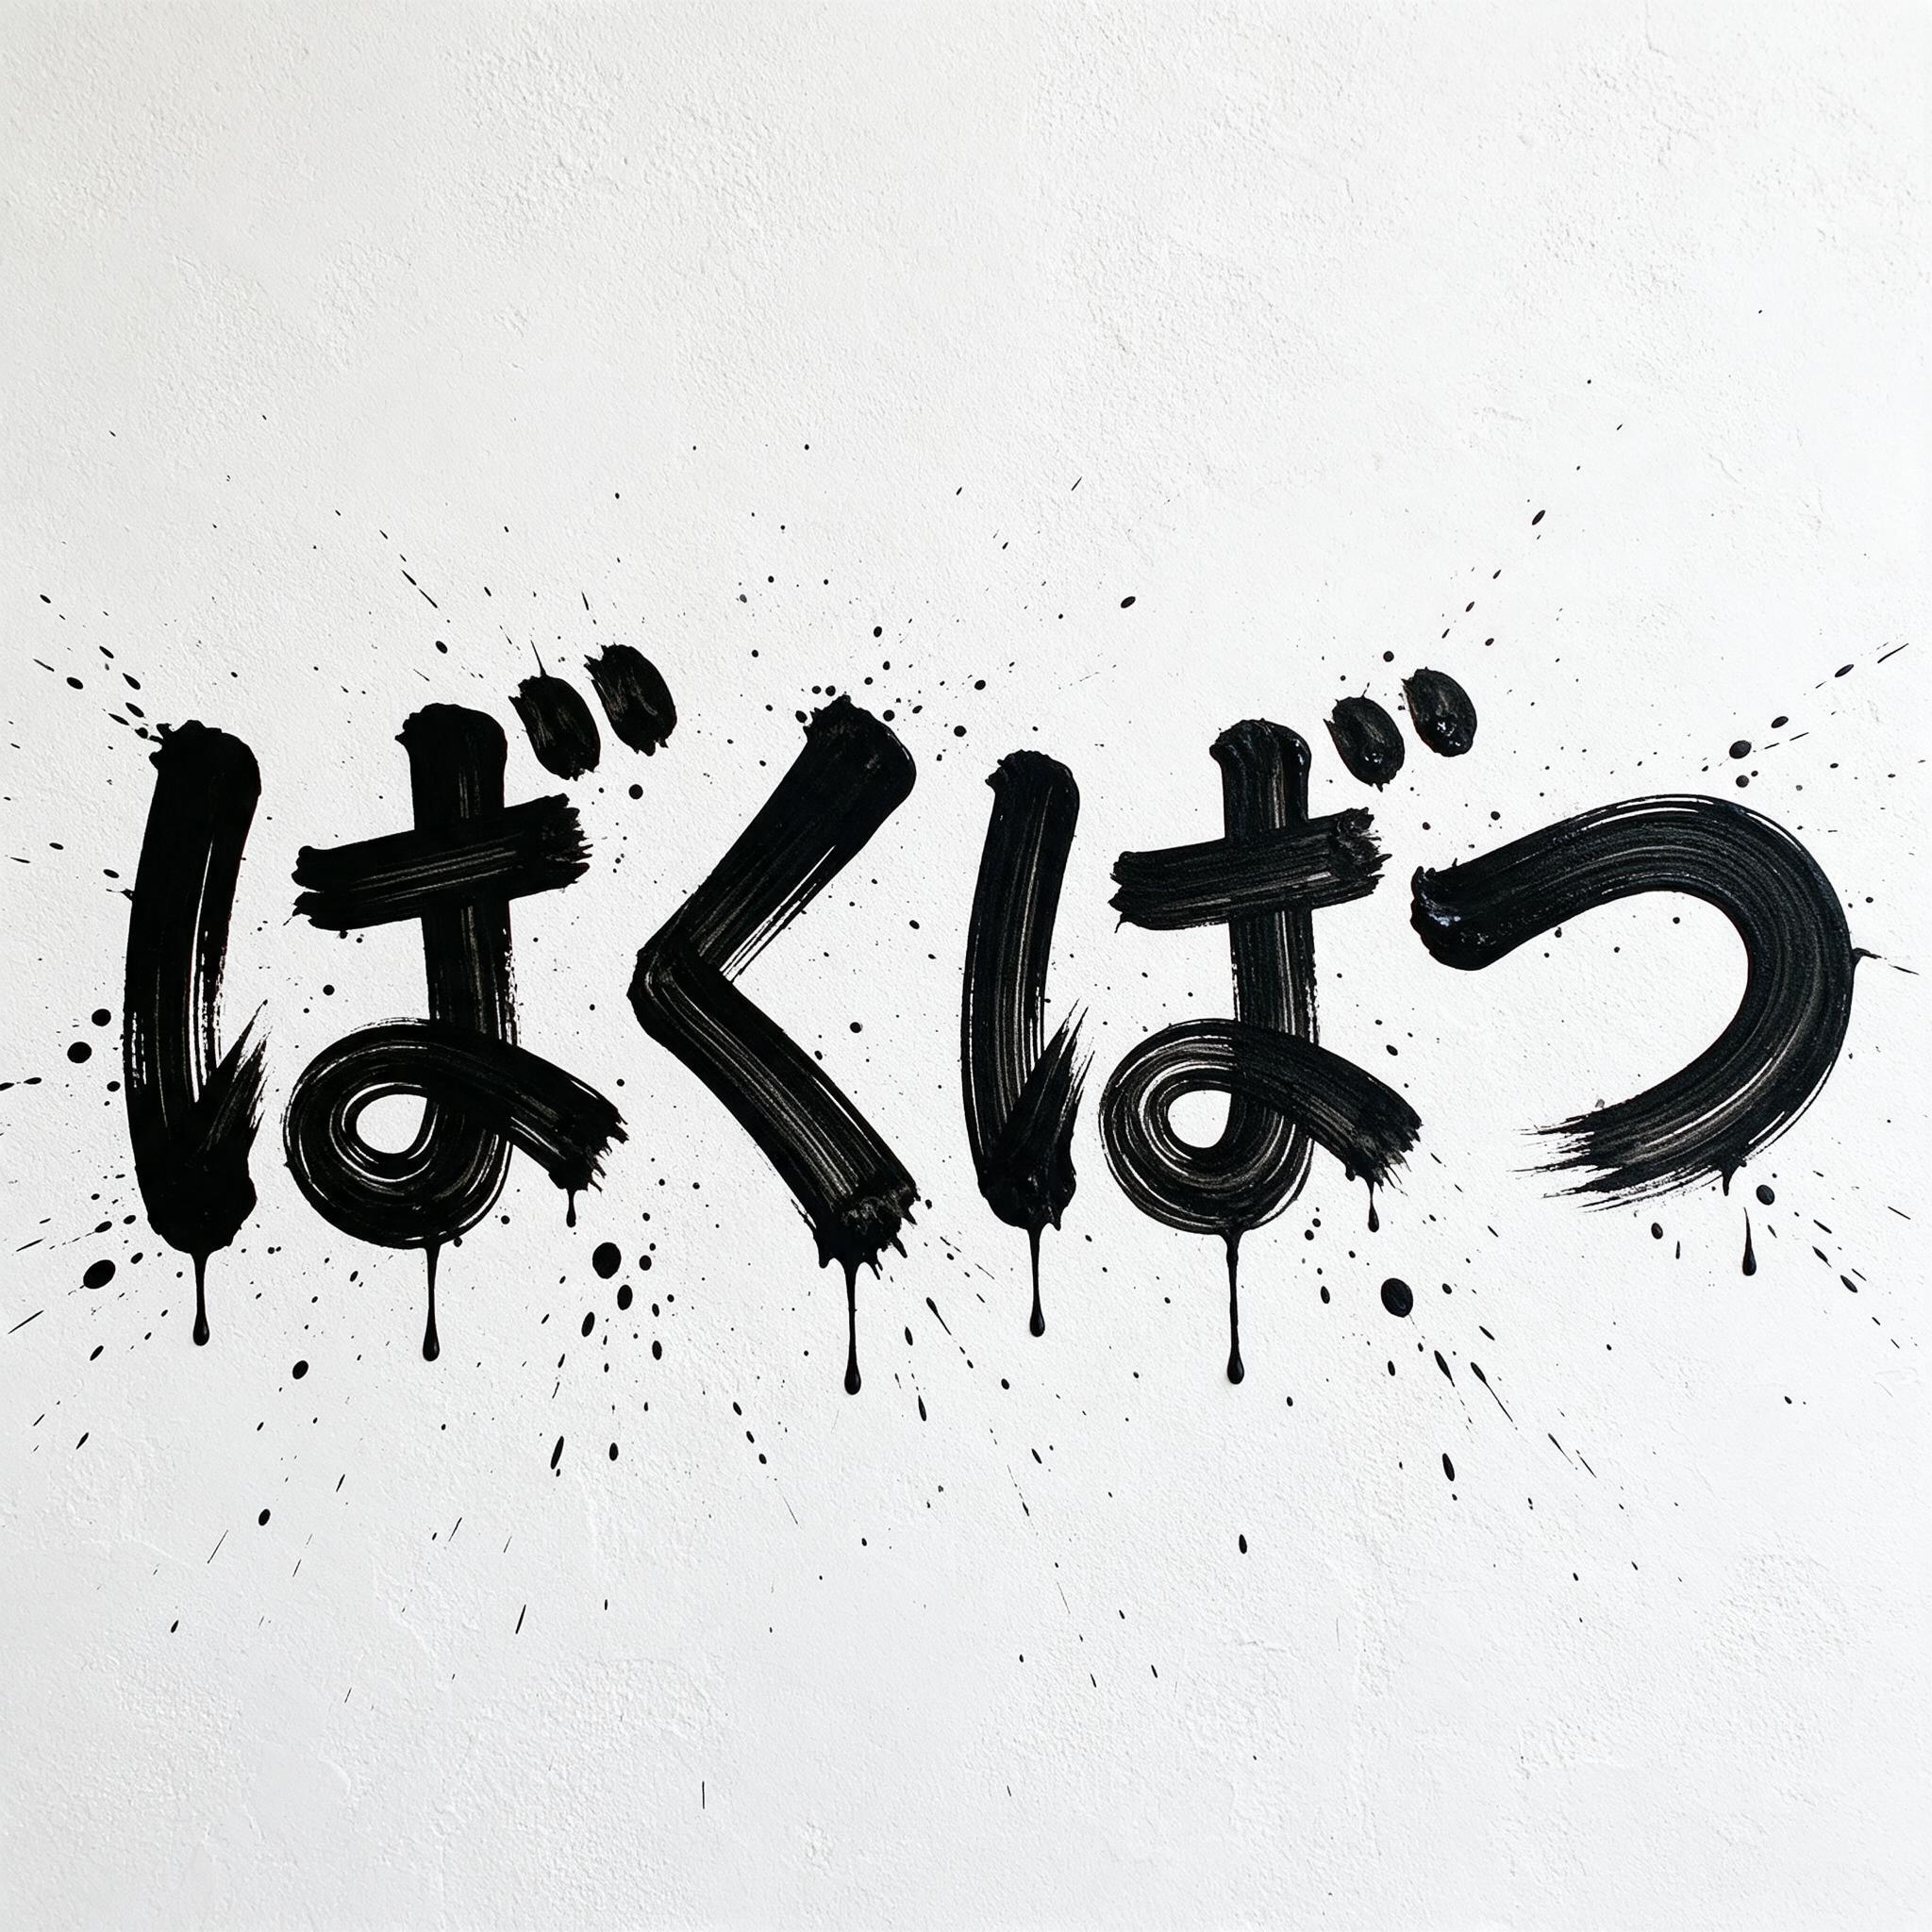
Die übrigen japanischen Fehler von Grok Imagine und Seedream folgen demselben Muster: ein Zeichen daneben, kein unleserliches Wort. Grok schrieb ストリトト statt ストリート, ジングス statt ジンクス und ぼうげん statt ぼうけん; Seedream schrieb かくどう statt かくとう und ねがいの statt ねがい. Wer Japanisch liest, sieht jeden dieser Fehler sofort.
Arabisch: nur zwei Modelle halten stand
| GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image | |
|---|---|---|---|---|---|
| Arabisch | 48/50 (96 %) | 51/51 (100 %) | 35/49 (71 %) | 27/47 (57 %) | 6/53 (11 %) |
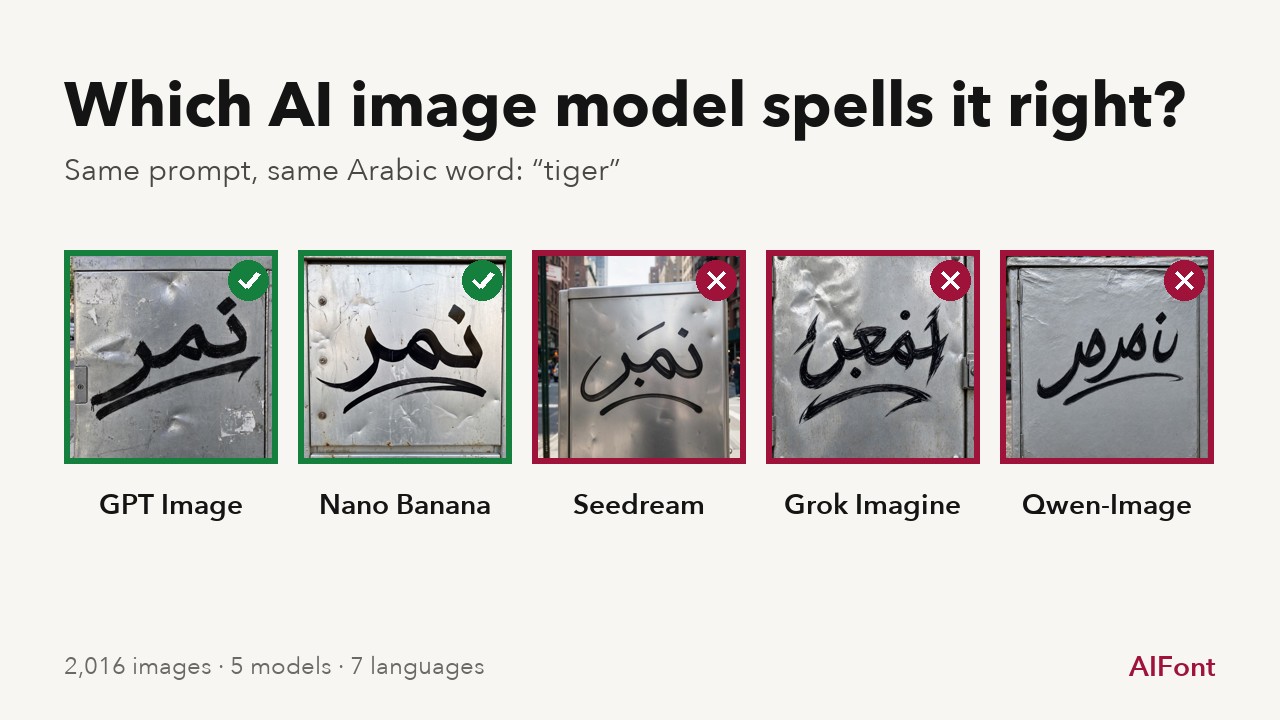
Arabisch ist die schwierigste Schrift in diesem Test. Die Buchstaben werden verbunden, ändern ihre Form je nach Position, und viele unterscheiden sich nur durch Anzahl oder Lage ihrer Punkte. Ein einziger Prompt zeigt die ganze Spannweite: das Wort نمر (Tiger) als Graffiti auf einem Verteilerkasten an der Straße.
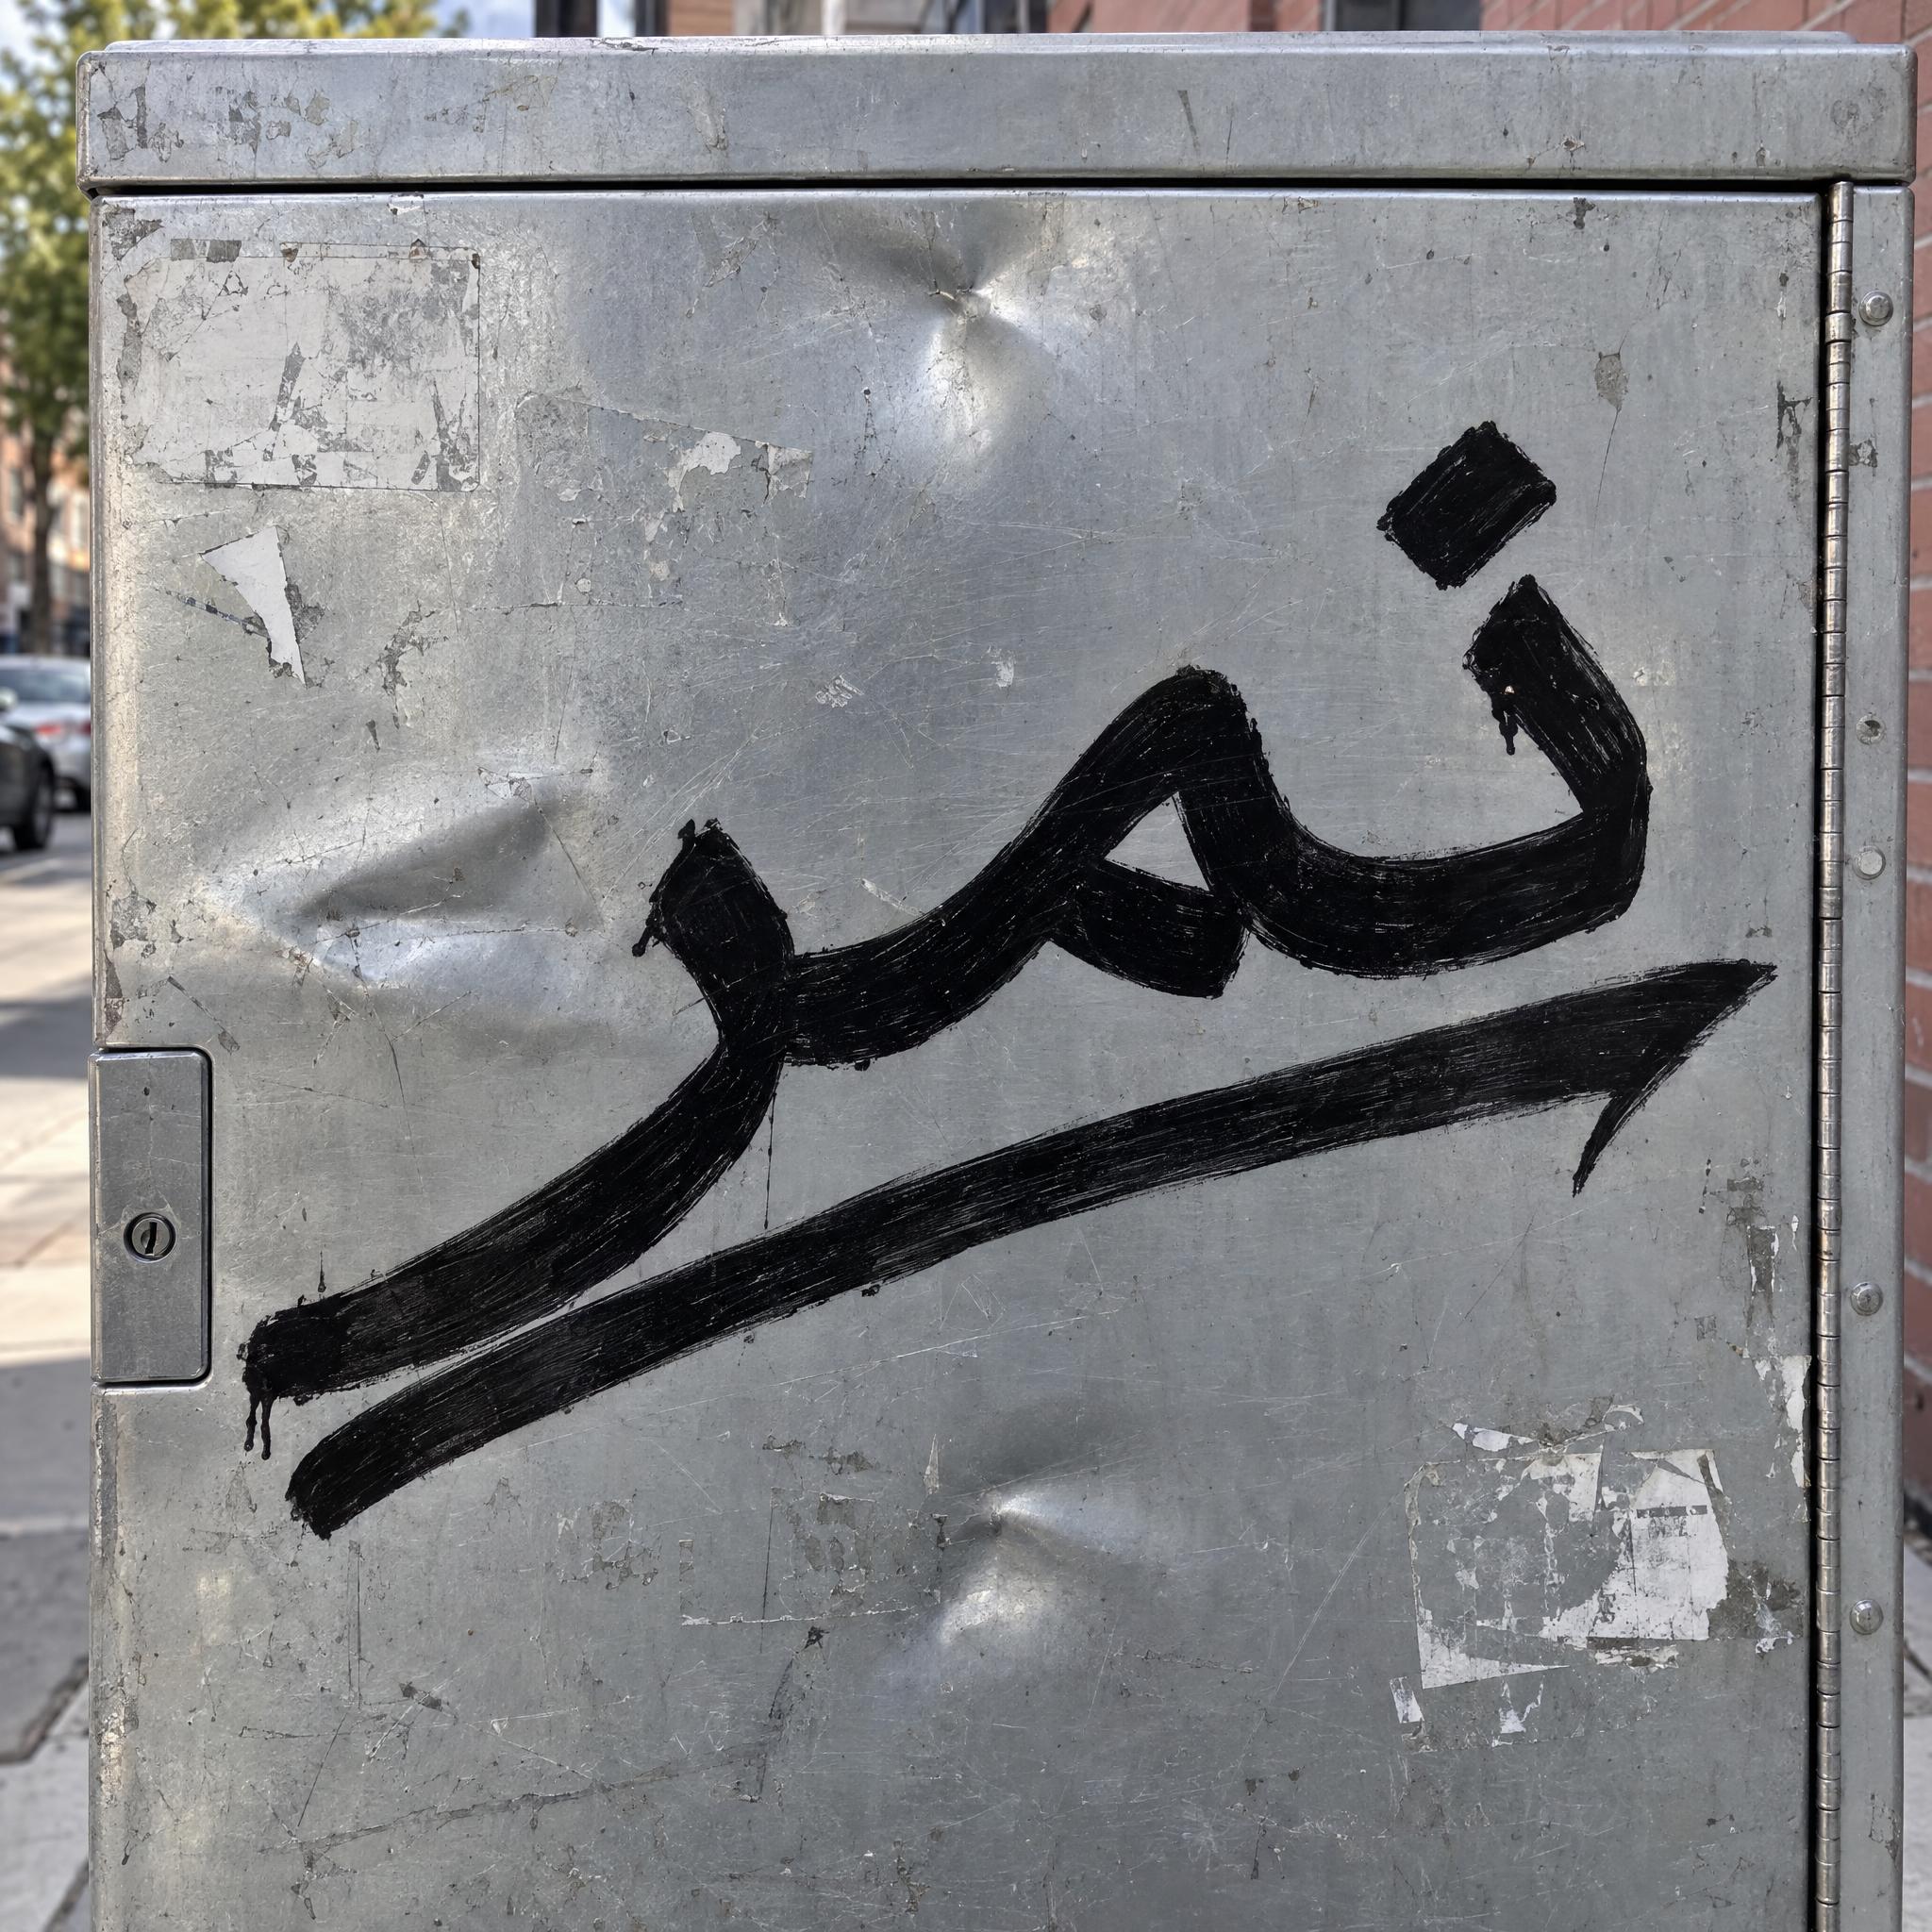
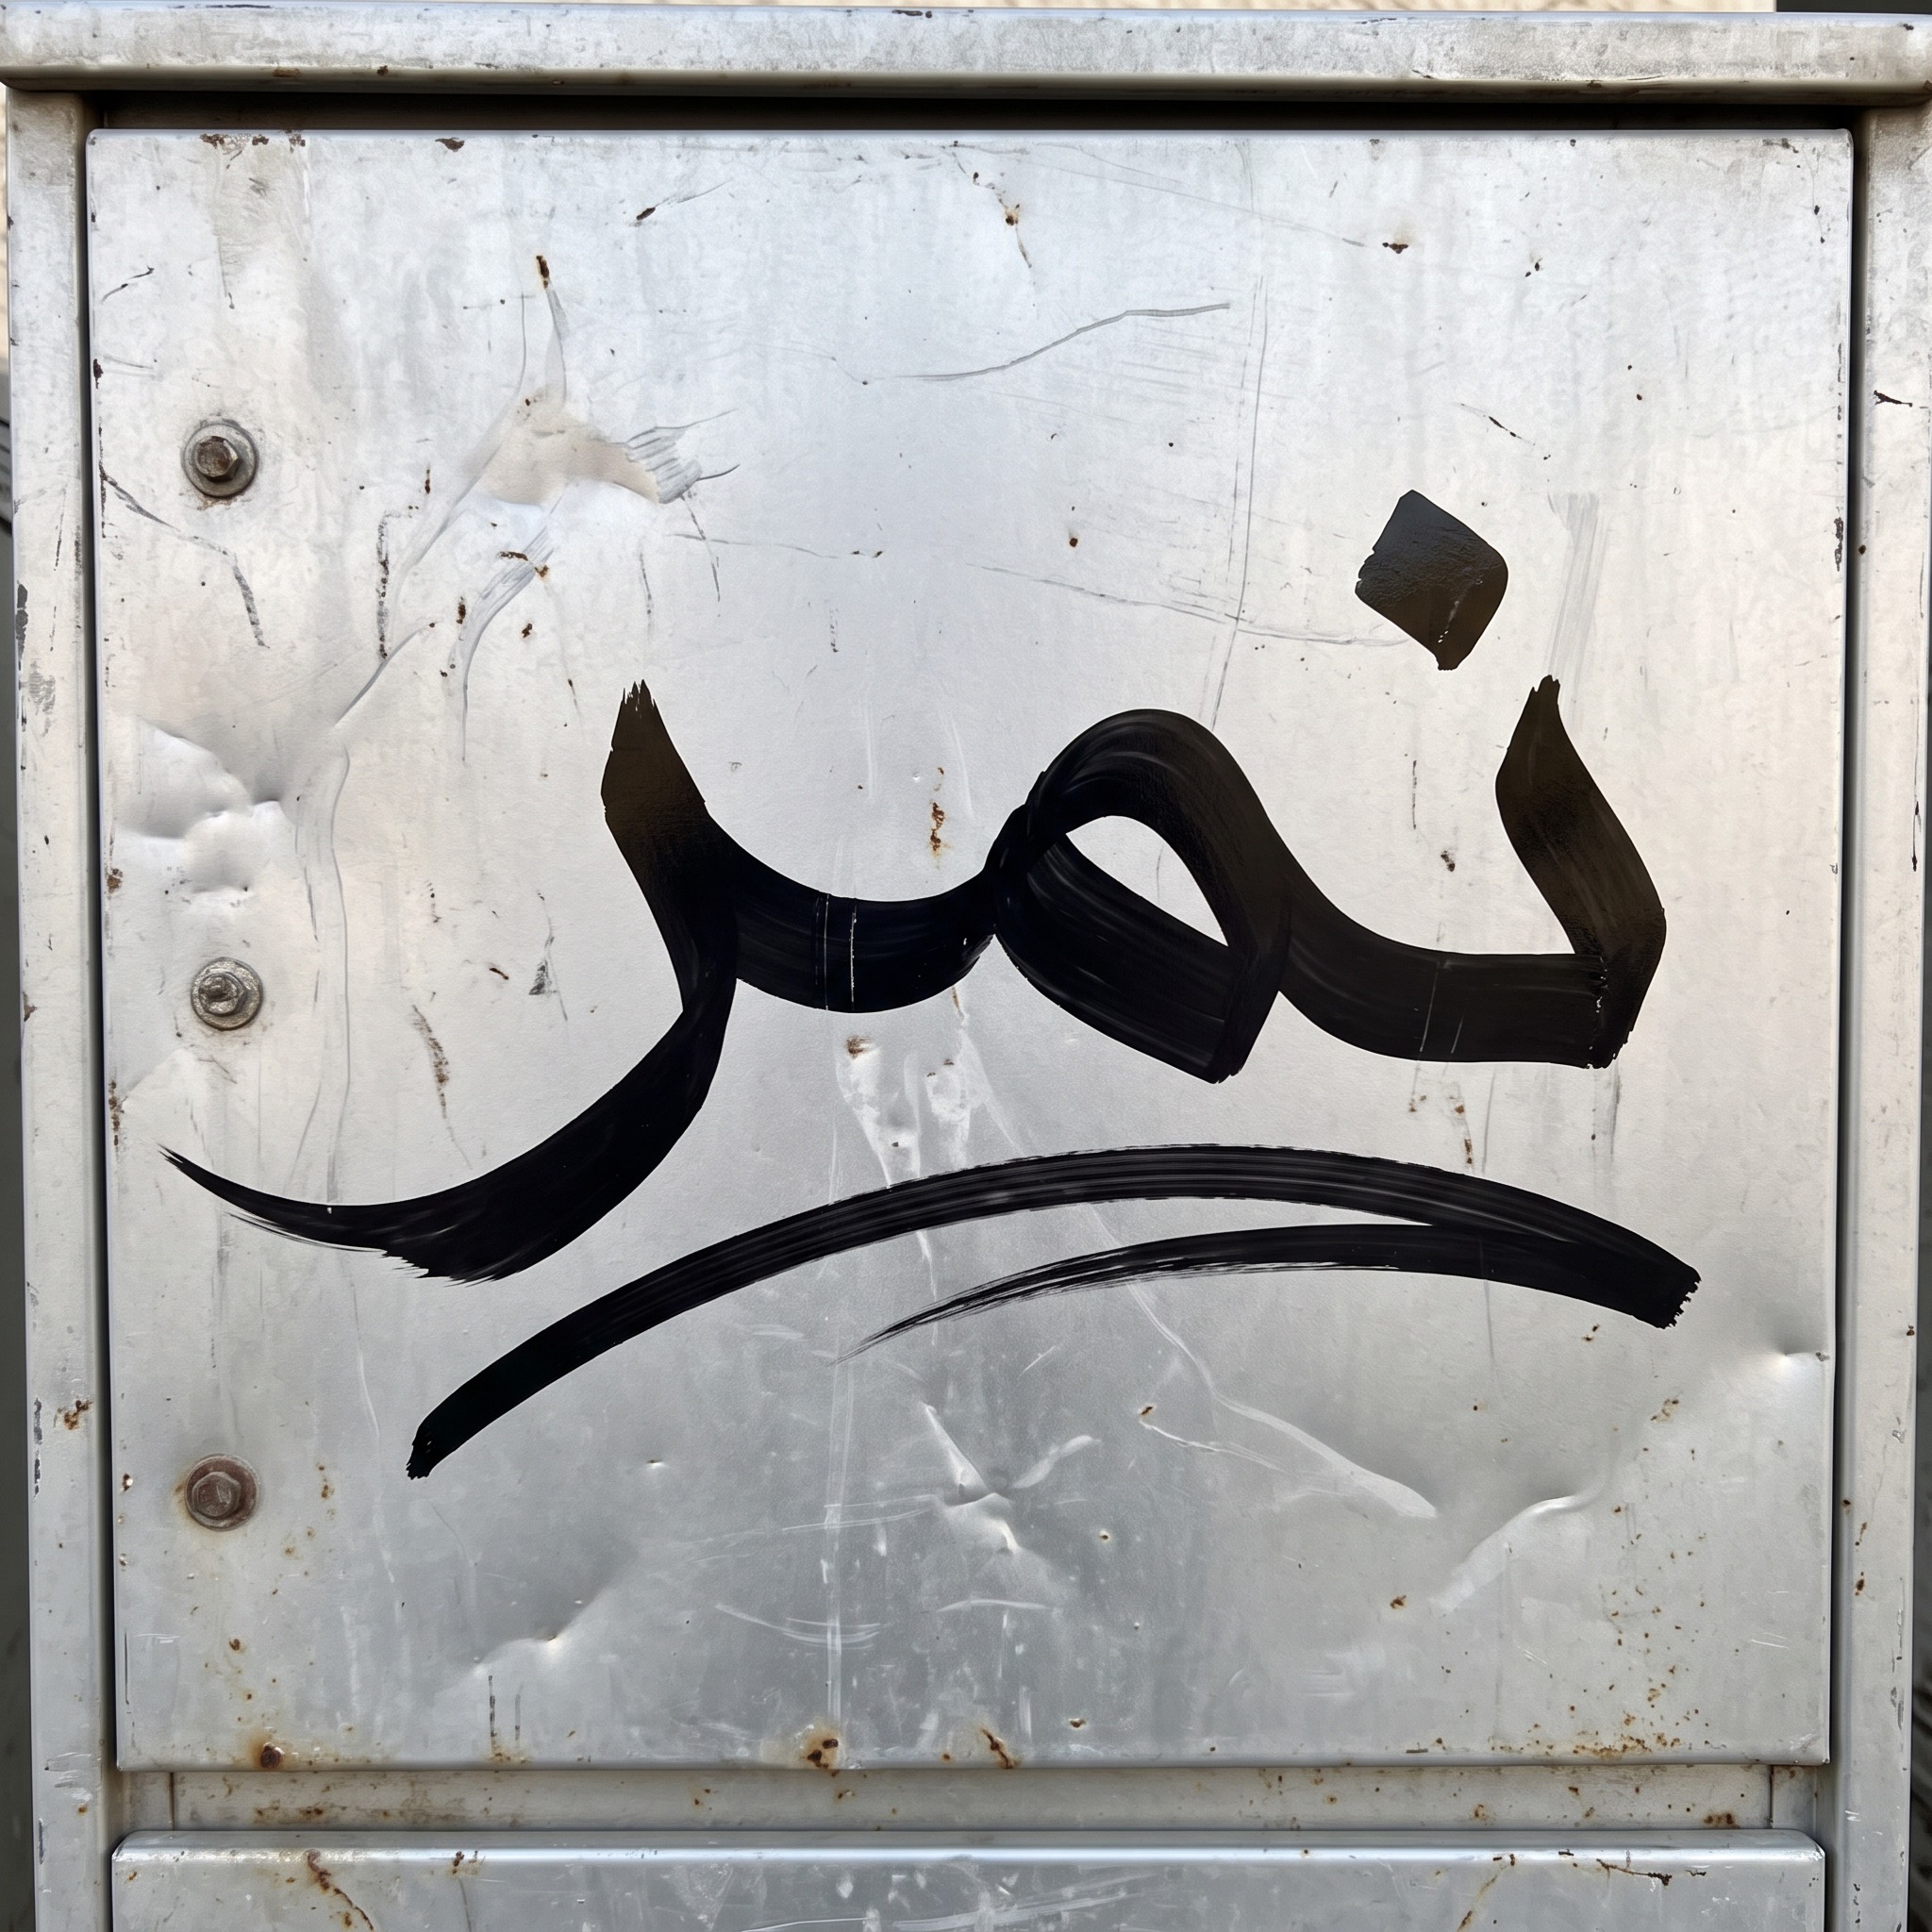
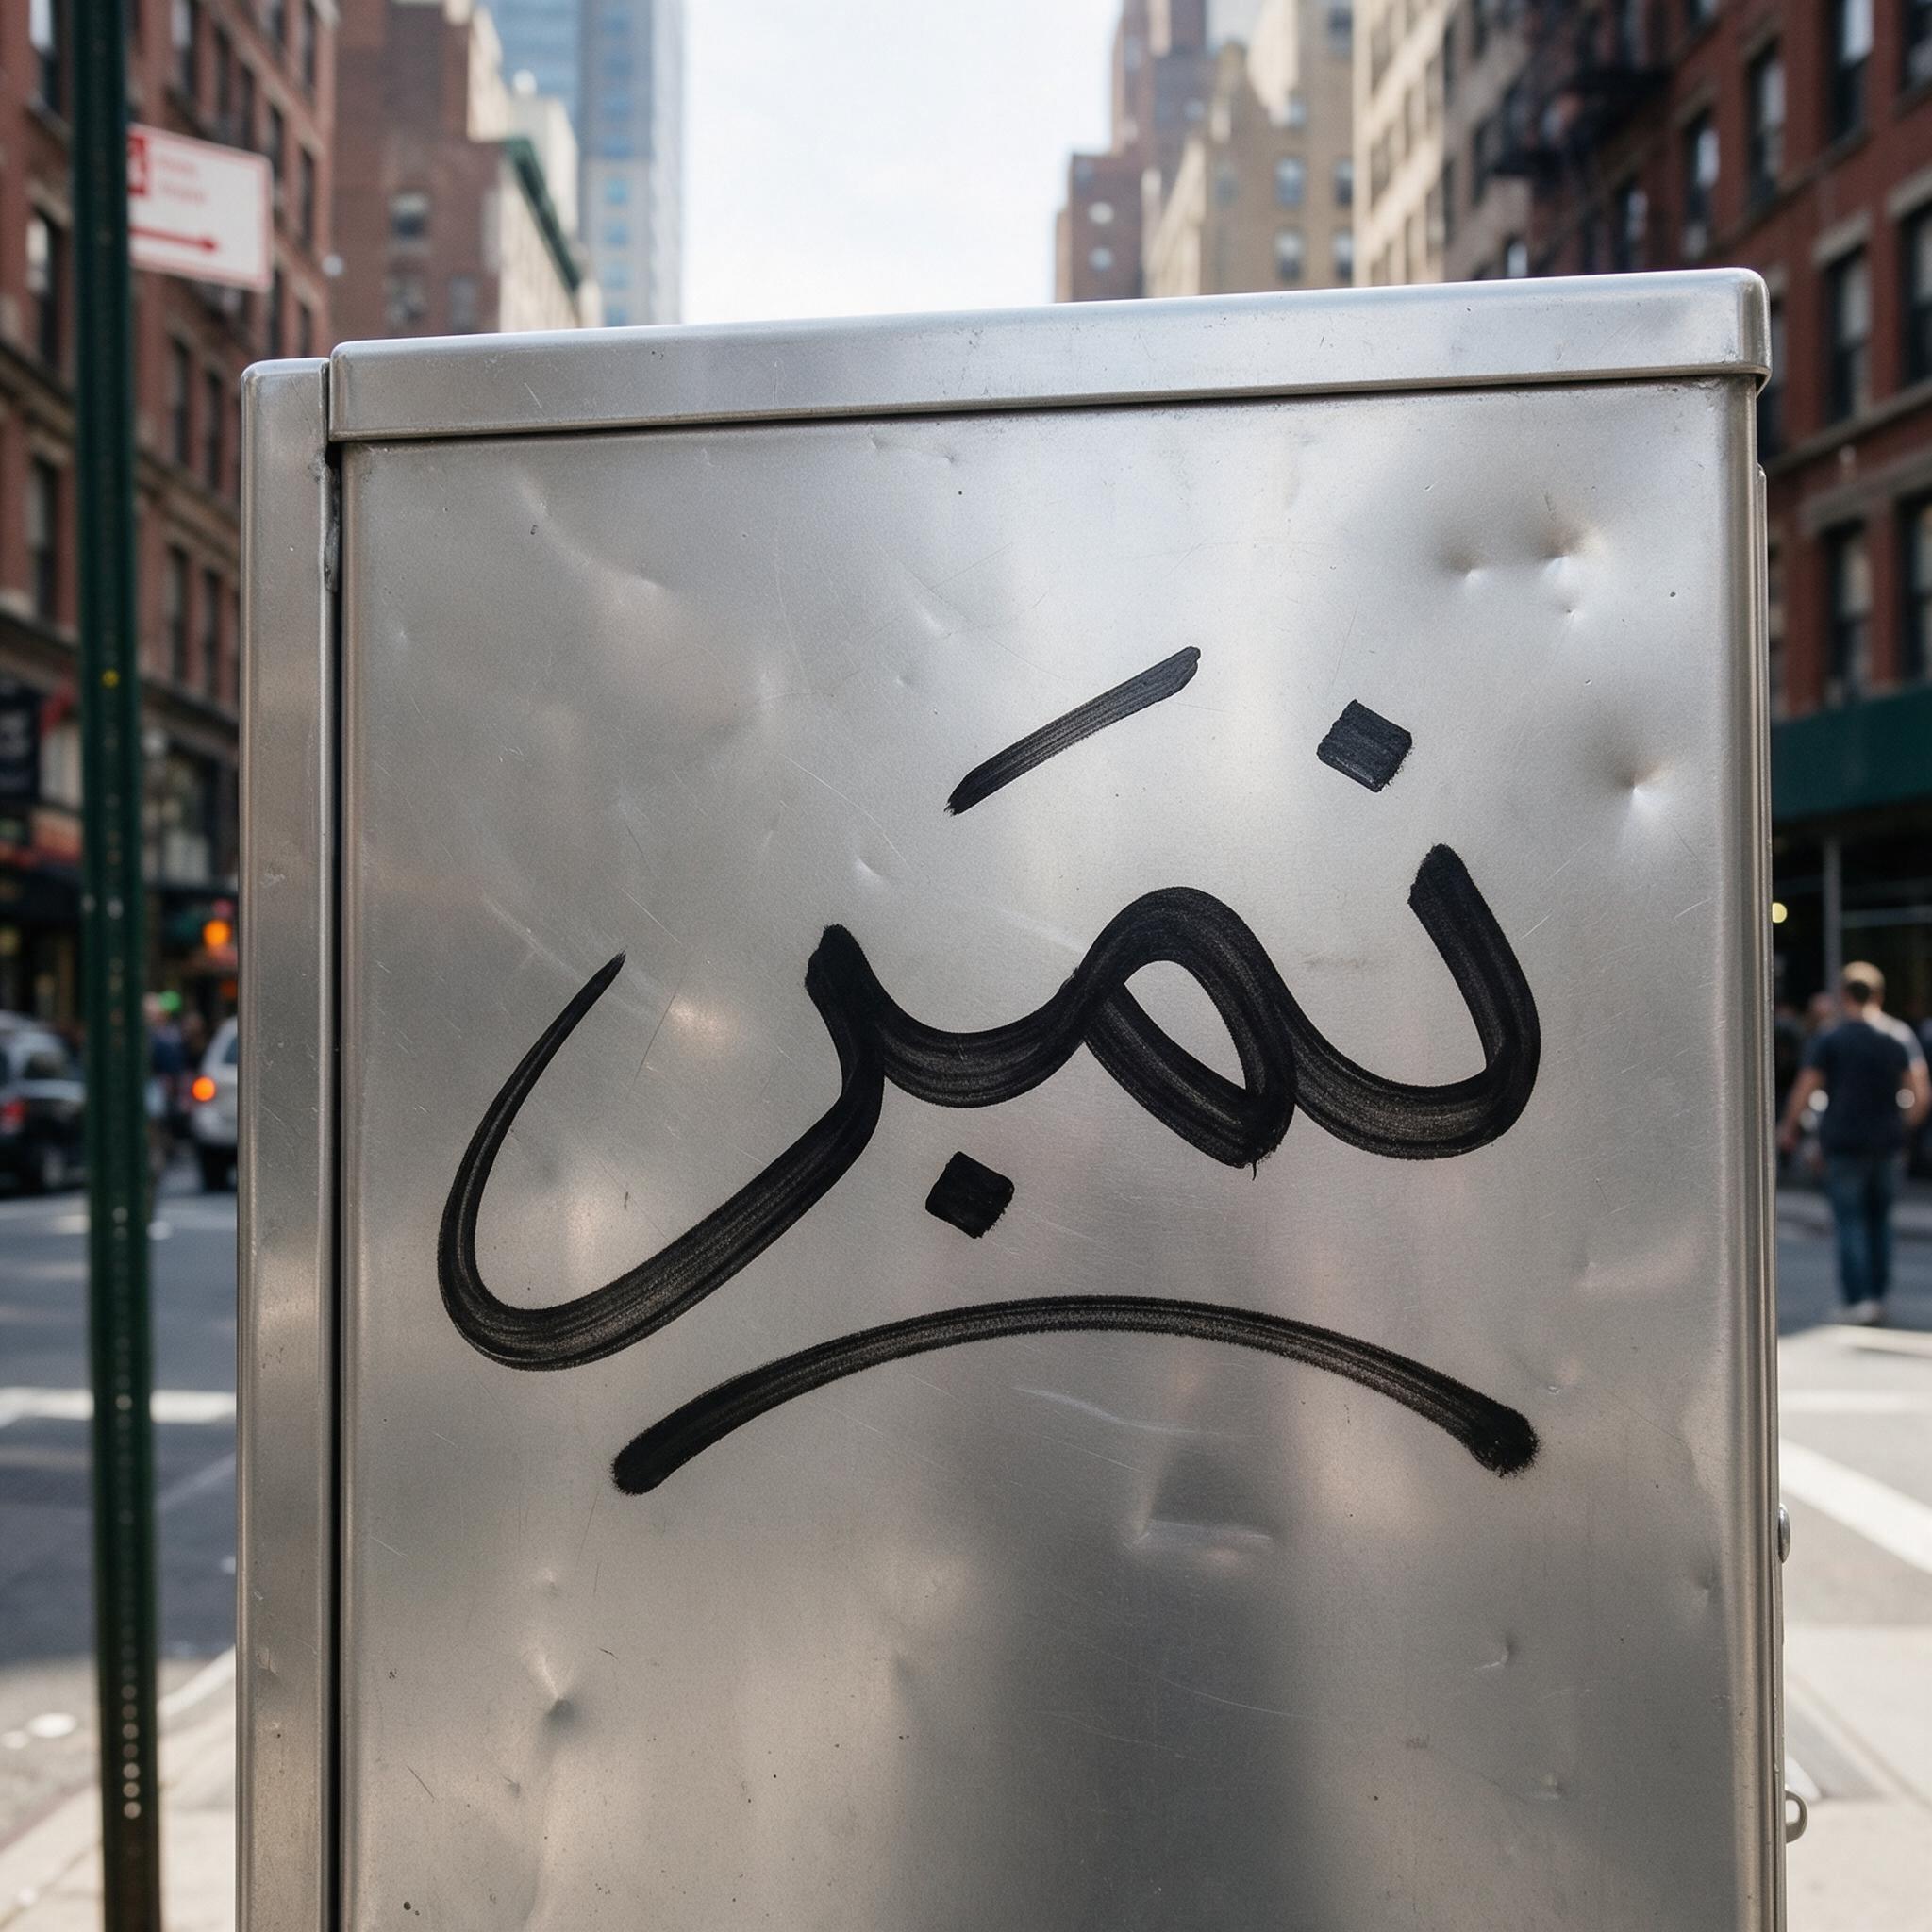
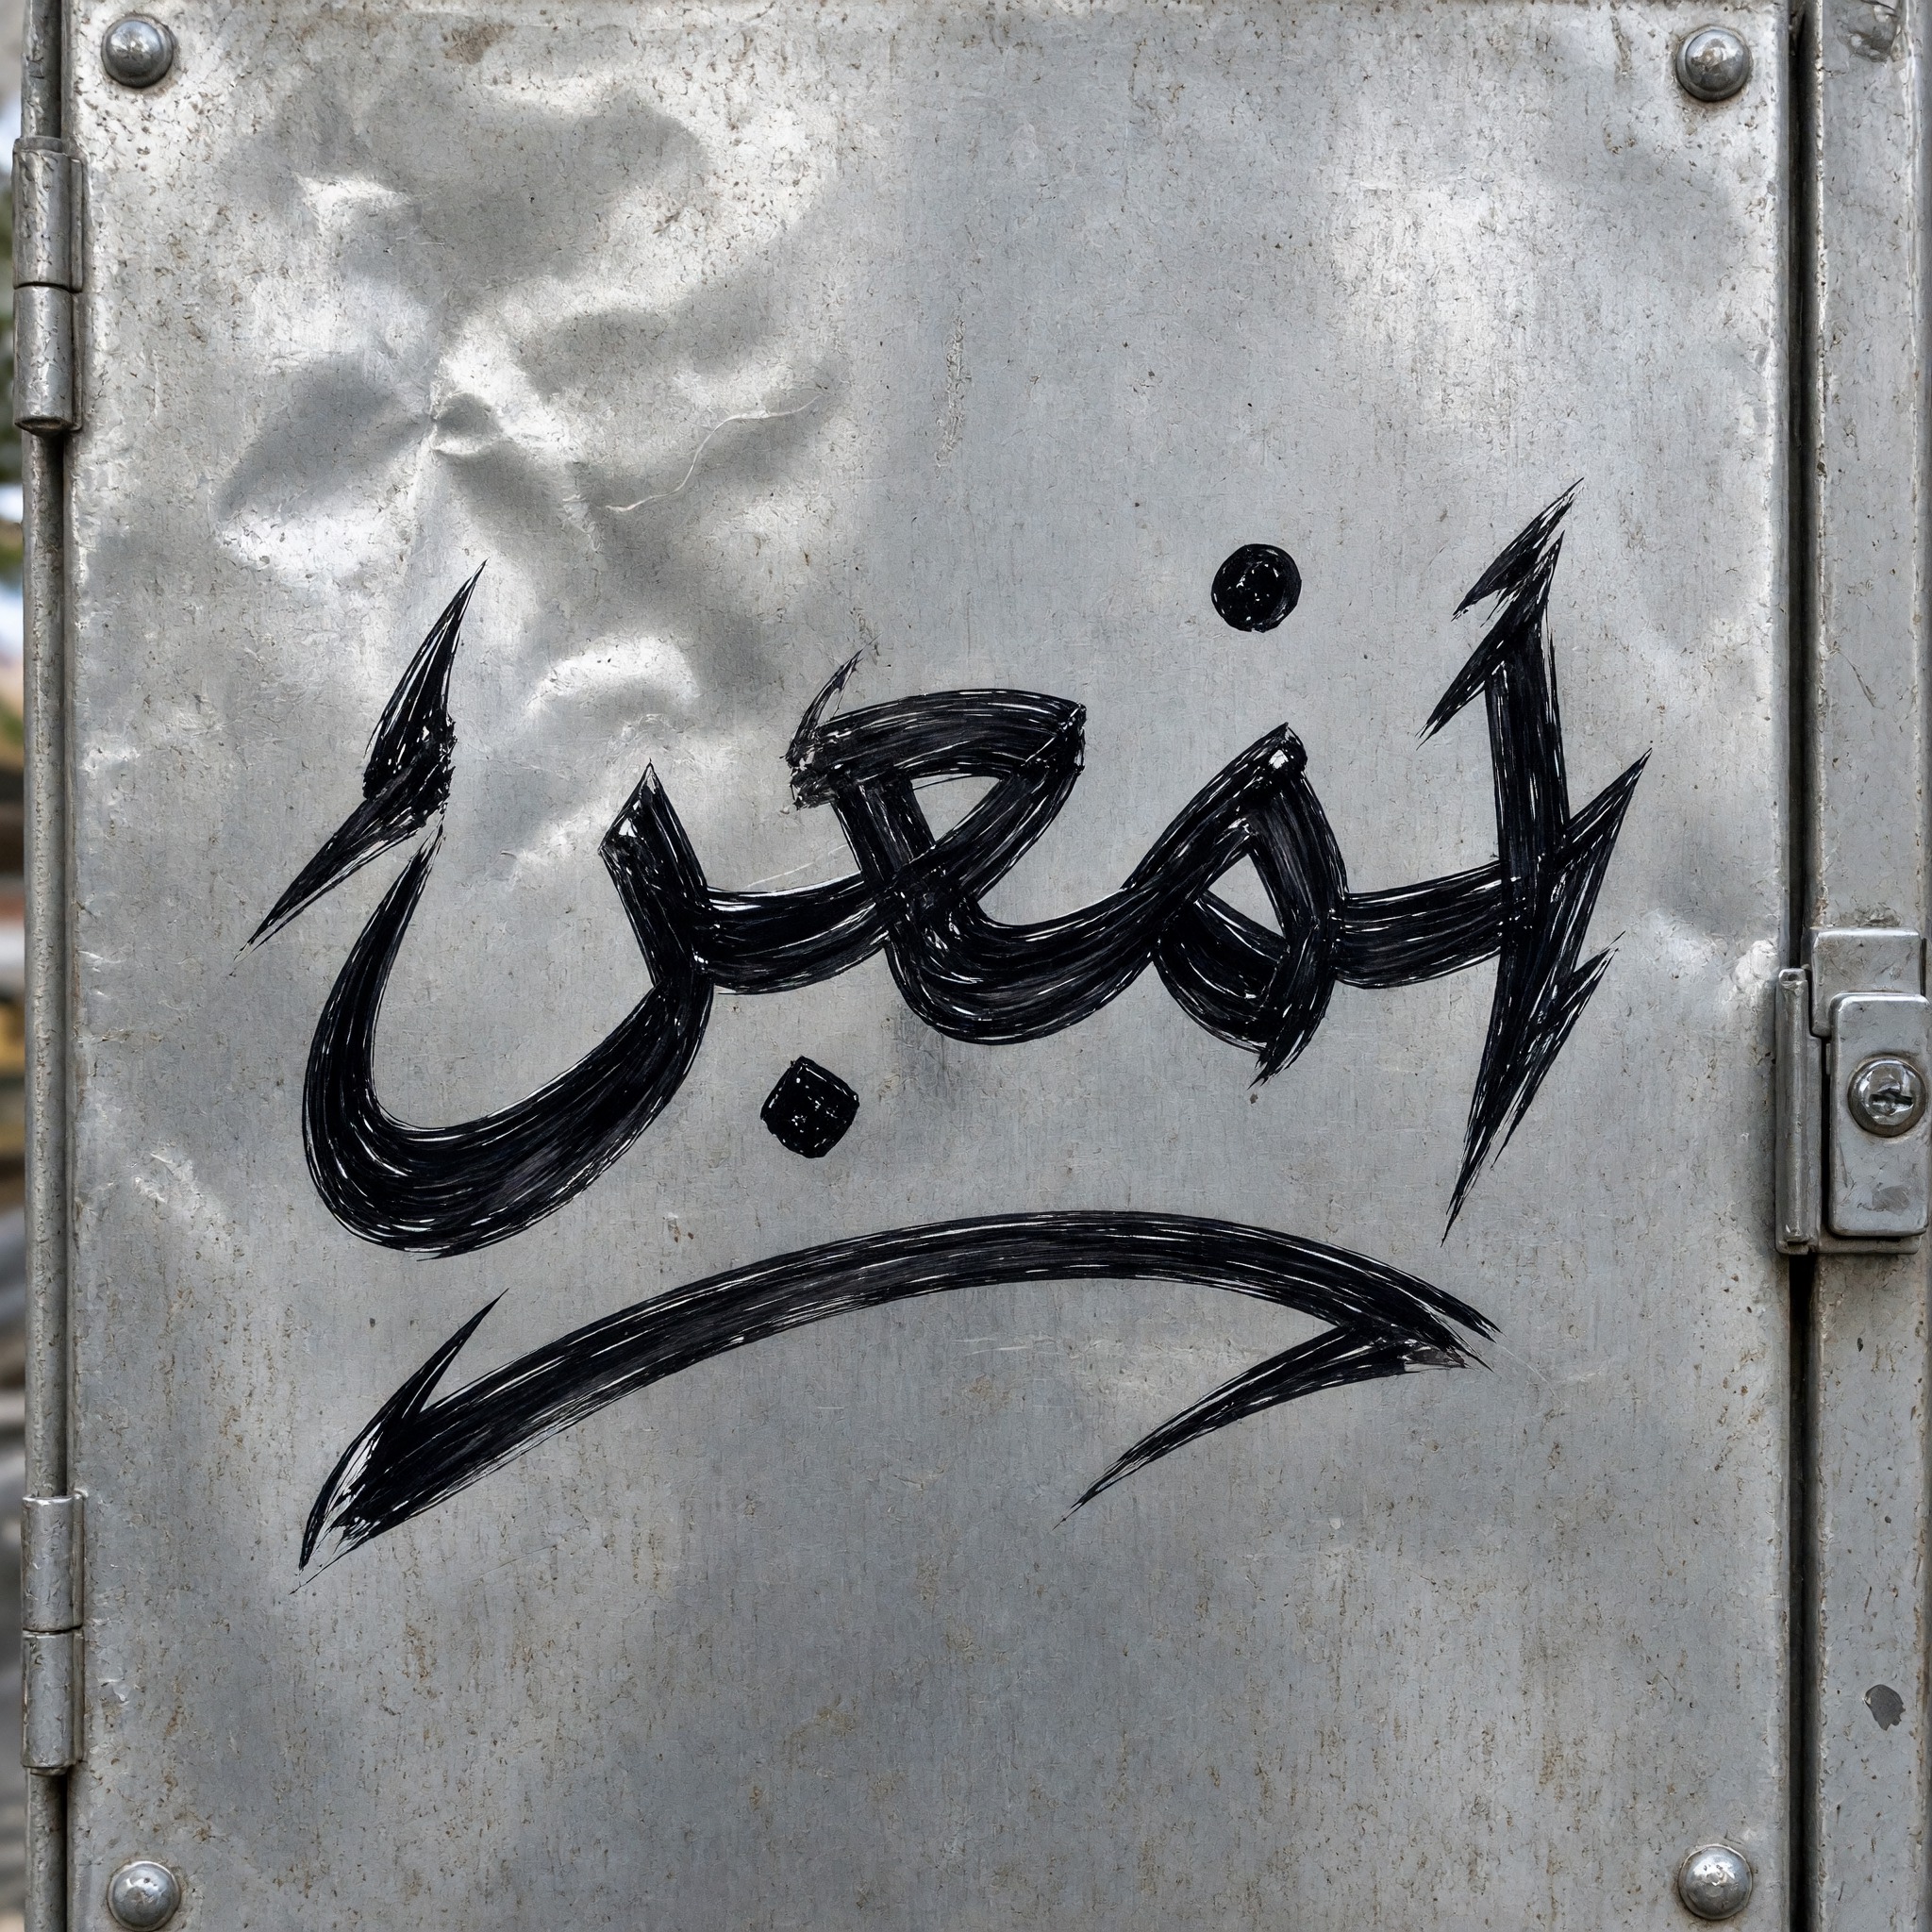
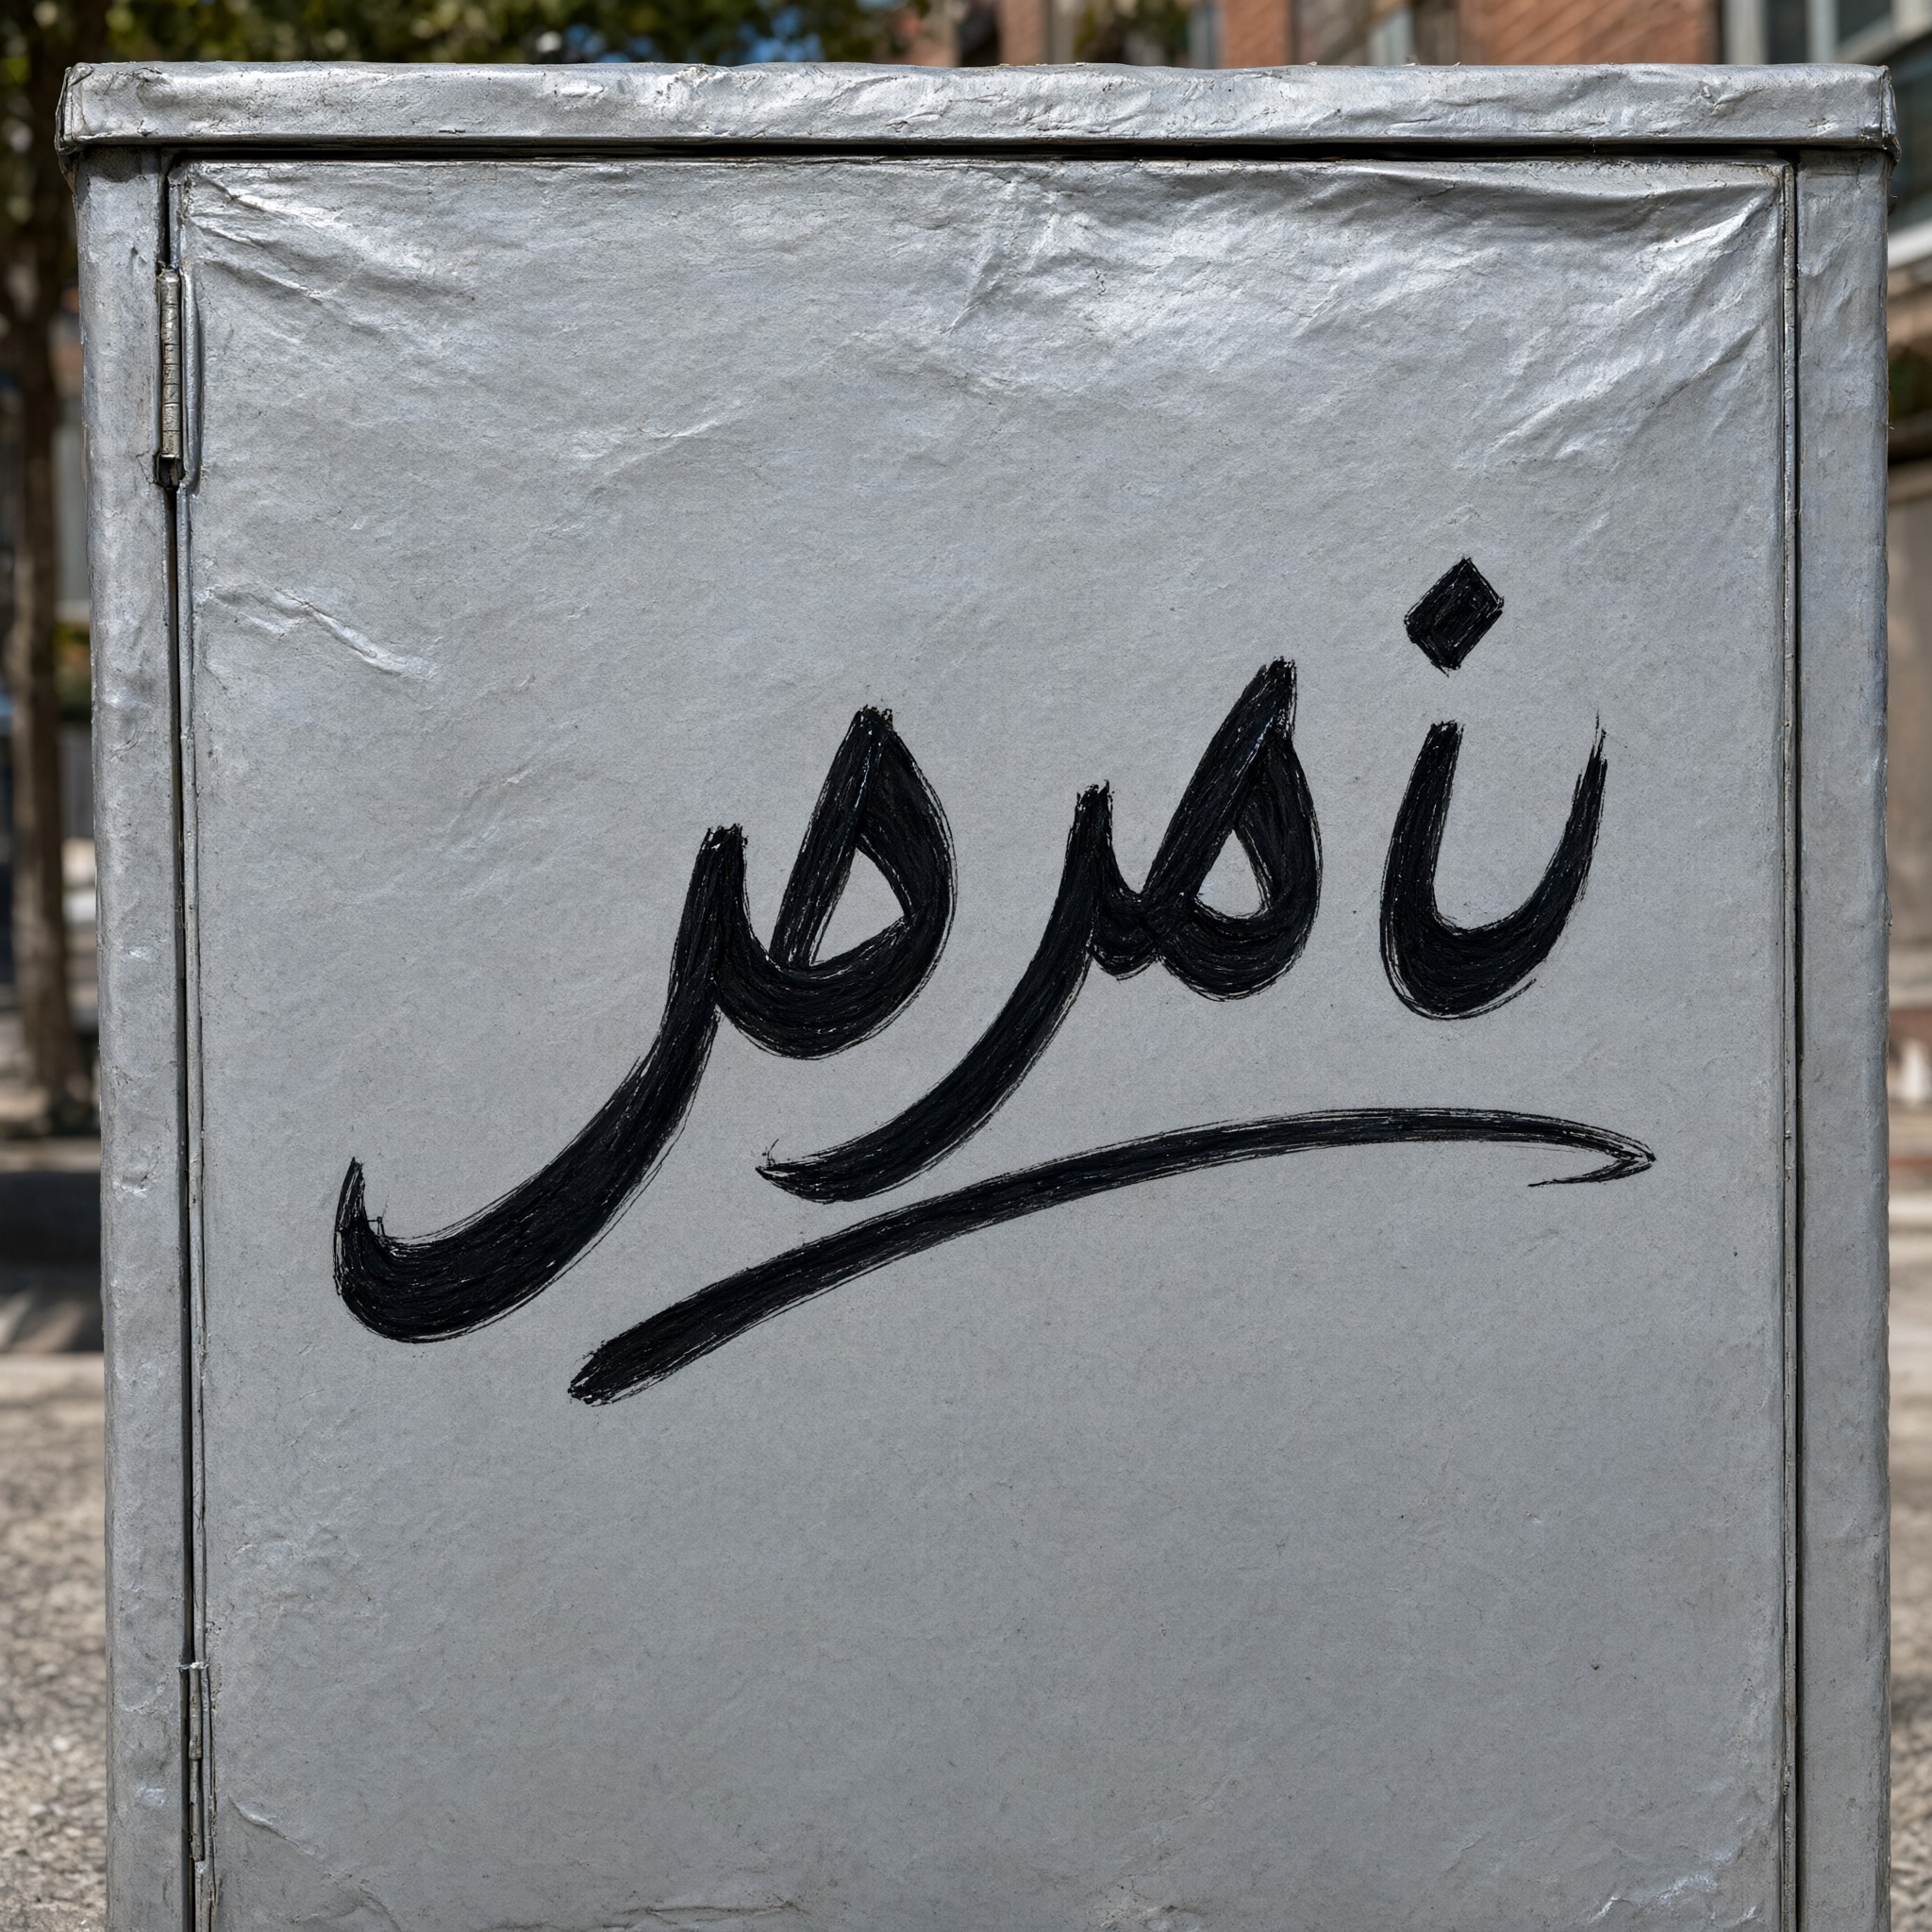
Grok Imagine und Seedream büßen im Arabischen vor allem durch Punkte und zusätzliche Buchstaben ein. Von Groks 14 arabischen Fehlern sind 6 ein fehlender, zusätzlicher oder verschobener Punkt und 5 ein zusätzlicher Buchstabe; von Seedreams 20 sind 9 Punkte und 7 zusätzliche Buchstaben. Bei unserem Lebkuchen-Prompt verstreuten beide Modelle runde Kekskrümel über und um كعك, die sich wie zusätzliche Punkte lesen.
Bei Qwen-Image liegt das Problem im Arabischen woanders. Es schreibt das gewünschte Wort kaum je hin; stattdessen setzt es eine Zeile anderer arabischer Buchstaben daneben oder an seine Stelle.
Die arabischen Zahlen haben einen Vorbehalt. Keiner unserer Prüfer liest Arabisch als Muttersprache, und 41 Bilder, bei denen KI und Mensch uneins waren, sind ausgenommen. Bei der Rangfolge sind wir sicher, denn der Abstand zwischen 96 % und 11 % ist weit größer als jeder Prüffehler. Die genauen Prozentwerte können sich verschieben, wenn Muttersprachler den Datensatz korrigieren.
Auch die Spitzenreiter machen Fehler
Die drei Fehler von GPT Image: VENON statt VENOM auf einem Death-Metal-Shirt und zwei arabische Wörter, eines mit falschem Endbuchstaben (تحيئ statt تحية) und eines mit fehlendem Buchstaben (فتة statt فتنة).
Die zwei von Nano Banana: ein japanisches Wort mit einem verformten Zeichen und ein chinesisches Halloween-Bild, das um das gewünschte Wort 南瓜 drei kleine „PARTY!“-Schilder ergänzte. Das Wort selbst war richtig; der zusätzliche Text verstieß gegen unsere Regel.
Hilft ein zweiter Durchlauf?
Teilweise, und es hängt vom Modell ab. Wir haben die Fälle gezählt, in denen das erste Bild falsch war, und geprüft, ob ein weiterer Durchlauf den Fehler behob.
| Erstes Bild falsch | Mit einem Neuversuch behoben | |
|---|---|---|
| GPT Image | 3 | 1 |
| Nano Banana | 2 | 2 |
| Grok Imagine | 28 | 13 |
| Seedream | 36 | 18 |
| Qwen-Image | 86 | 10 |
Grok Imagine und Seedream machen Detailfehler, einen Punkt oder einen Strich, und etwa die Hälfte verschwindet beim zweiten Versuch. Die Angewohnheit von Qwen-Image, Text hinzuzufügen, übersteht Neuversuche: Nur 10 von 86 wurden behoben. Wenn ein Modell immer wieder Text ergänzt, bringt es mehr, den Prompt umzuschreiben, als ihn neu laufen zu lassen.
Welches Modell solltest du für Text nehmen?
- Jede Sprache, ein Versuch: GPT Image oder Nano Banana. Entscheide nach dem Look. Die Textgenauigkeit ist kein Grund, das eine dem anderen vorzuziehen.
- Nur Englisch oder Chinesisch: Alle fünf funktionieren. Grok Imagine und Seedream sind eine gute Wahl, wenn dir ihr Stil gefällt; prüf das Ergebnis vor dem Druck.
- Japanisch: GPT Image oder Nano Banana. Sonst jedes Kana lesen und die Dakuten prüfen.
- Arabisch: GPT Image oder Nano Banana. Arabischen Text der anderen drei würden wir nicht ohne Prüfung durch einen Muttersprachler veröffentlichen.
- Qwen-Image: Halte den Schriftzug kurz und prüf das ganze Bild auf zusätzliche Buchstaben, nicht nur das gewünschte Wort.
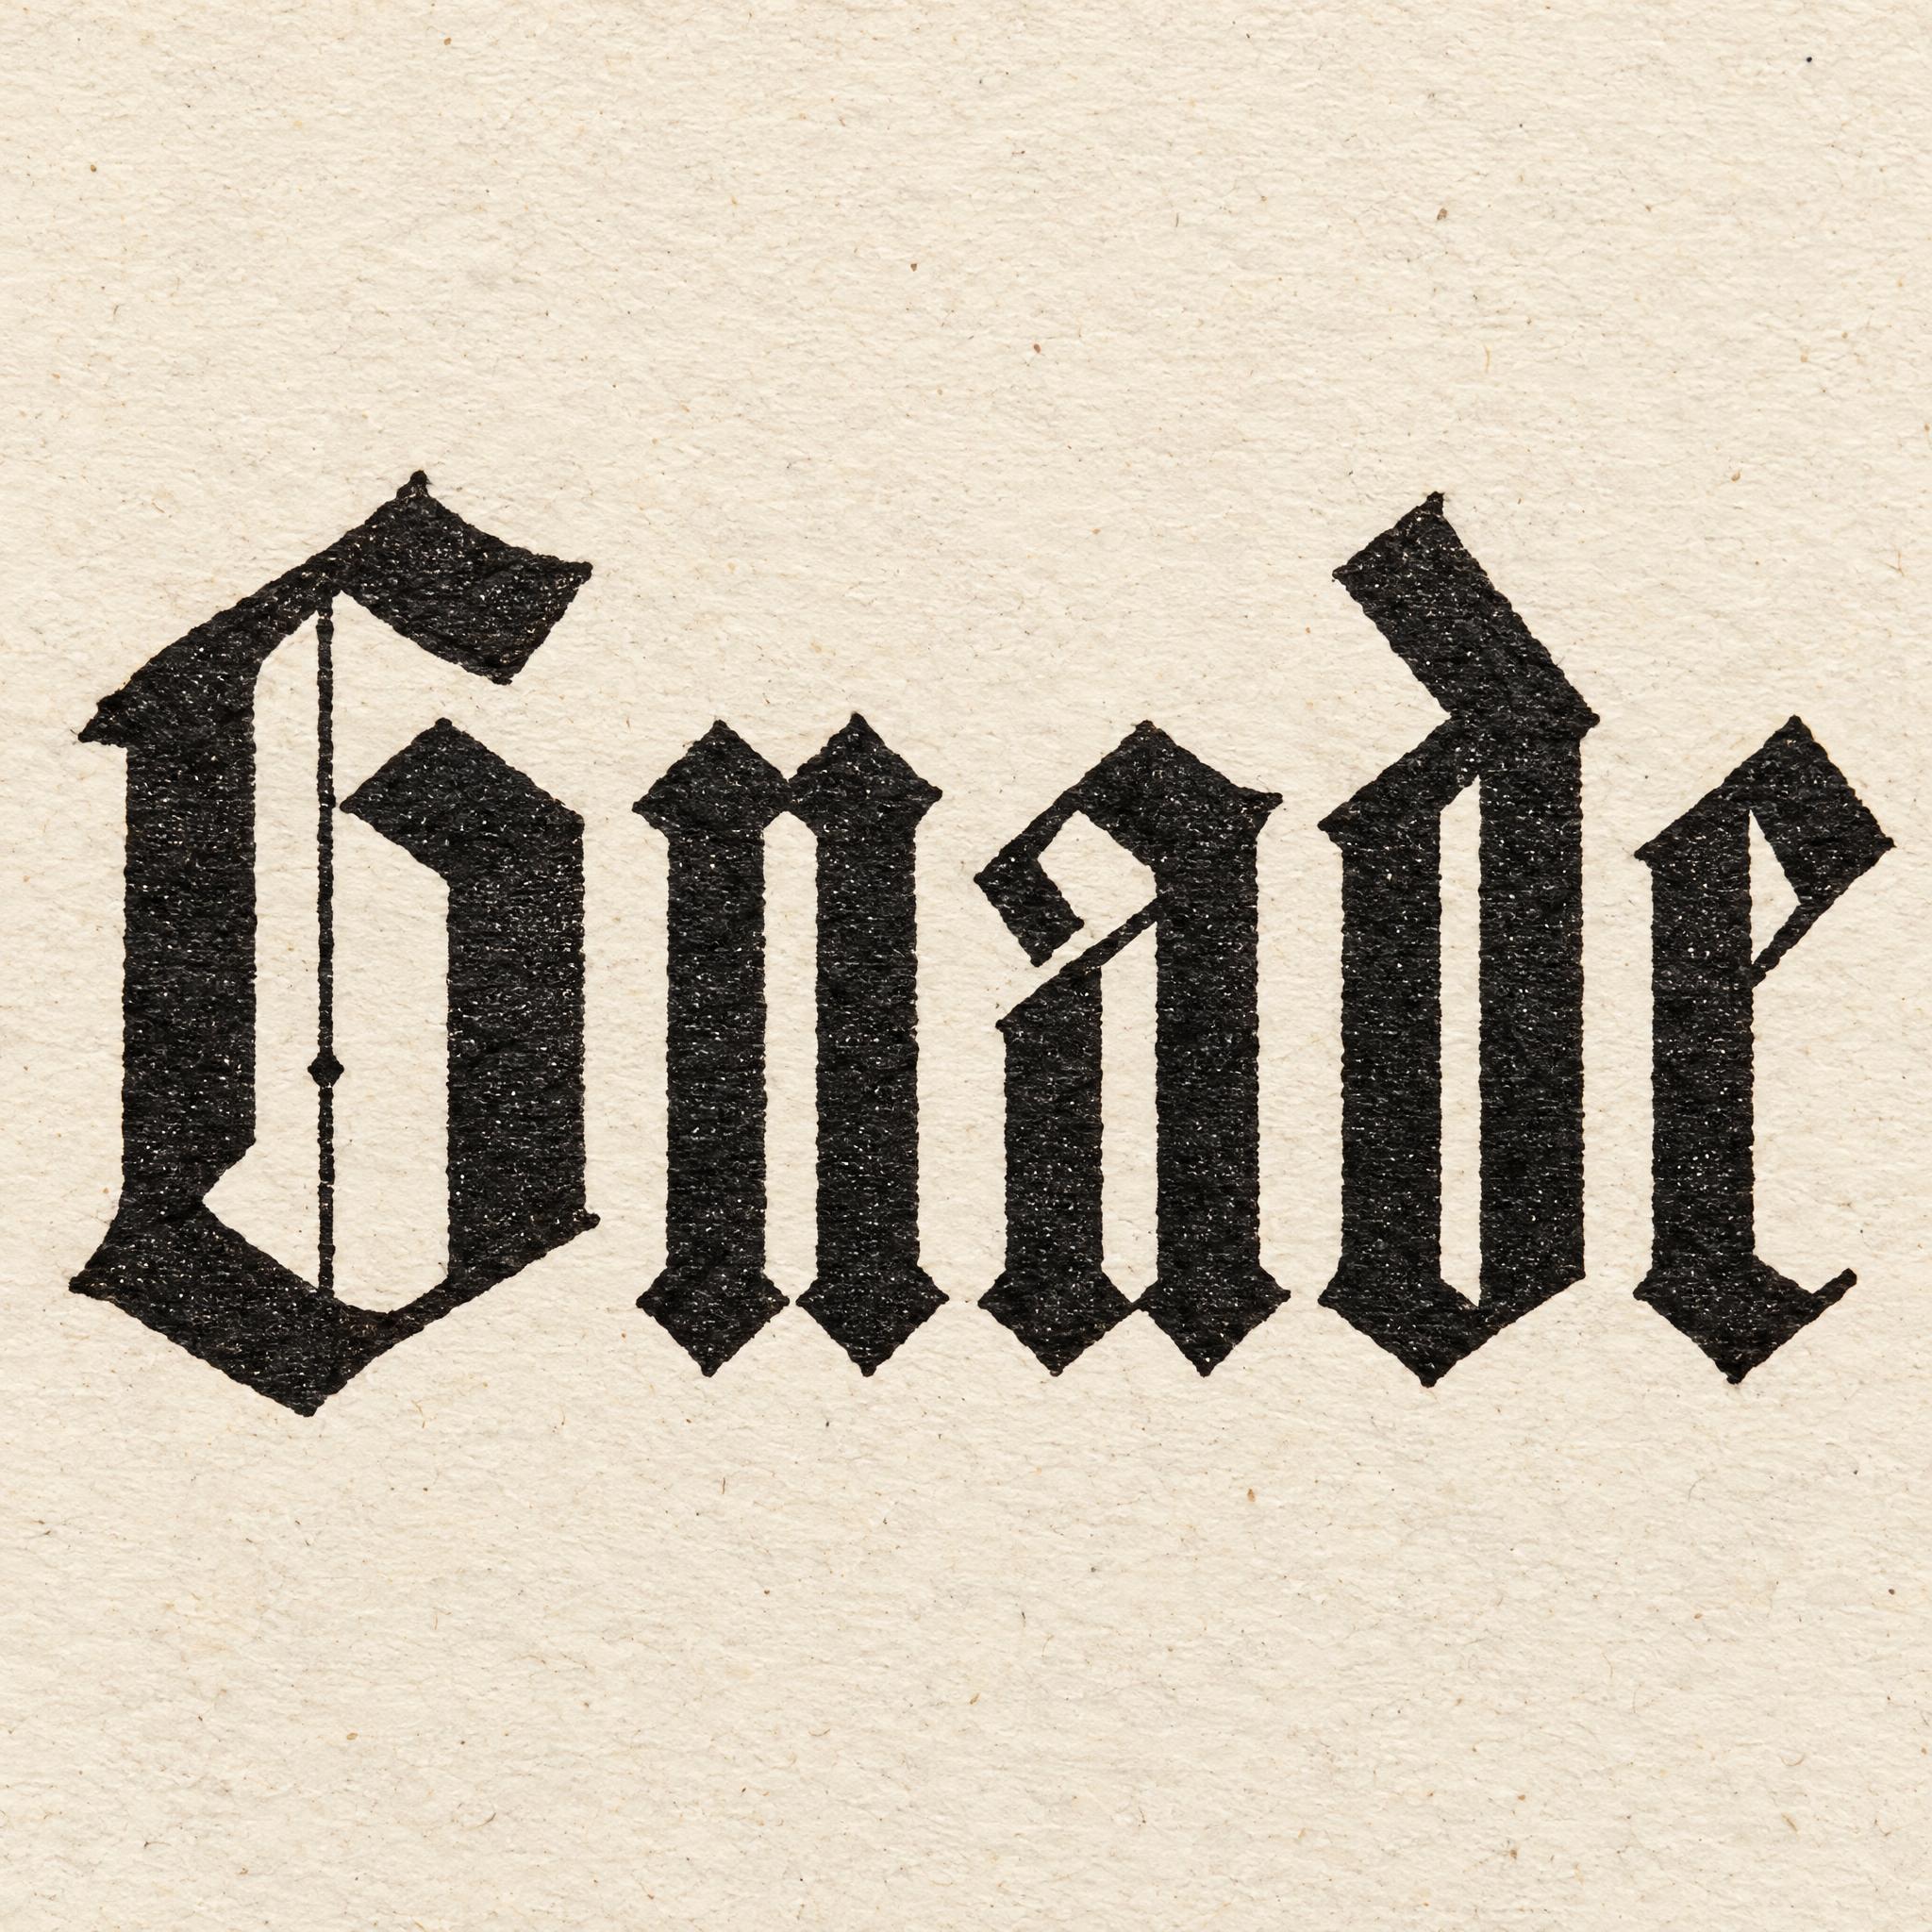
Jede AIFont-Schriftseite zeigt die Ergebnisse aller fünf Modelle für jede Sprache, so siehst du, wie ein Stil sich liest, bevor du seinen Prompt kopierst. Die Sammlungen Gothic-Schriften und Graffiti-Buchstaben eignen sich gut, um sie direkt nebeneinander zu vergleichen.
Die Daten sind offen
Alle 2.495 Bilder des Datensatzes sind mit Prompts, Urteilen und Prüfnotizen öffentlich unter CC BY 4.0: AIFont-Datensatz zur Textdarstellung auf GitHub, archiviert auf Zenodo (DOI 10.5281/zenodo.23815210). Wenn du Arabisch, Japanisch oder eine andere der Sprachen darin liest und ein falsches Urteil entdeckst, eröffne ein Issue. Korrekturen fließen in das nächste Release und in diese Tabelle ein.
Wir wiederholen den Vergleich, sobald neue Stile und Sprachen erscheinen und wenn die Modelle aktualisiert werden.
Häufige Fragen
Welches ist 2026 das beste KI-Bildmodell für Text?
In unserem Test mit 2.016 Bildern liegen GPT Image 2.5 und Nano Banana 2.1 gleichauf an der Spitze. Sie schrieben 401 bzw. 402 von 404 Wörtern richtig. Der Abstand beträgt ein Bild, das ist ein Unentschieden. Beide blieben in jeder getesteten Schrift über 95 %, auch im Arabischen.
Welches KI-Bildmodell eignet sich am besten für japanischen oder arabischen Text?
GPT Image und Nano Banana. Im Japanischen schrieben beide 58 bzw. 59 von 59 Wörtern richtig, die anderen drei Modelle 45 bis 52. Im Arabischen kamen sie auf 96 % und 100 %, Grok Imagine auf 71 %, Seedream auf 57 % und Qwen-Image auf 11 %.
Warum schreibt Qwen-Image Text falsch?
Vor allem, weil es Text hinzufügt, den niemand verlangt hat. Bei 40 seiner Fehler schrieb Qwen-Image das gewünschte Wort richtig und füllte das Bild dann mit einem Absatz zusätzlicher Buchstaben, oft einer verstümmelten Kopie des Prompts selbst. Denselben Prompt noch einmal laufen zu lassen, behebt das selten.
Sind die Testdaten öffentlich?
Ja. Jedes Bild, jeder Prompt, jedes Urteil und jede Prüfnotiz steht im AIFont-Datensatz zur Textdarstellung auf GitHub und Zenodo unter CC BY 4.0, und jeder kann eine Korrektur einreichen.
Prompt kopieren, in ChatGPT, Gemini oder ein anderes Bildmodell einfügen und den Text durch deinen ersetzen.
Alle KI-Schriften ansehen