أفضل نموذج لتوليد الصور بالذكاء الاصطناعي لكتابة النصوص (اختبار 2026)
أعطينا 5 نماذج لتوليد الصور الموجّهات الـ59 نفسها في 7 لغات. أصاب GPT Image و Nano Banana في 99% من الكلمات، و Qwen-Image في 79%.
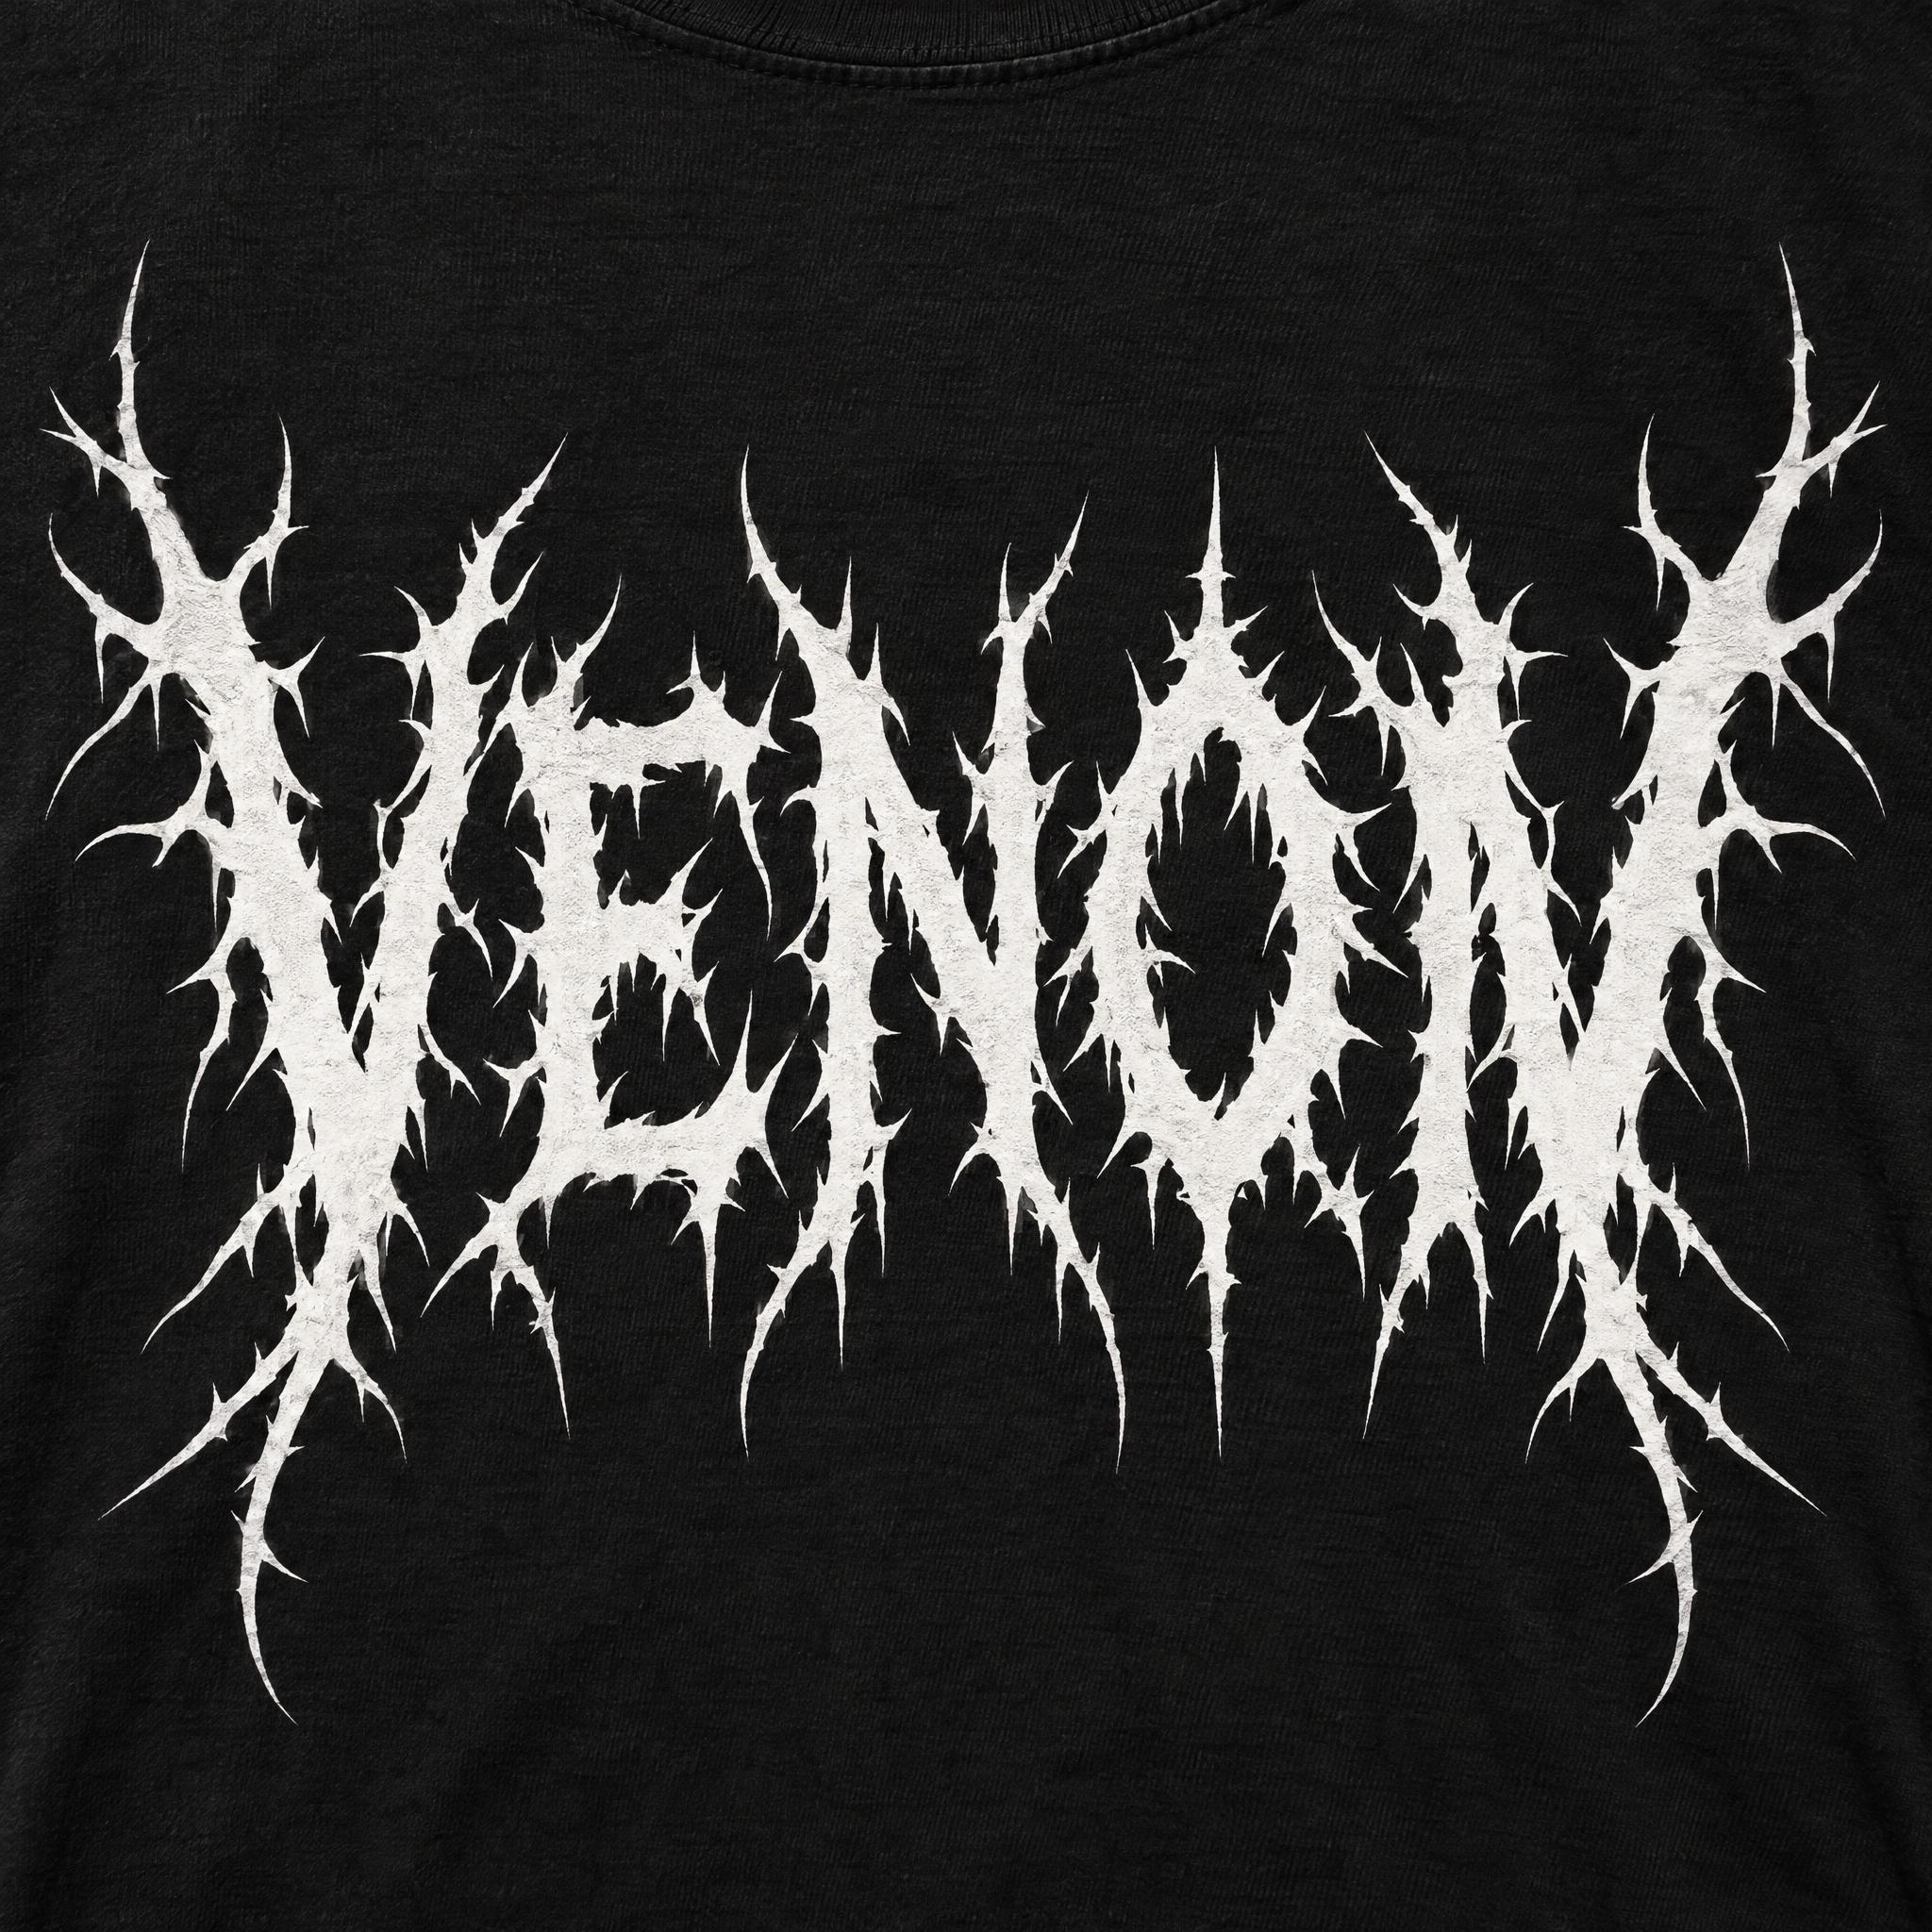
اطلب من نموذج لتوليد الصور بالذكاء الاصطناعي قميصًا لفرقة ديث ميتال مكتوبًا عليه VENOM، فيطبع لك أفضل نموذج اختبرناه VENON. كان هذا واحدًا من ثلاثة أخطاء إملائية فقط ارتكبها GPT Image في 404 صور. أما Qwen-Image فارتكب 86 خطأً.
النص هو المجال الذي ما زالت نماذج توليد الصور تتفاوت فيه. قد يرسم النموذج الكروم وقطرات الطلاء وإضاءة الاستوديو بدقة تجعلها تبدو صورة فوتوغرافية، ثم يضع نقطة واحدة في غير موضعها فتصير الكلمة كلمة أخرى. عملنا هو إعداد موجّهات خطوط الذكاء الاصطناعي، لذلك نشغّل كل موجّه ننشره على خمسة نماذج ونراجع كل صورة حرفًا حرفًا. وبعد 59 نمطًا، تراكمت هذه المراجعة لتصبح المقارنة التالية.
الجواب المختصر
| نظام الكتابة | GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image |
|---|---|---|---|---|---|
| اللاتينية (الإنجليزية، الألمانية، الإسبانية، البرتغالية) | 235/236 | 235/235 | 229/235 | 230/235 | 213/235 |
| الصينية | 59/59 | 58/59 | 58/59 | 56/59 | 56/59 |
| اليابانية | 59/59 | 58/59 | 52/59 | 51/59 | 45/59 |
| العربية | 48/50 | 51/51 | 35/49 | 27/47 | 6/53 |
| الإجمالي | 99% | 100% | 93% | 91% | 79% |
- GPT Image 2.5 و Nano Banana 2.1 هما أفضل نموذجين لتوليد الصور حين يكون في الصورة نص. خطآن أو ثلاثة لكلٍّ منهما في نحو 400 صورة، وفي كل نظام كتابة.
- Grok Imagine 2.0 و Seedream 5.0 Pro يتعاملان جيدًا مع اللاتينية والصينية، ثم يتعثّران في اليابانية وينهاران في العربية.
- Qwen-Image 3.0 Pro هو النموذج الوحيد الذي يخسر نقاطًا حتى في الكلمات الإنجليزية العادية، وسجّل 6 من 53 في العربية.
كيف اختبرنا
كل نمط من الأنماط الـ59 هو موجّه منشور على AIFont، مثل Textura وPaint Splatter وTagging Letters. لكل نمط موجّه واحد لكل لغة، فيه كلمة عرض قصيرة بتلك اللغة: FRESH و Reino و ばくはつ و كعك.
- موجّه واحد لكل النماذج. تلقّى كل نموذج نص الموجّه نفسه حرفيًّا لكل نمط ولغة. واحتسبنا أول صورة أعادها كل نموذج فقط، من دون انتقاء أفضل محاولة من بين عدة محاولات.
- الإعدادات: دقة 2K، صورة مربعة، عبر واجهة API الرسمية لكل شركة، بين 22 و29 أكتوبر 2026. شغّلنا GPT Image على إعداد الجودة xhigh، و Grok Imagine على medium وهو أعلى إعداد لديه؛ أما النماذج الثلاثة الأخرى فليس لها إعداد للجودة.
- النماذج: GPT Image 2.5 (OpenAI)، و Nano Banana 2.1 (Google)، و Grok Imagine Image 2.0 (xAI)، و Seedream 5.0 Pro (ByteDance)، و Qwen-Image 3.0 Pro (Alibaba).
- التحكيم: قرأ مراجعٌ بالذكاء الاصطناعي كل صورة، مع التكبير في الصينية واليابانية والعربية. ثم راجع شخصٌ 489 صورة من الصور المحتسبة: كل صورة حكم عليها الذكاء الاصطناعي بالخطأ أو لم يكن متأكدًا منها، ومعظم صور العربية، وعينة عشوائية من الباقي.
- ما الذي يُعدّ خطأً: تُعدّ الكلمة خاطئة فقط إذا أمكنك أن تقول ماذا تُقرأ بدلًا منها (VENON لا VENOM). أشكال الحروف المزخرفة والخطوط التزيينية واختلاف الأحرف الكبيرة والصغيرة كلها تُعدّ صحيحة. أما الكلمات الزائدة التي لم يطلبها الموجّه فتُعدّ خطأً.
نتج عن ذلك 2,057 صورة من المحاولة الأولى. استبعدنا منها 41 صورة عربية اختلف فيها حكم الذكاء الاصطناعي عن حكم المراجع البشري، وليس أيٌّ منهما من متحدثي العربية الأصليين، فبقيت 2,016 صورة محتسبة.
اللاتينية والصينية: النماذج الخمسة كلها تنجح
سجّل كل نموذج أكثر من 90% في الإنجليزية والألمانية والإسبانية والبرتغالية والصينية. إذا كان نصّك قصيرًا وبإحدى هذه اللغات، فأيٌّ من النماذج الخمسة سيكتبه صحيحًا في المحاولة الأولى في أغلب الحالات.
الاستثناء الوحيد هو Qwen-Image في الإسبانية والبرتغالية، إذ أخطأ في 9 إلى 10 كلمات في كل لغة. وخطؤه المعتاد ليس خطأً إملائيًّا.
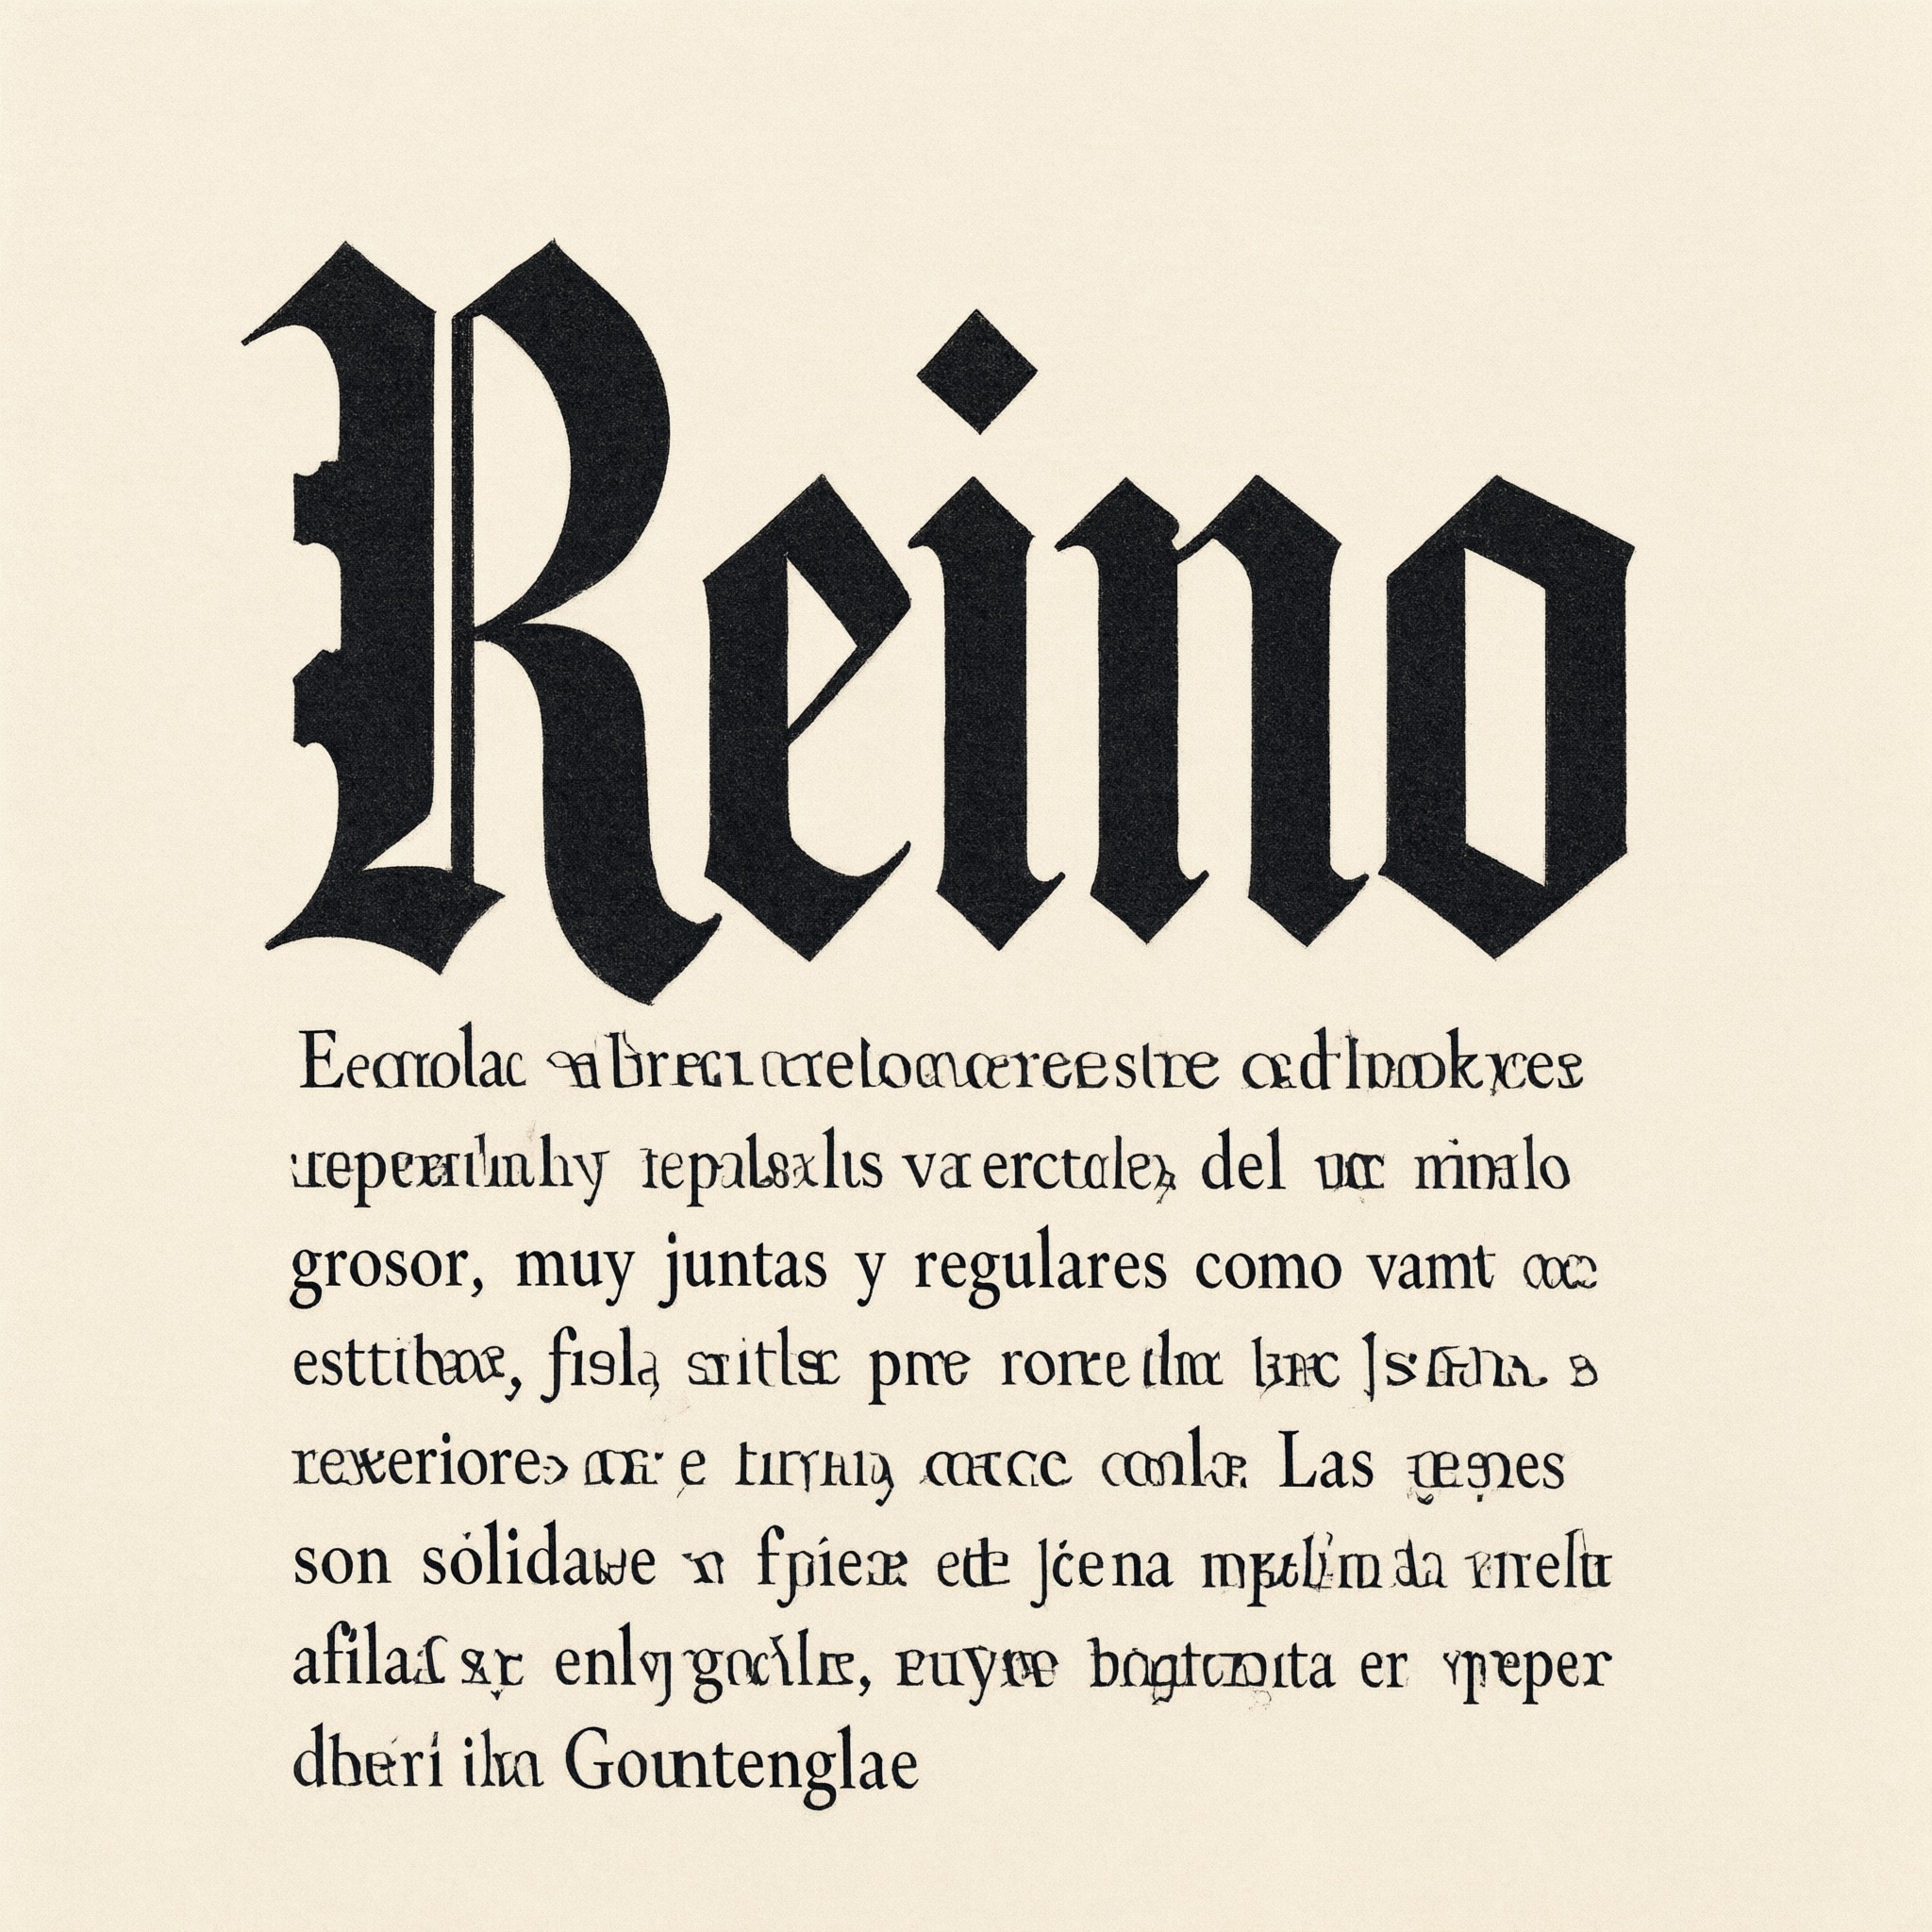
هذا النمط، أي الكلمة المطلوبة ومعها كتلة من نص غير مطلوب، يفسّر 40 من أخطاء Qwen-Image الـ86. وكثيرًا ما يكون النص الزائد نسخة مبعثرة من الموجّه نفسه.
اليابانية: هنا تبدأ الفجوة
| GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image | |
|---|---|---|---|---|---|
| اليابانية | 59/59 | 58/59 | 52/59 | 51/59 | 45/59 |
في حروف الكانا اليابانية علامات صغيرة تغيّر الكلمة: نقطتان صغيرتان (الداكوتين) تحوّلان は إلى ば. في موجّه تناثر الطلاء، وضع كلٌّ من Grok Imagine و Seedream الداكوتين في غير موضعهما.
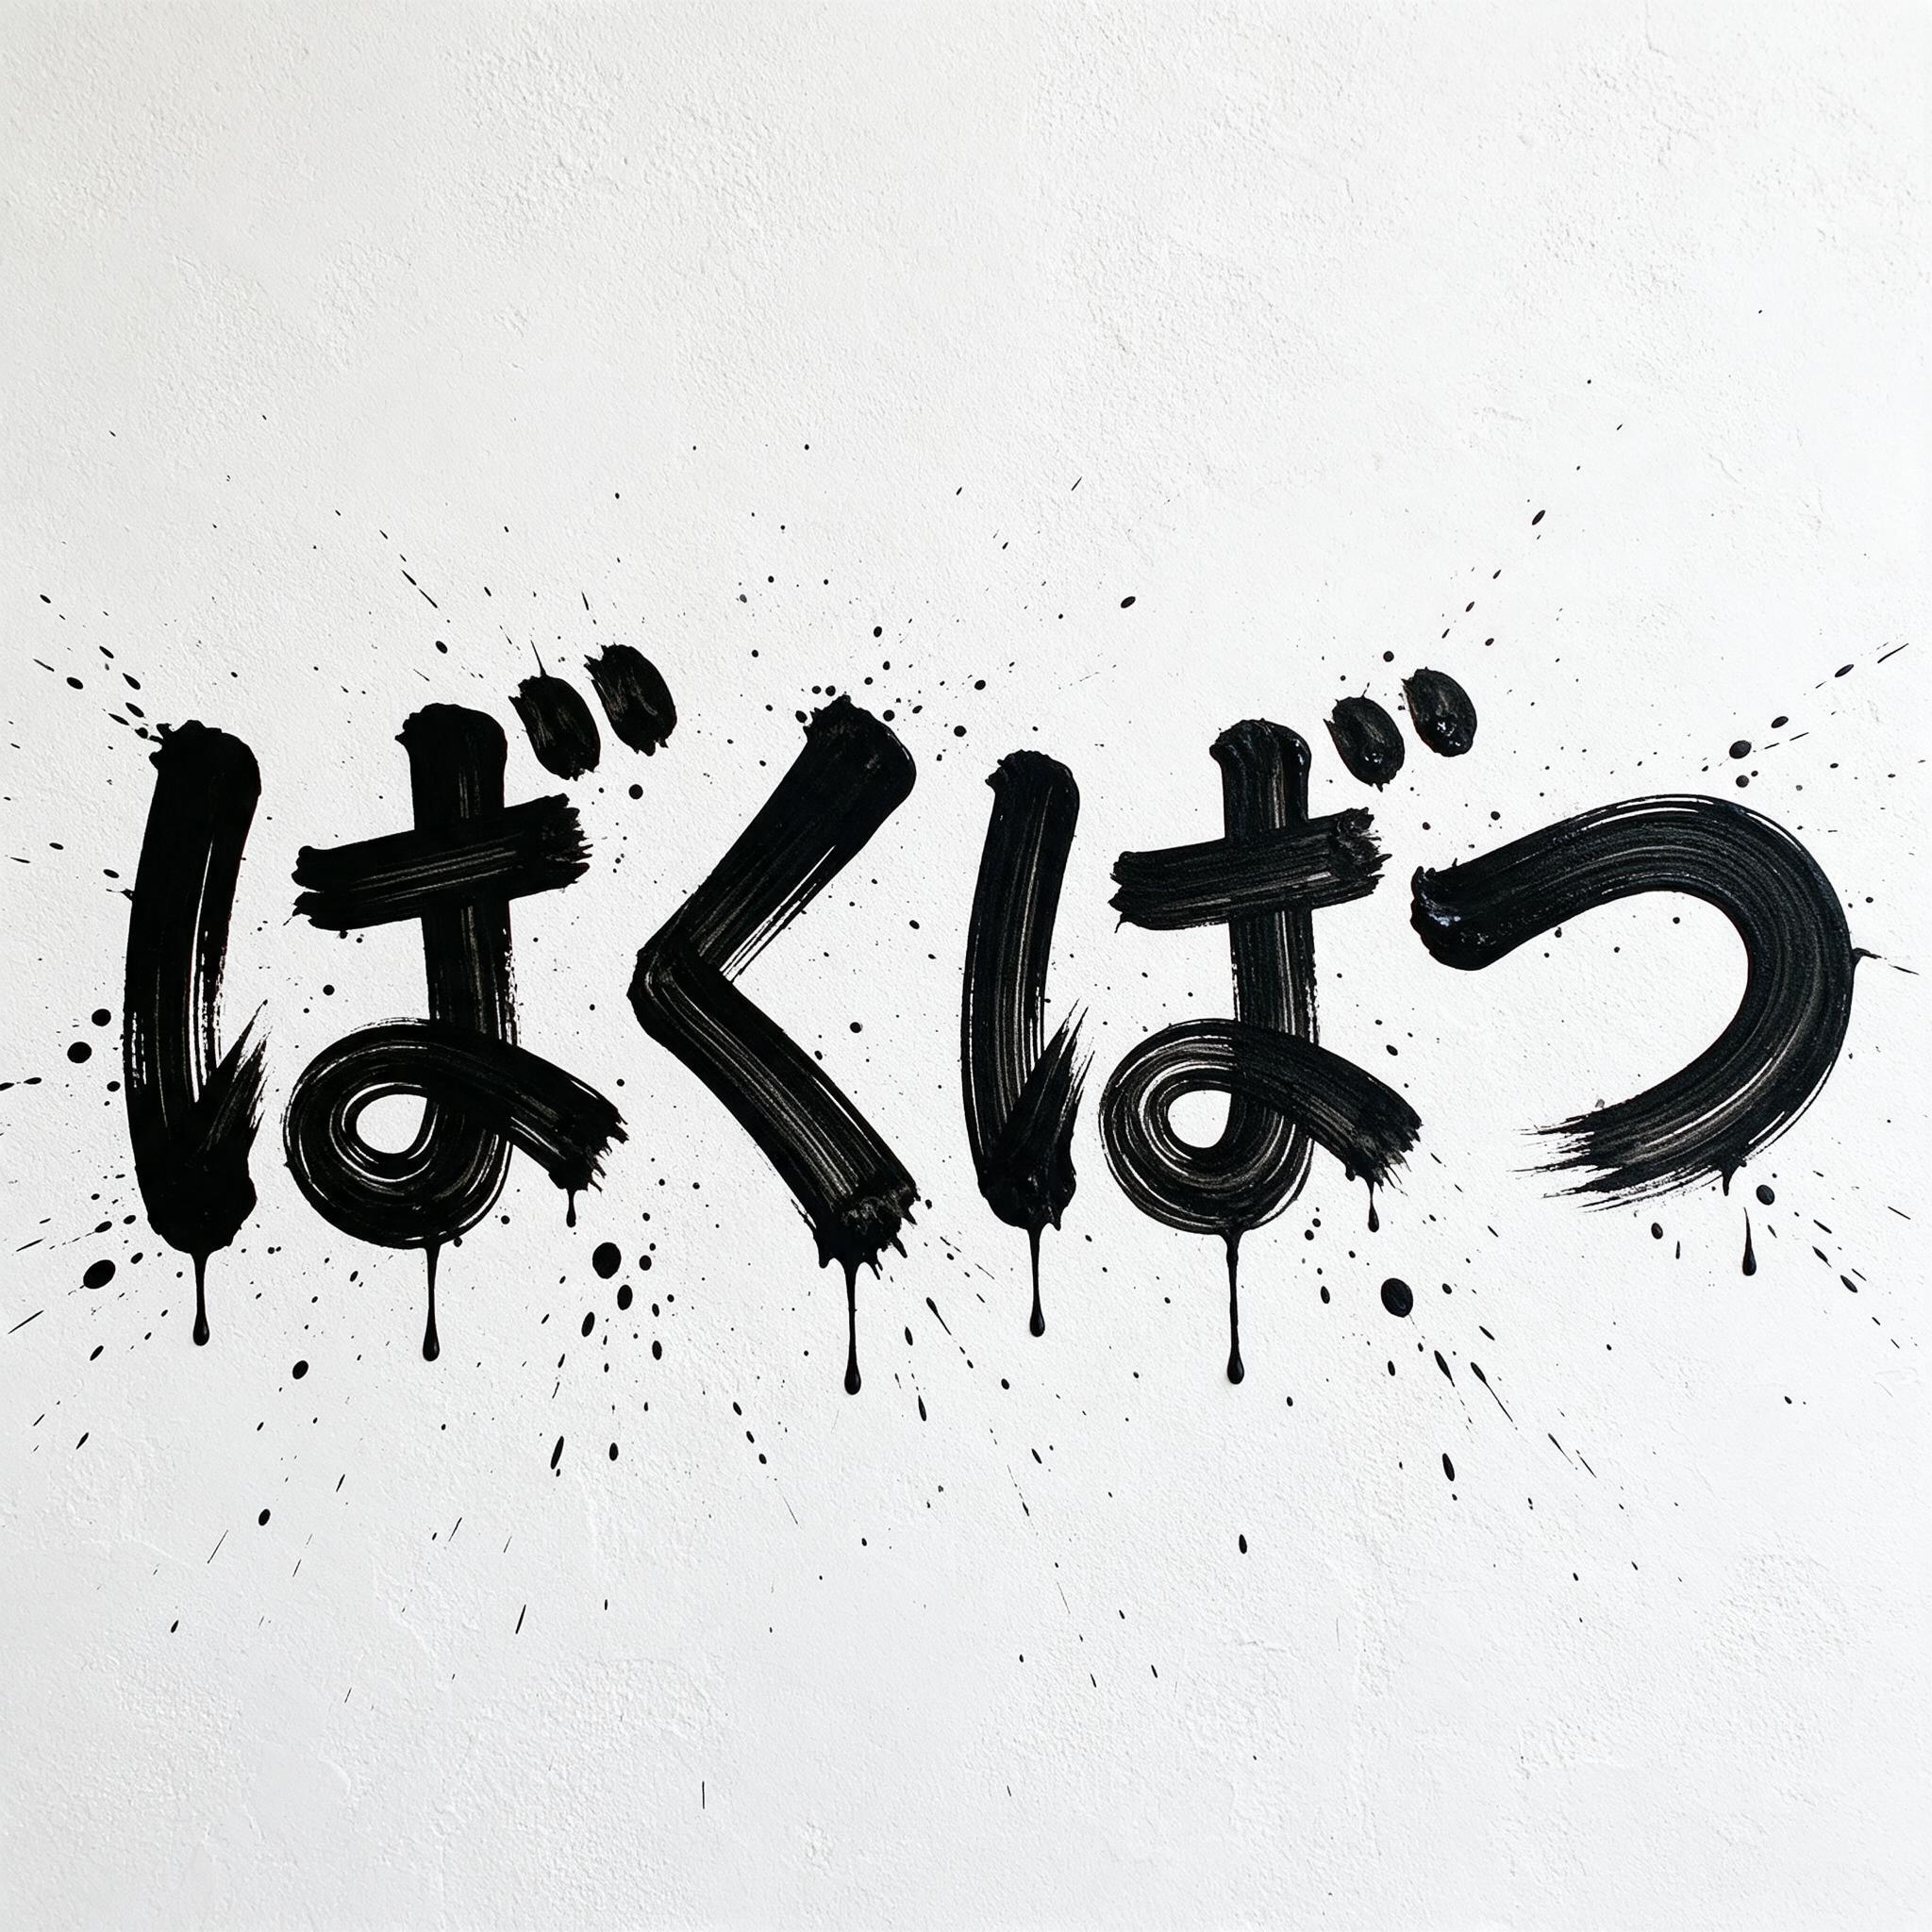
أخطاء Grok Imagine و Seedream الأخرى في اليابانية على الشاكلة نفسها: حرف واحد خاطئ، لا كلمة مشوّهة بالكامل. كتب Grok ストリトト بدلًا من ストリート، و ジングス بدلًا من ジンクス، و ぼうげん بدلًا من ぼうけん؛ وكتب Seedream かくどう بدلًا من かくとう، و ねがいの بدلًا من ねがい. والقارئ الياباني يلاحظ كل واحد منها فورًا.
العربية: نموذجان فقط يصمدان
| GPT Image | Nano Banana | Grok Imagine | Seedream | Qwen-Image | |
|---|---|---|---|---|---|
| العربية | 48/50 (96%) | 51/51 (100%) | 35/49 (71%) | 27/47 (57%) | 6/53 (11%) |
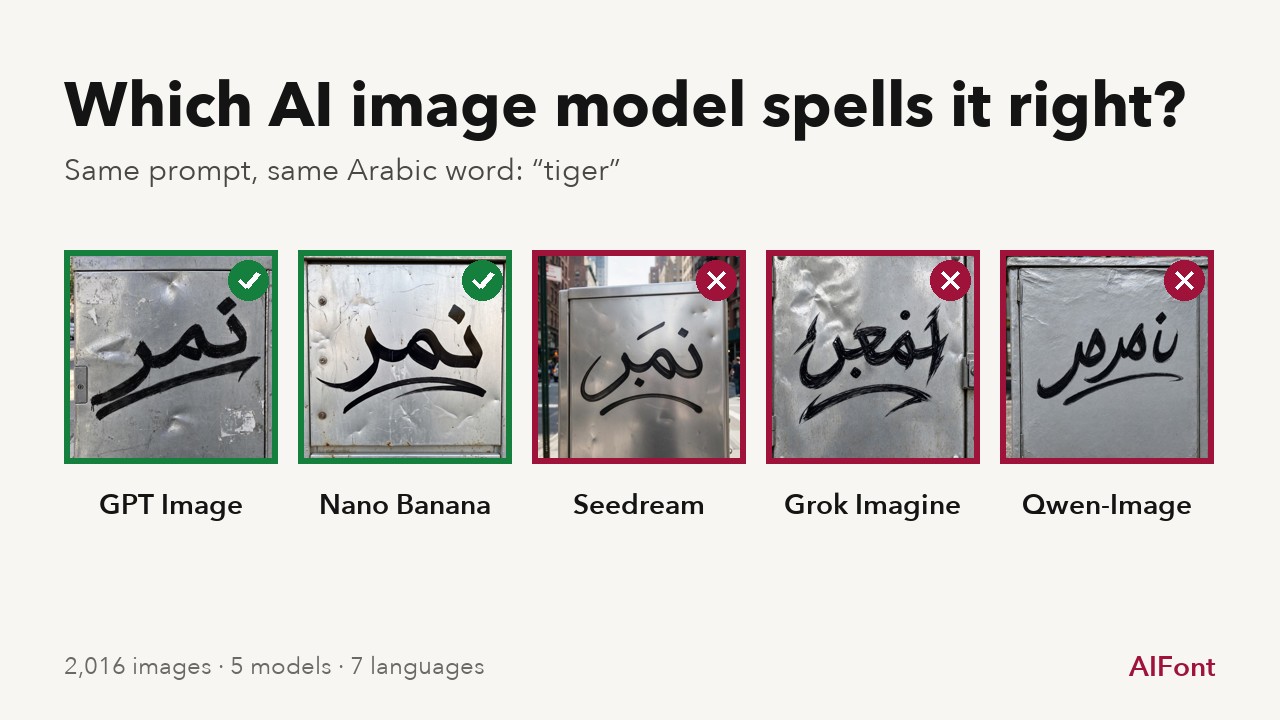
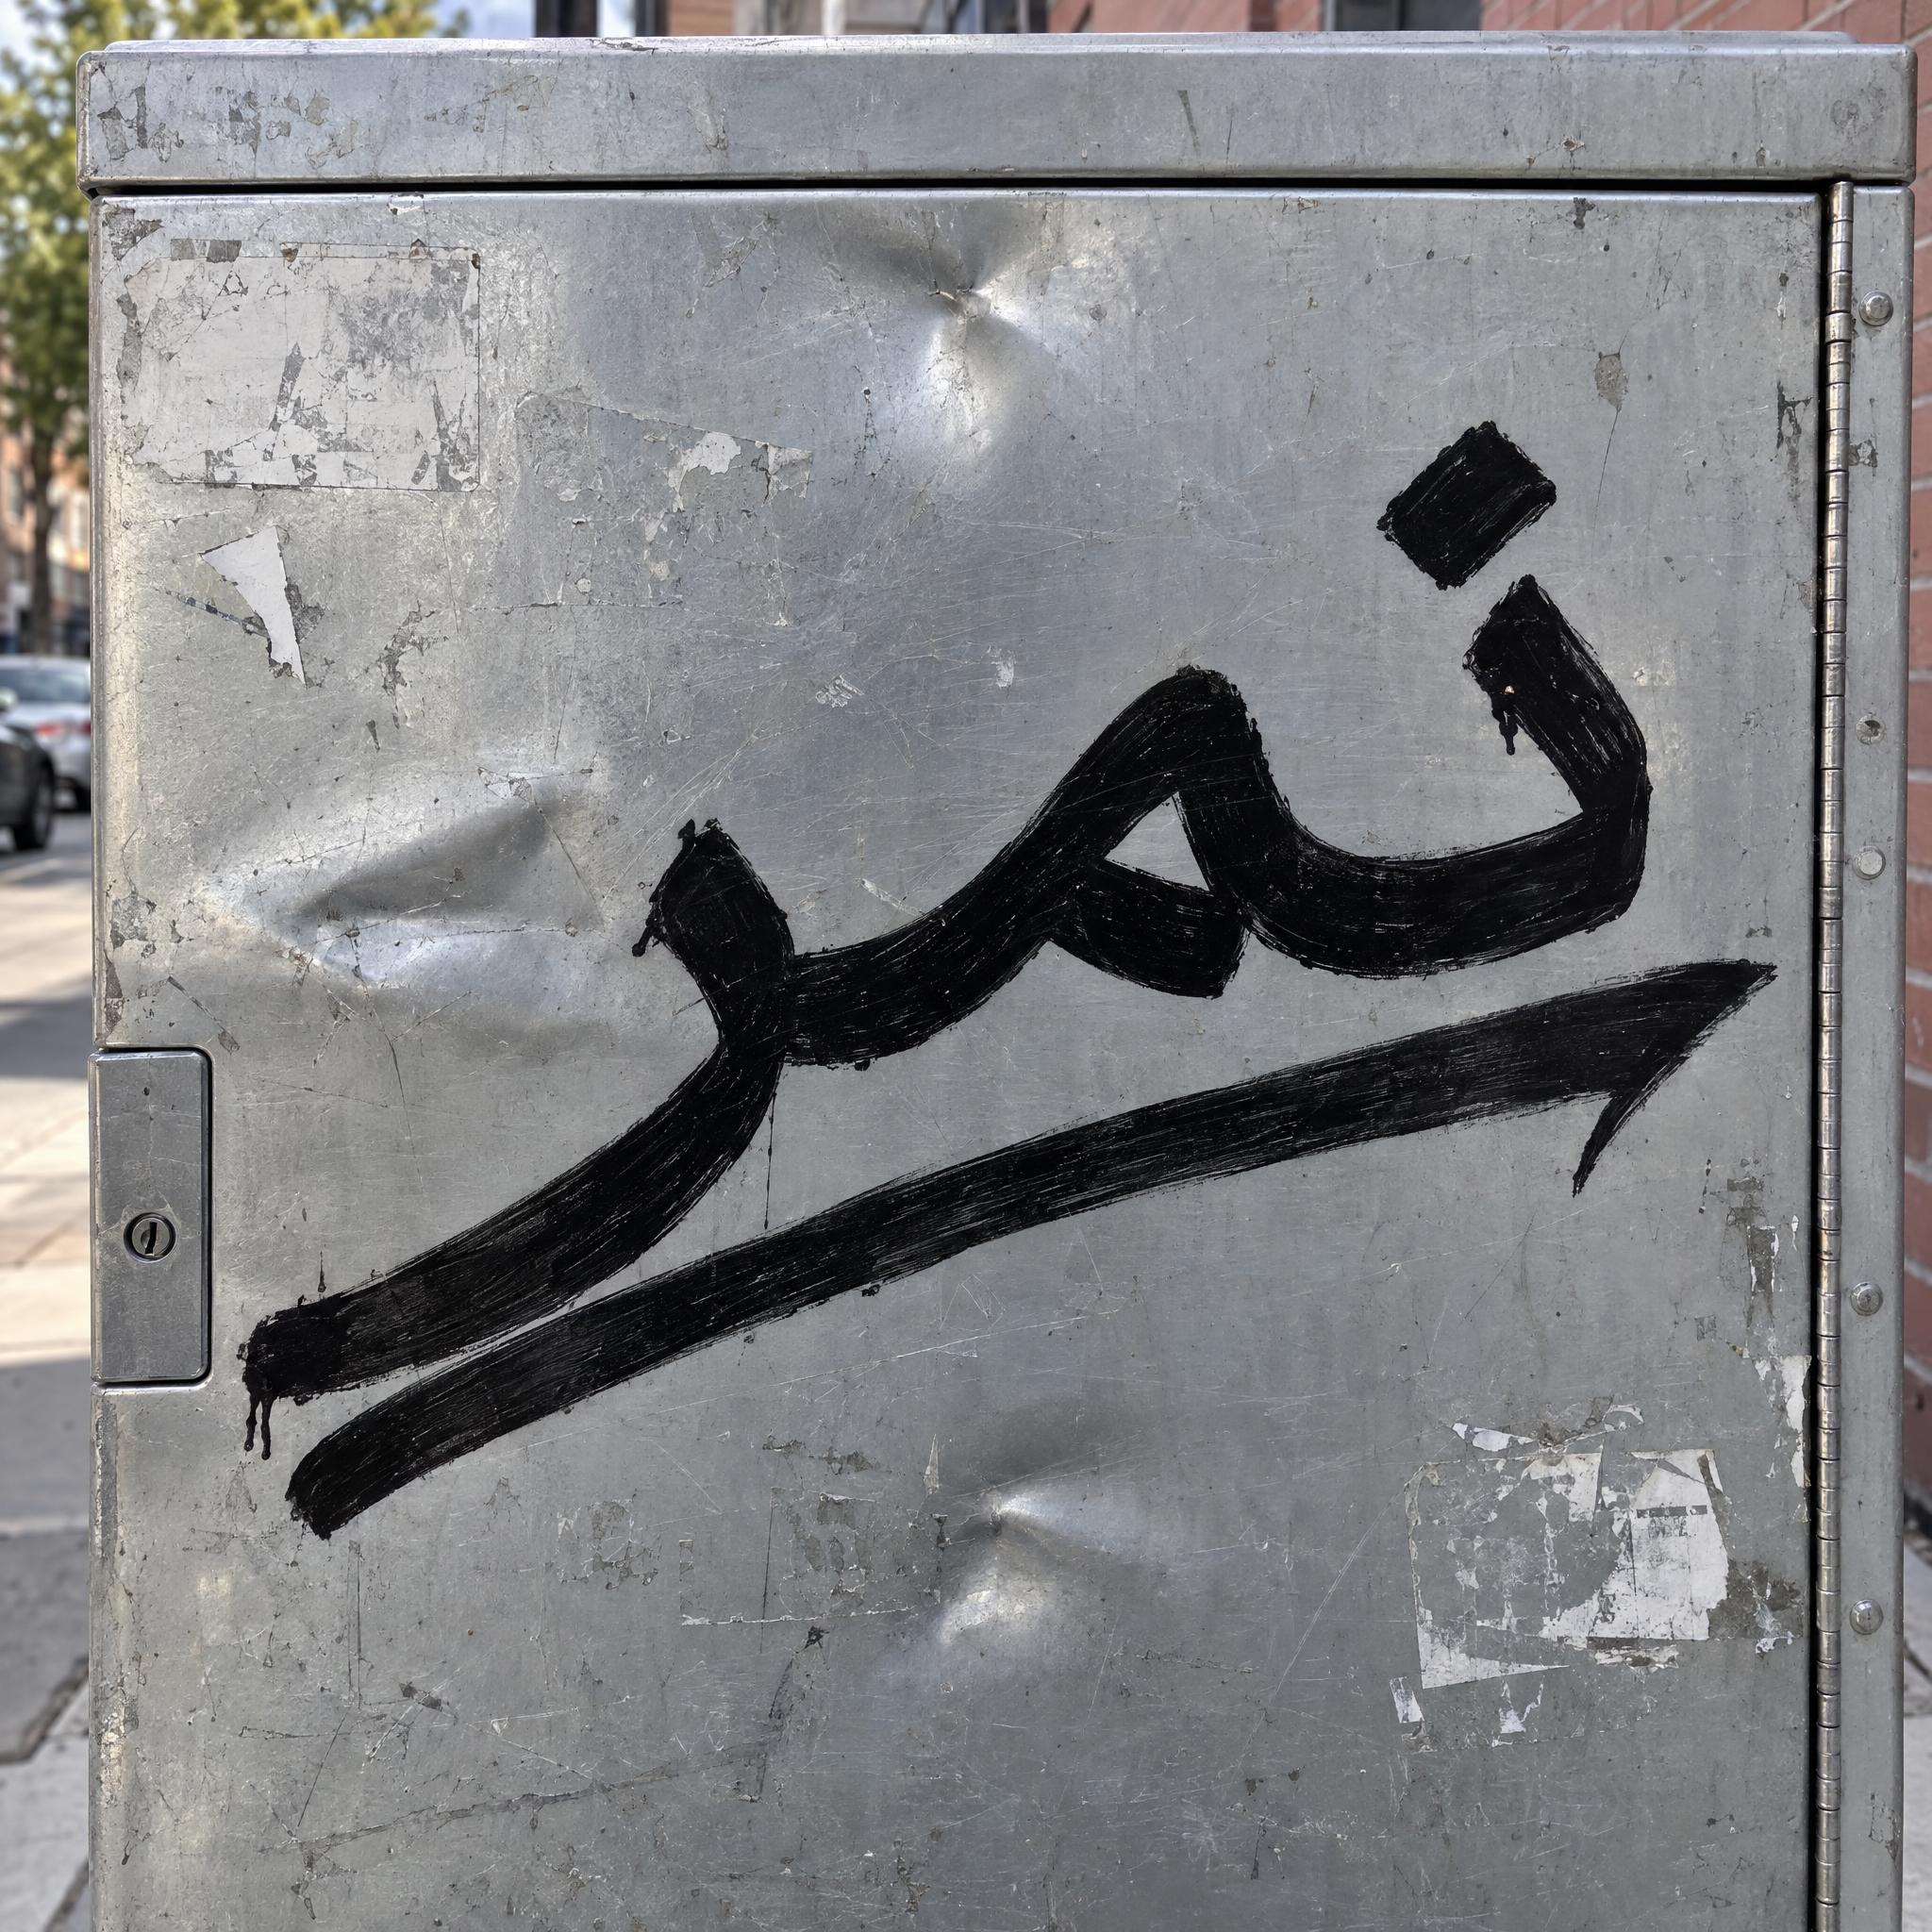
العربية أصعب نظام كتابة في هذا الاختبار. الحروف تتصل، ويتغيّر شكلها بحسب موضعها، وكثير منها لا يختلف إلا في عدد النقاط أو موضعها. موجّه واحد يكشف الفارق كله: كلمة نمر بخط الغرافيتي على صندوق كهرباء في الشارع.
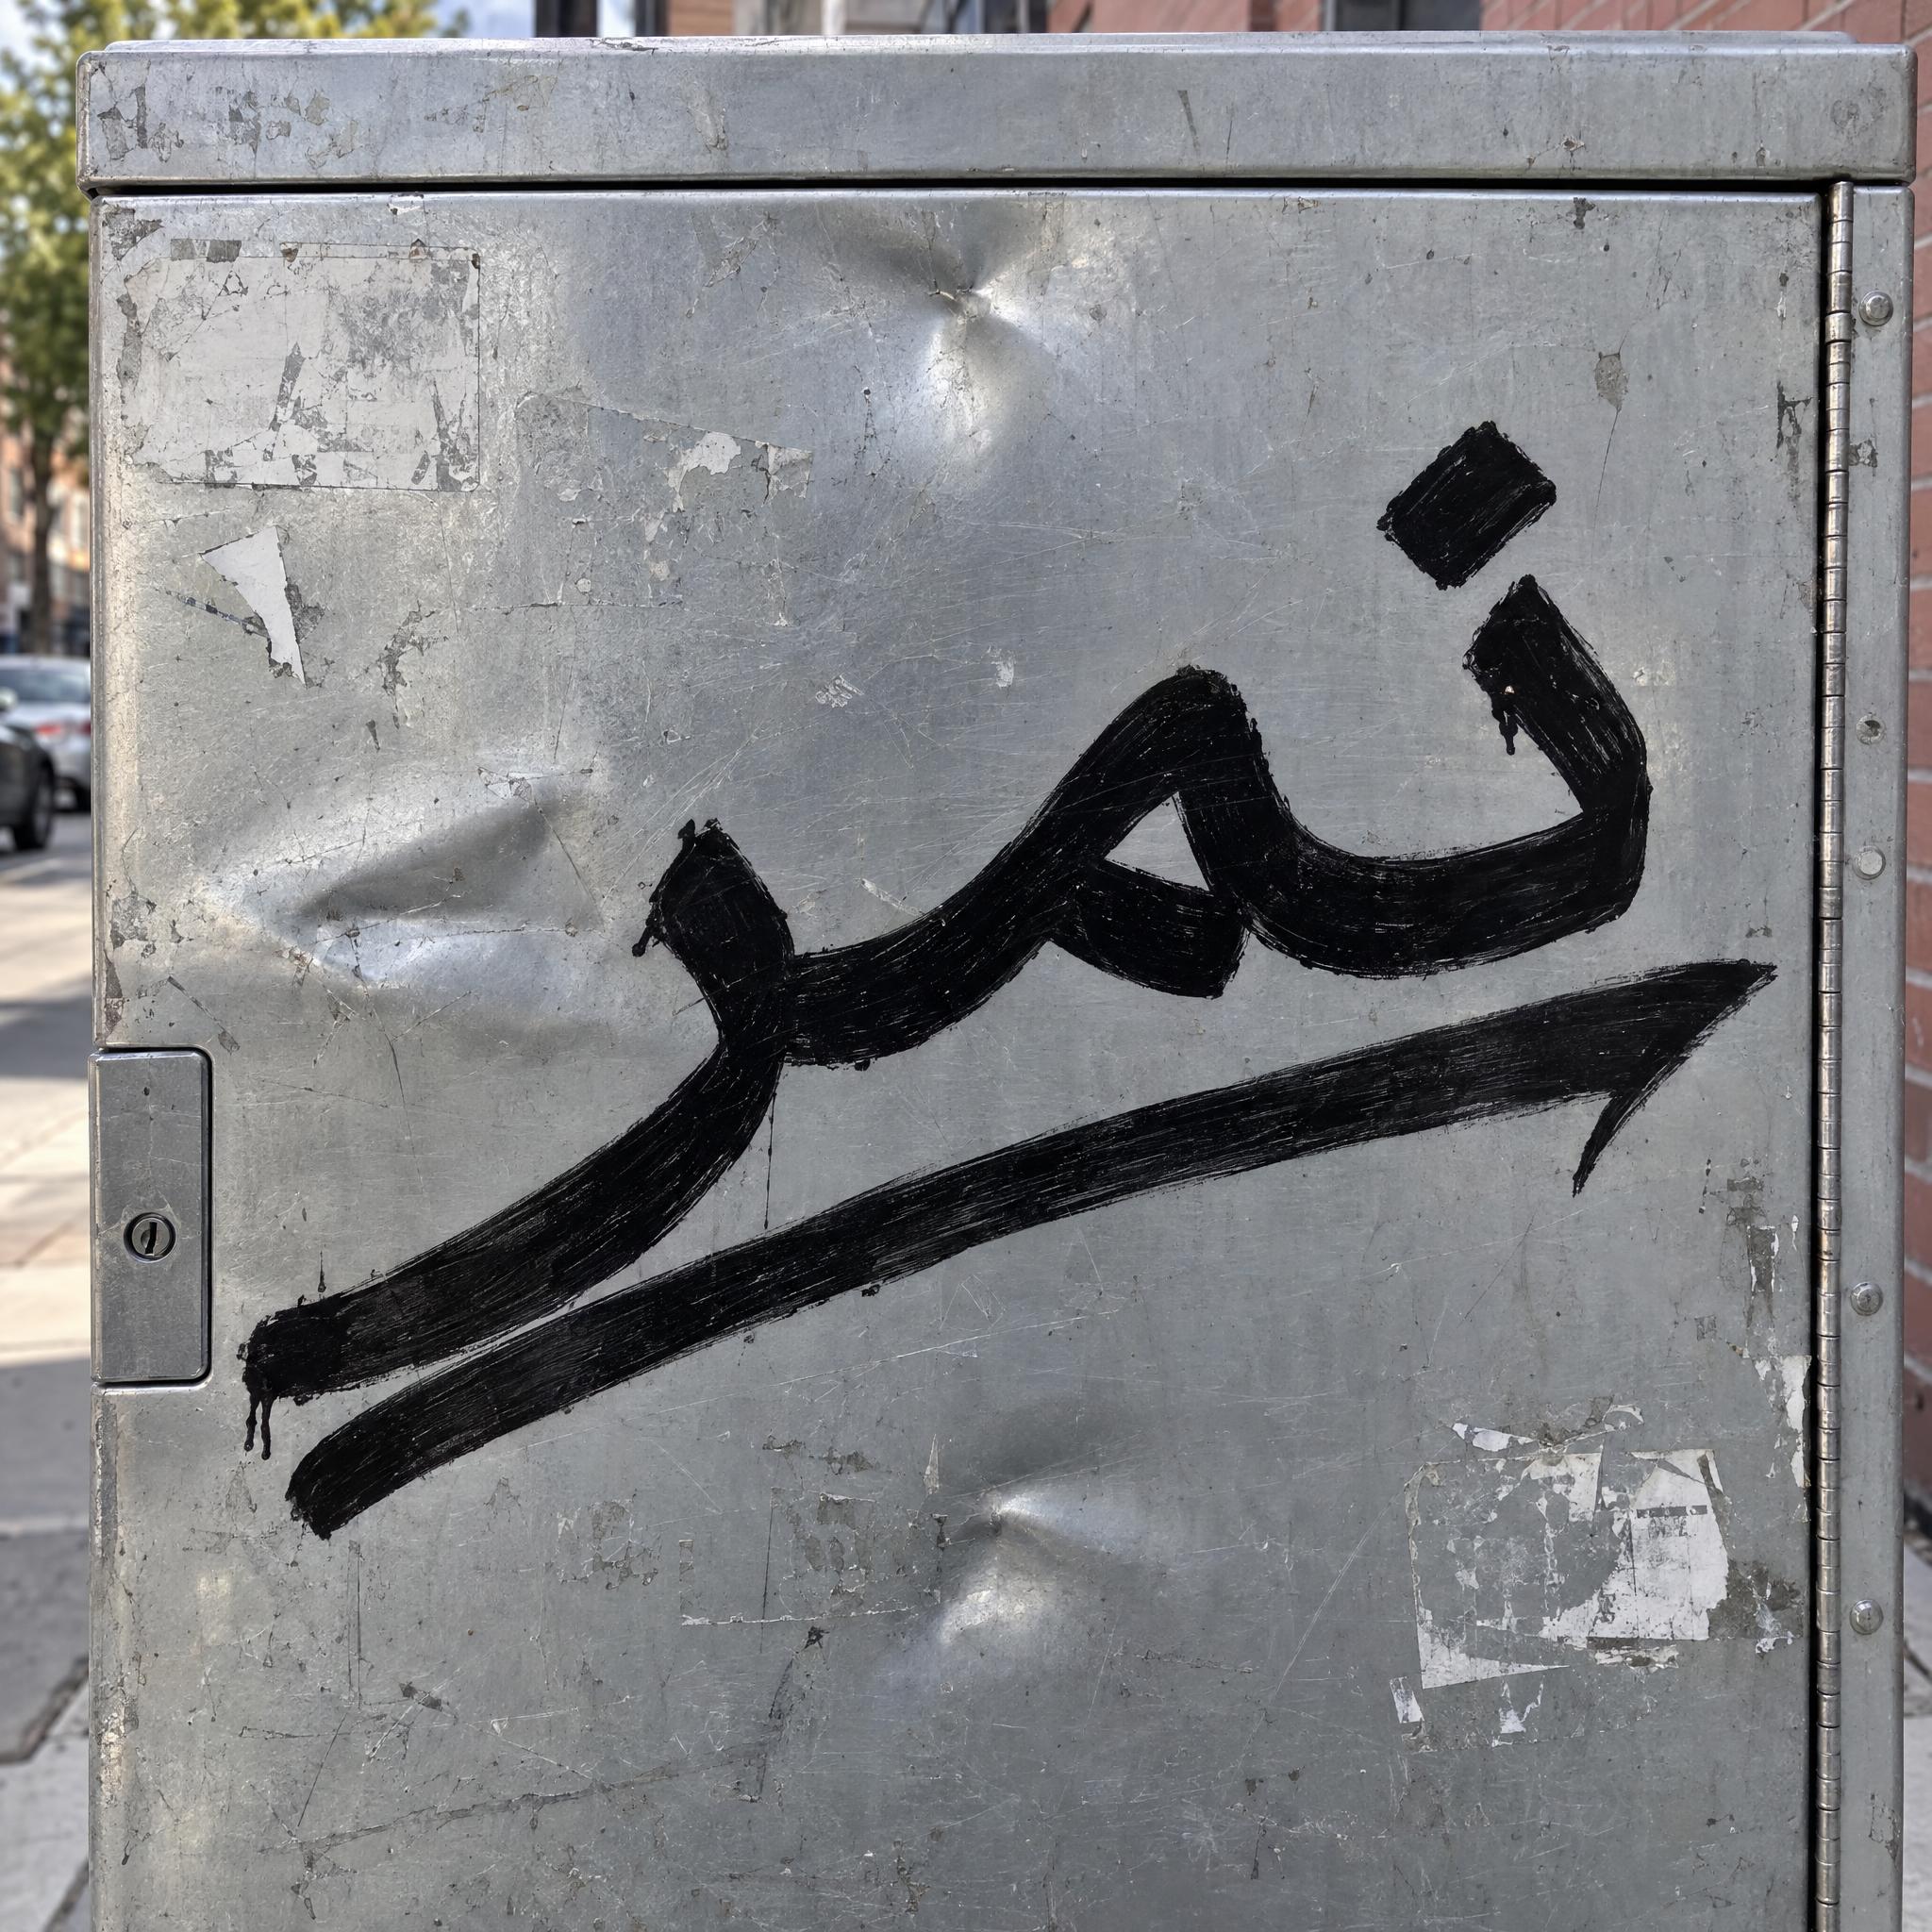
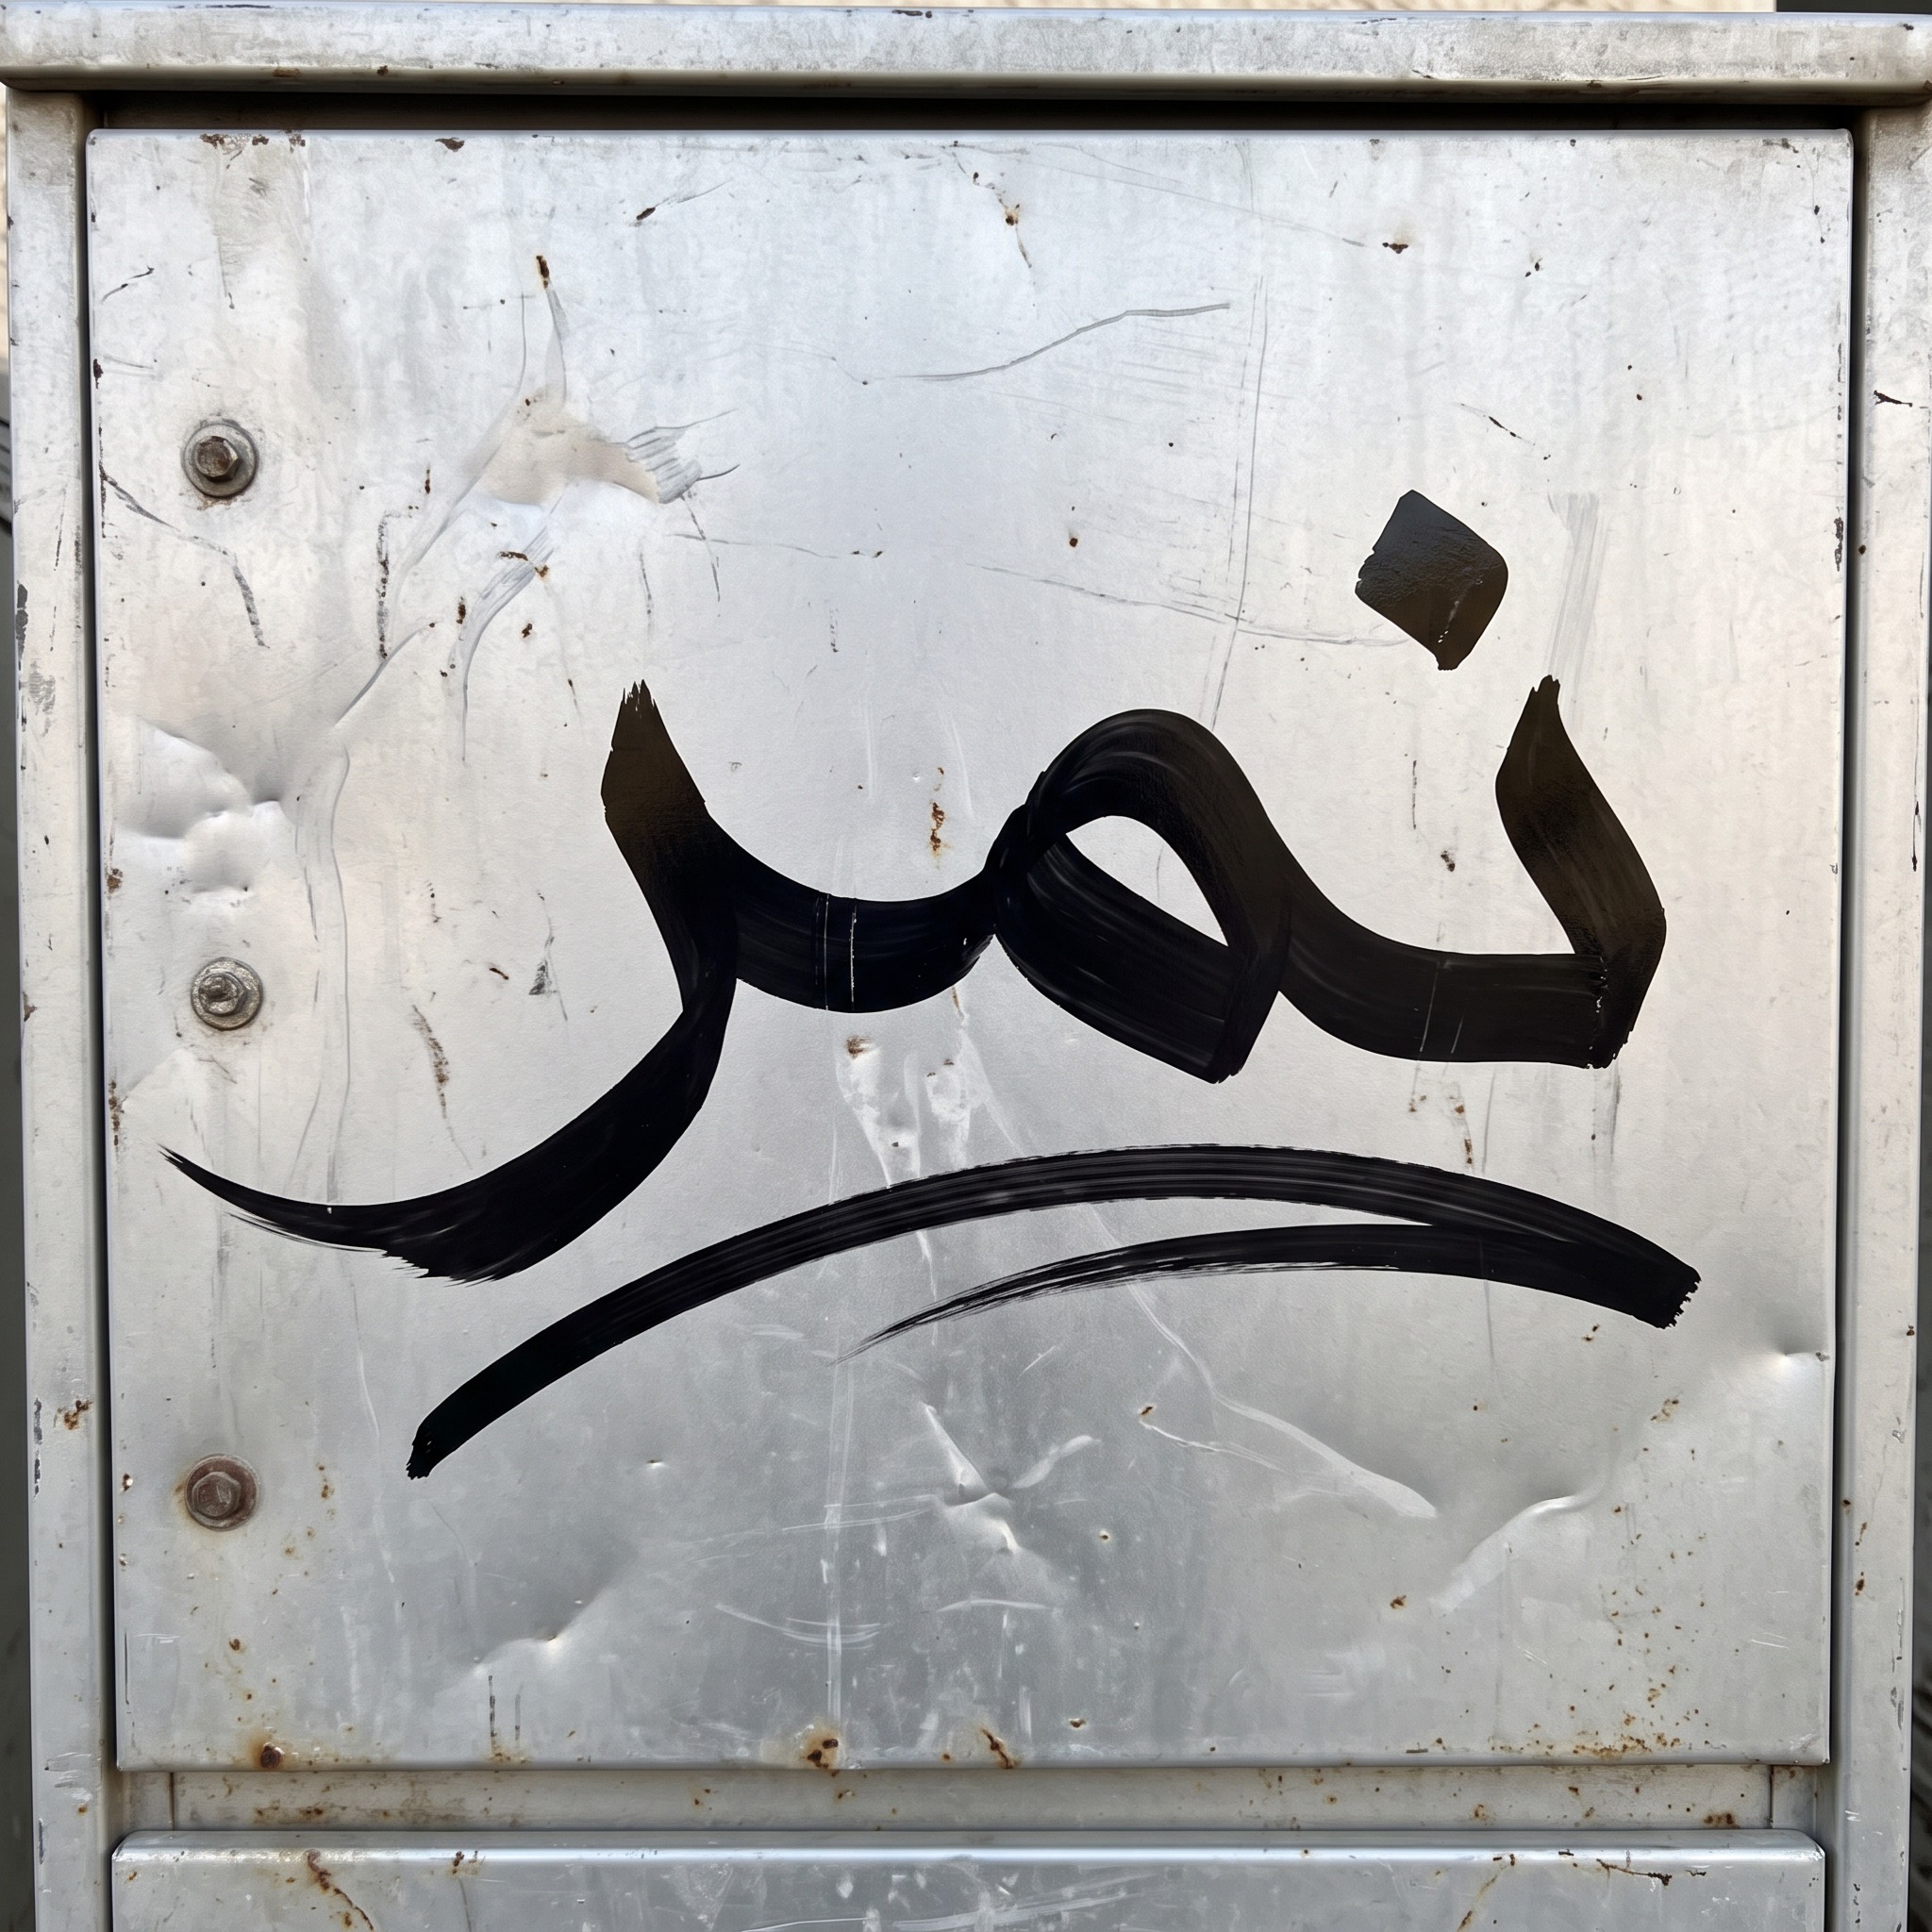
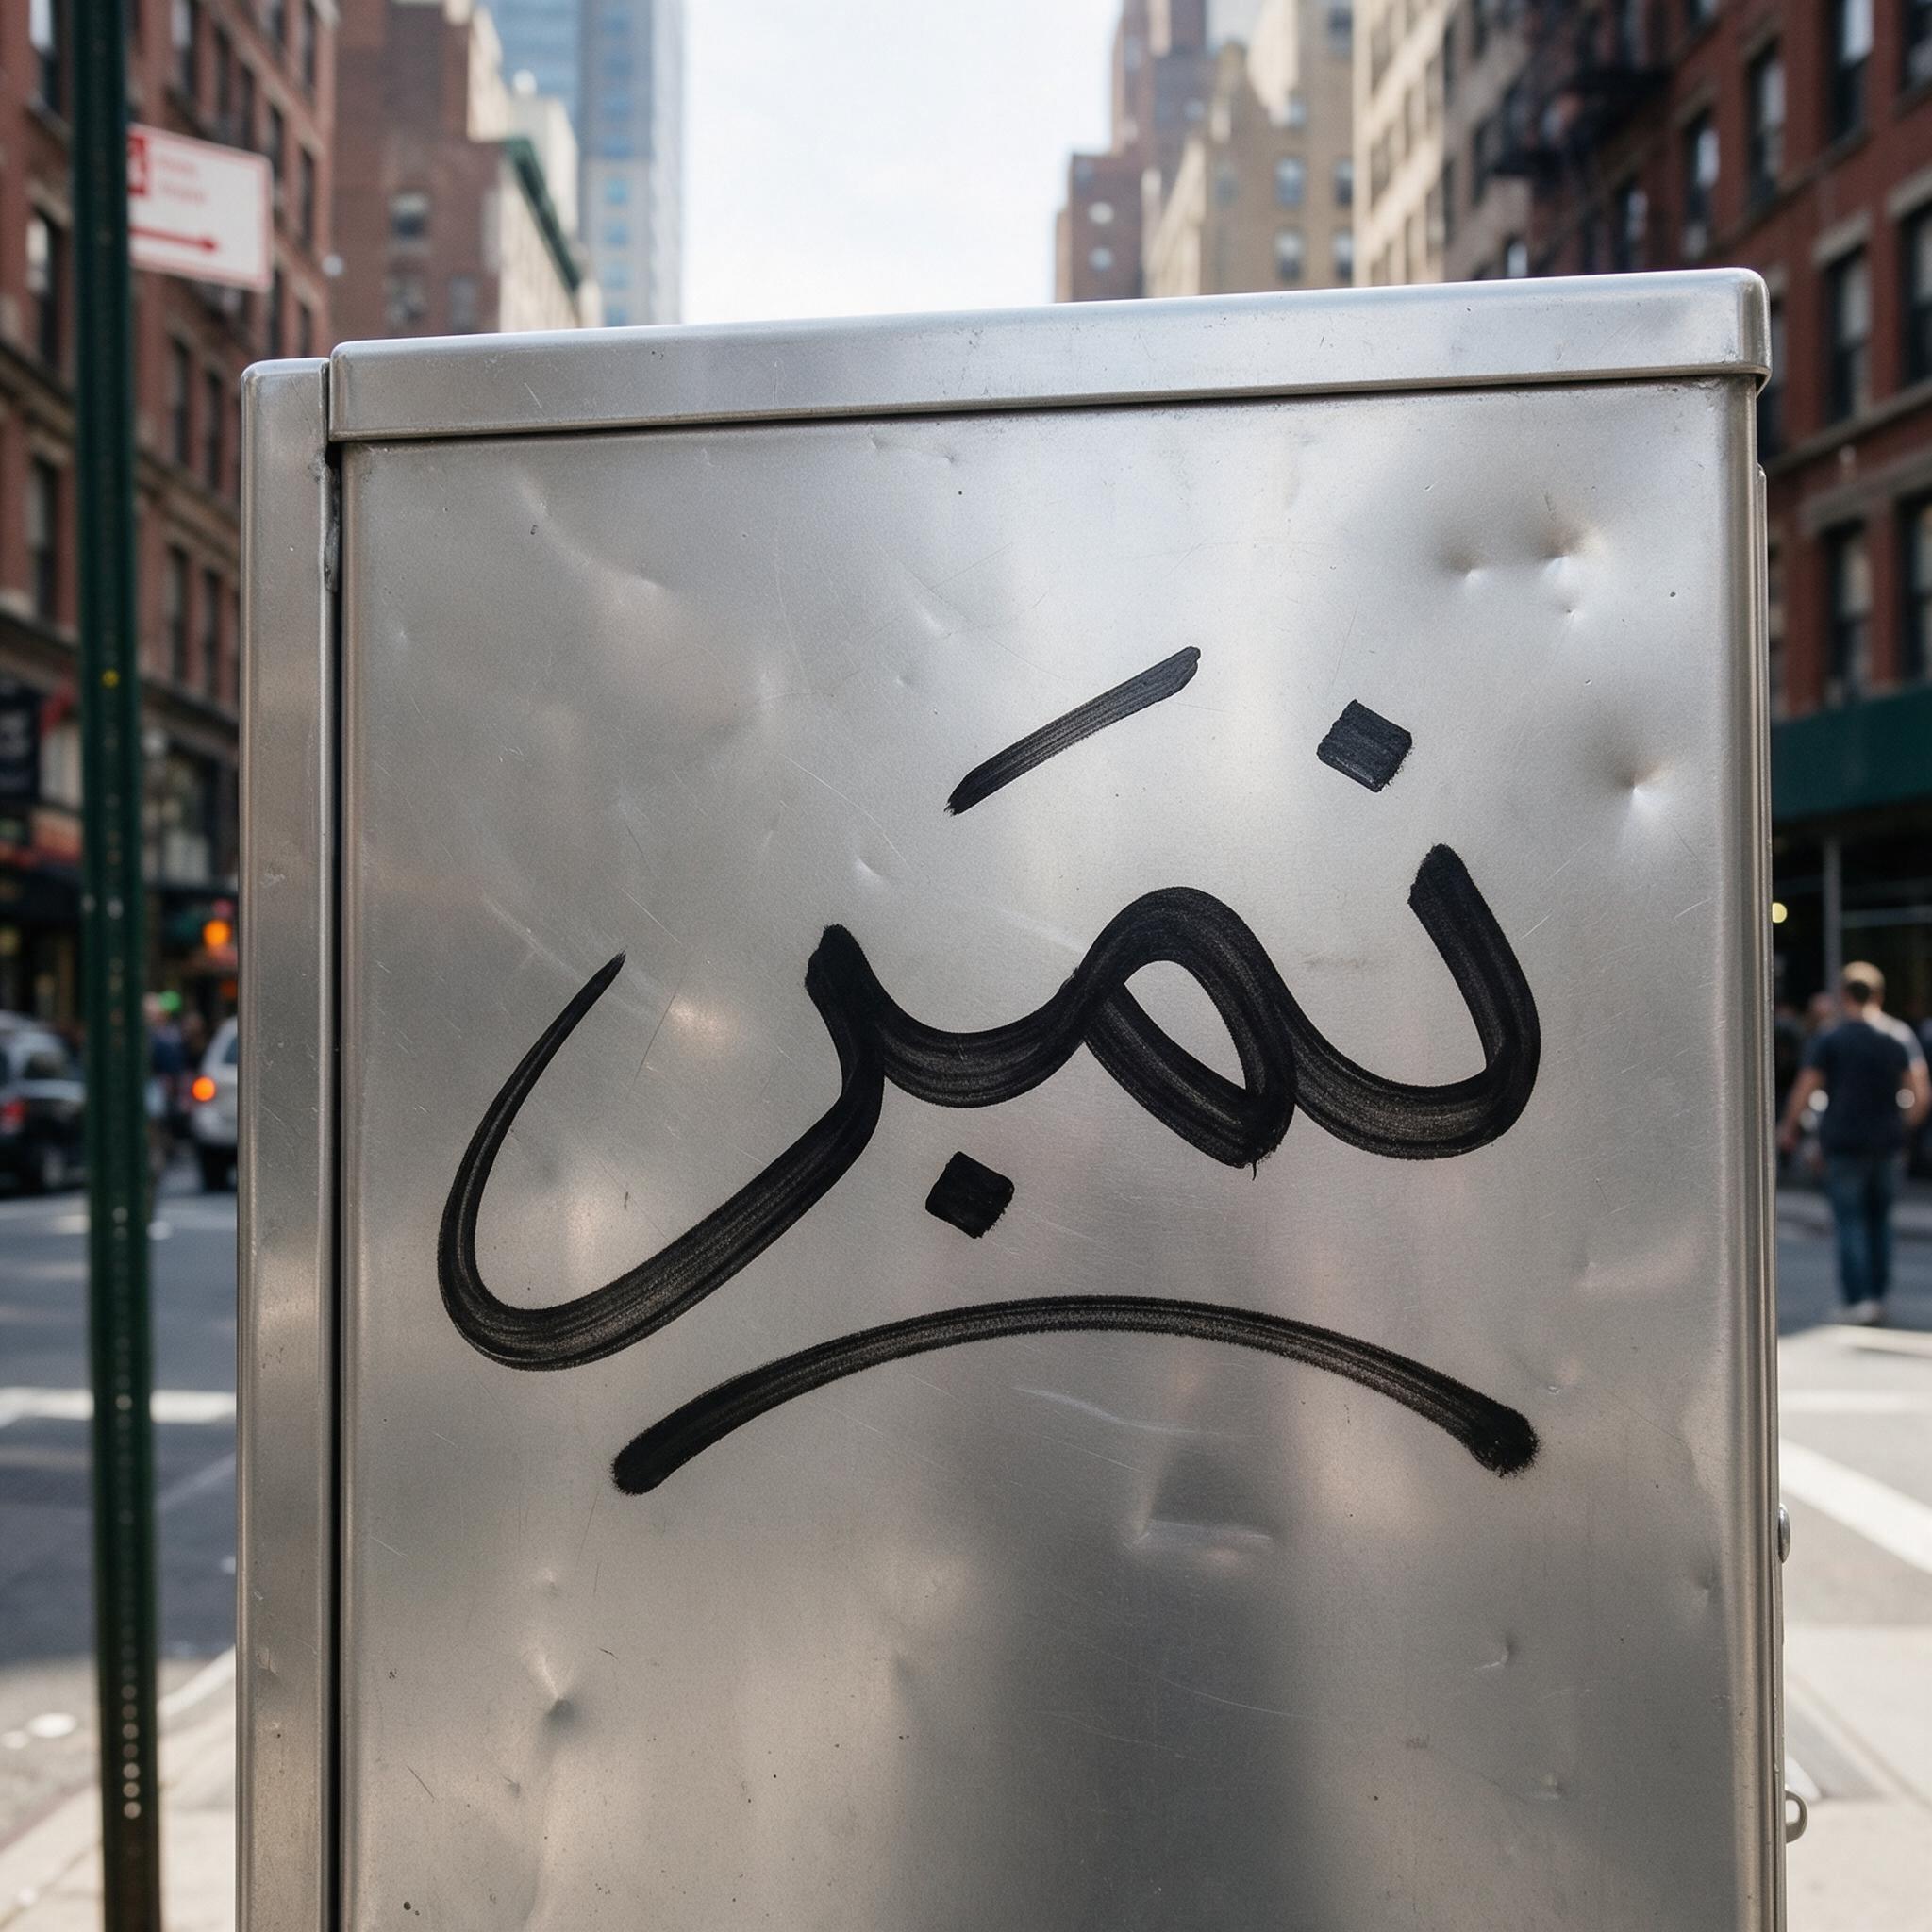
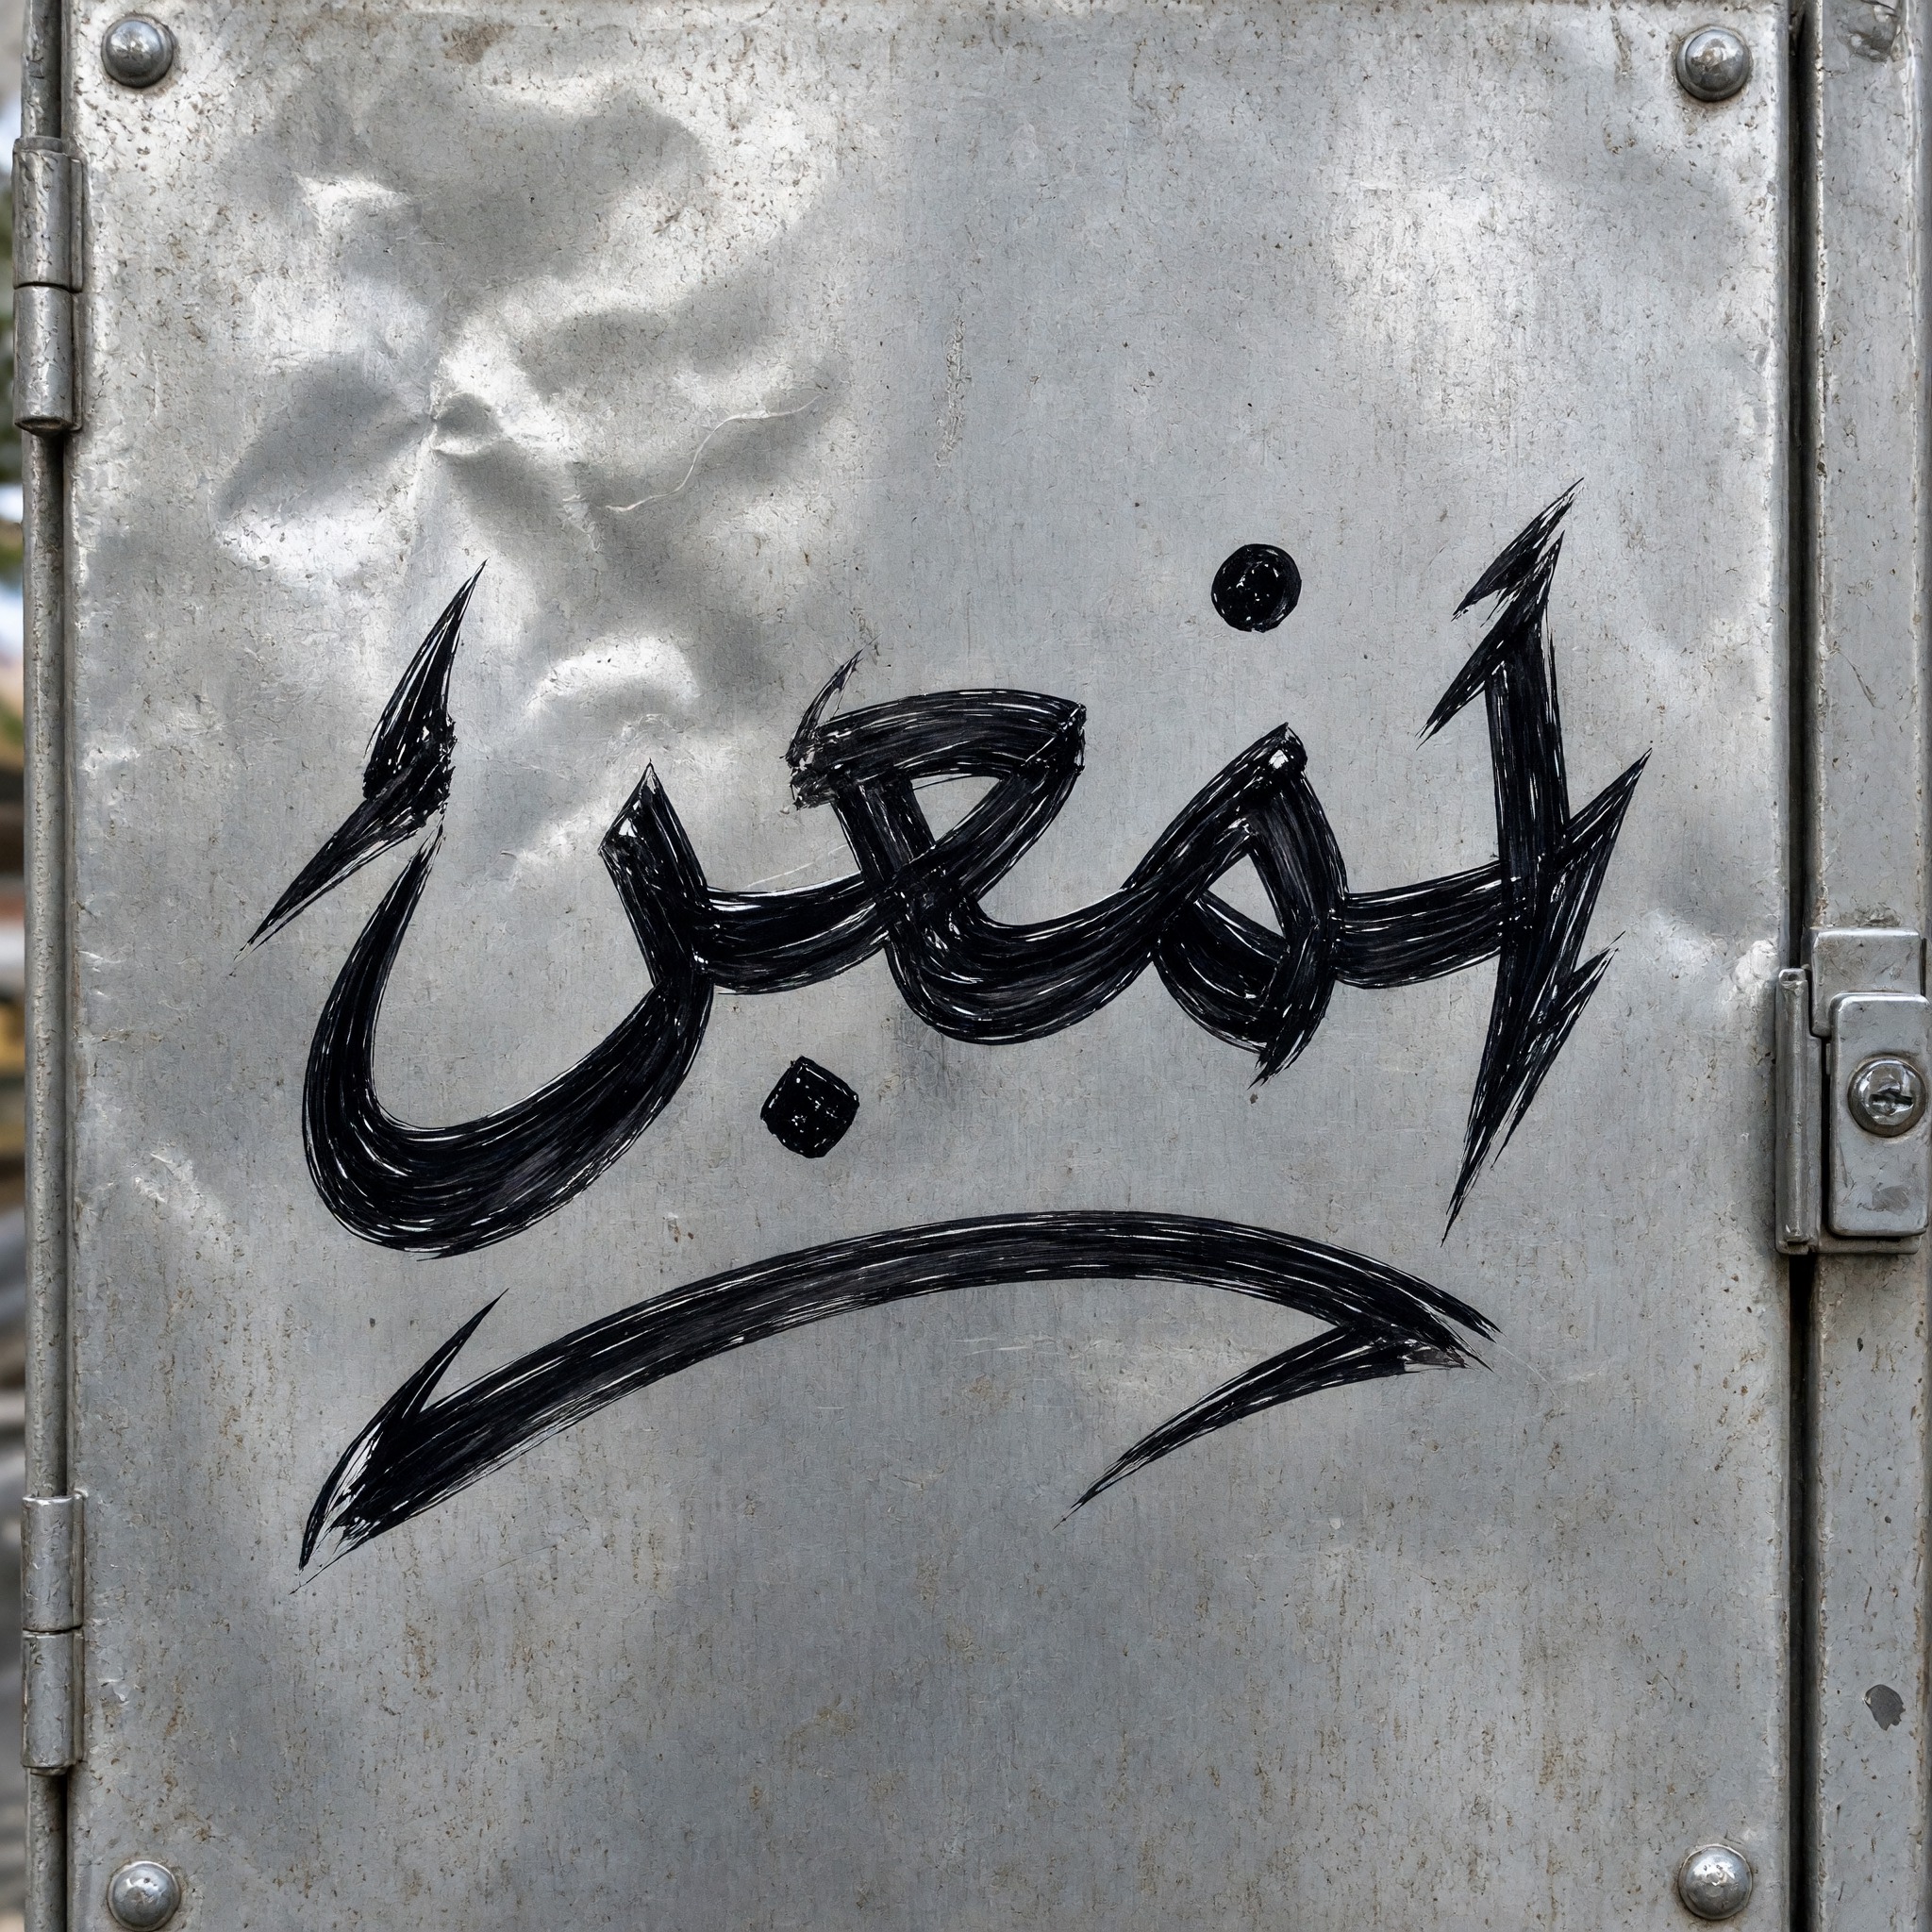
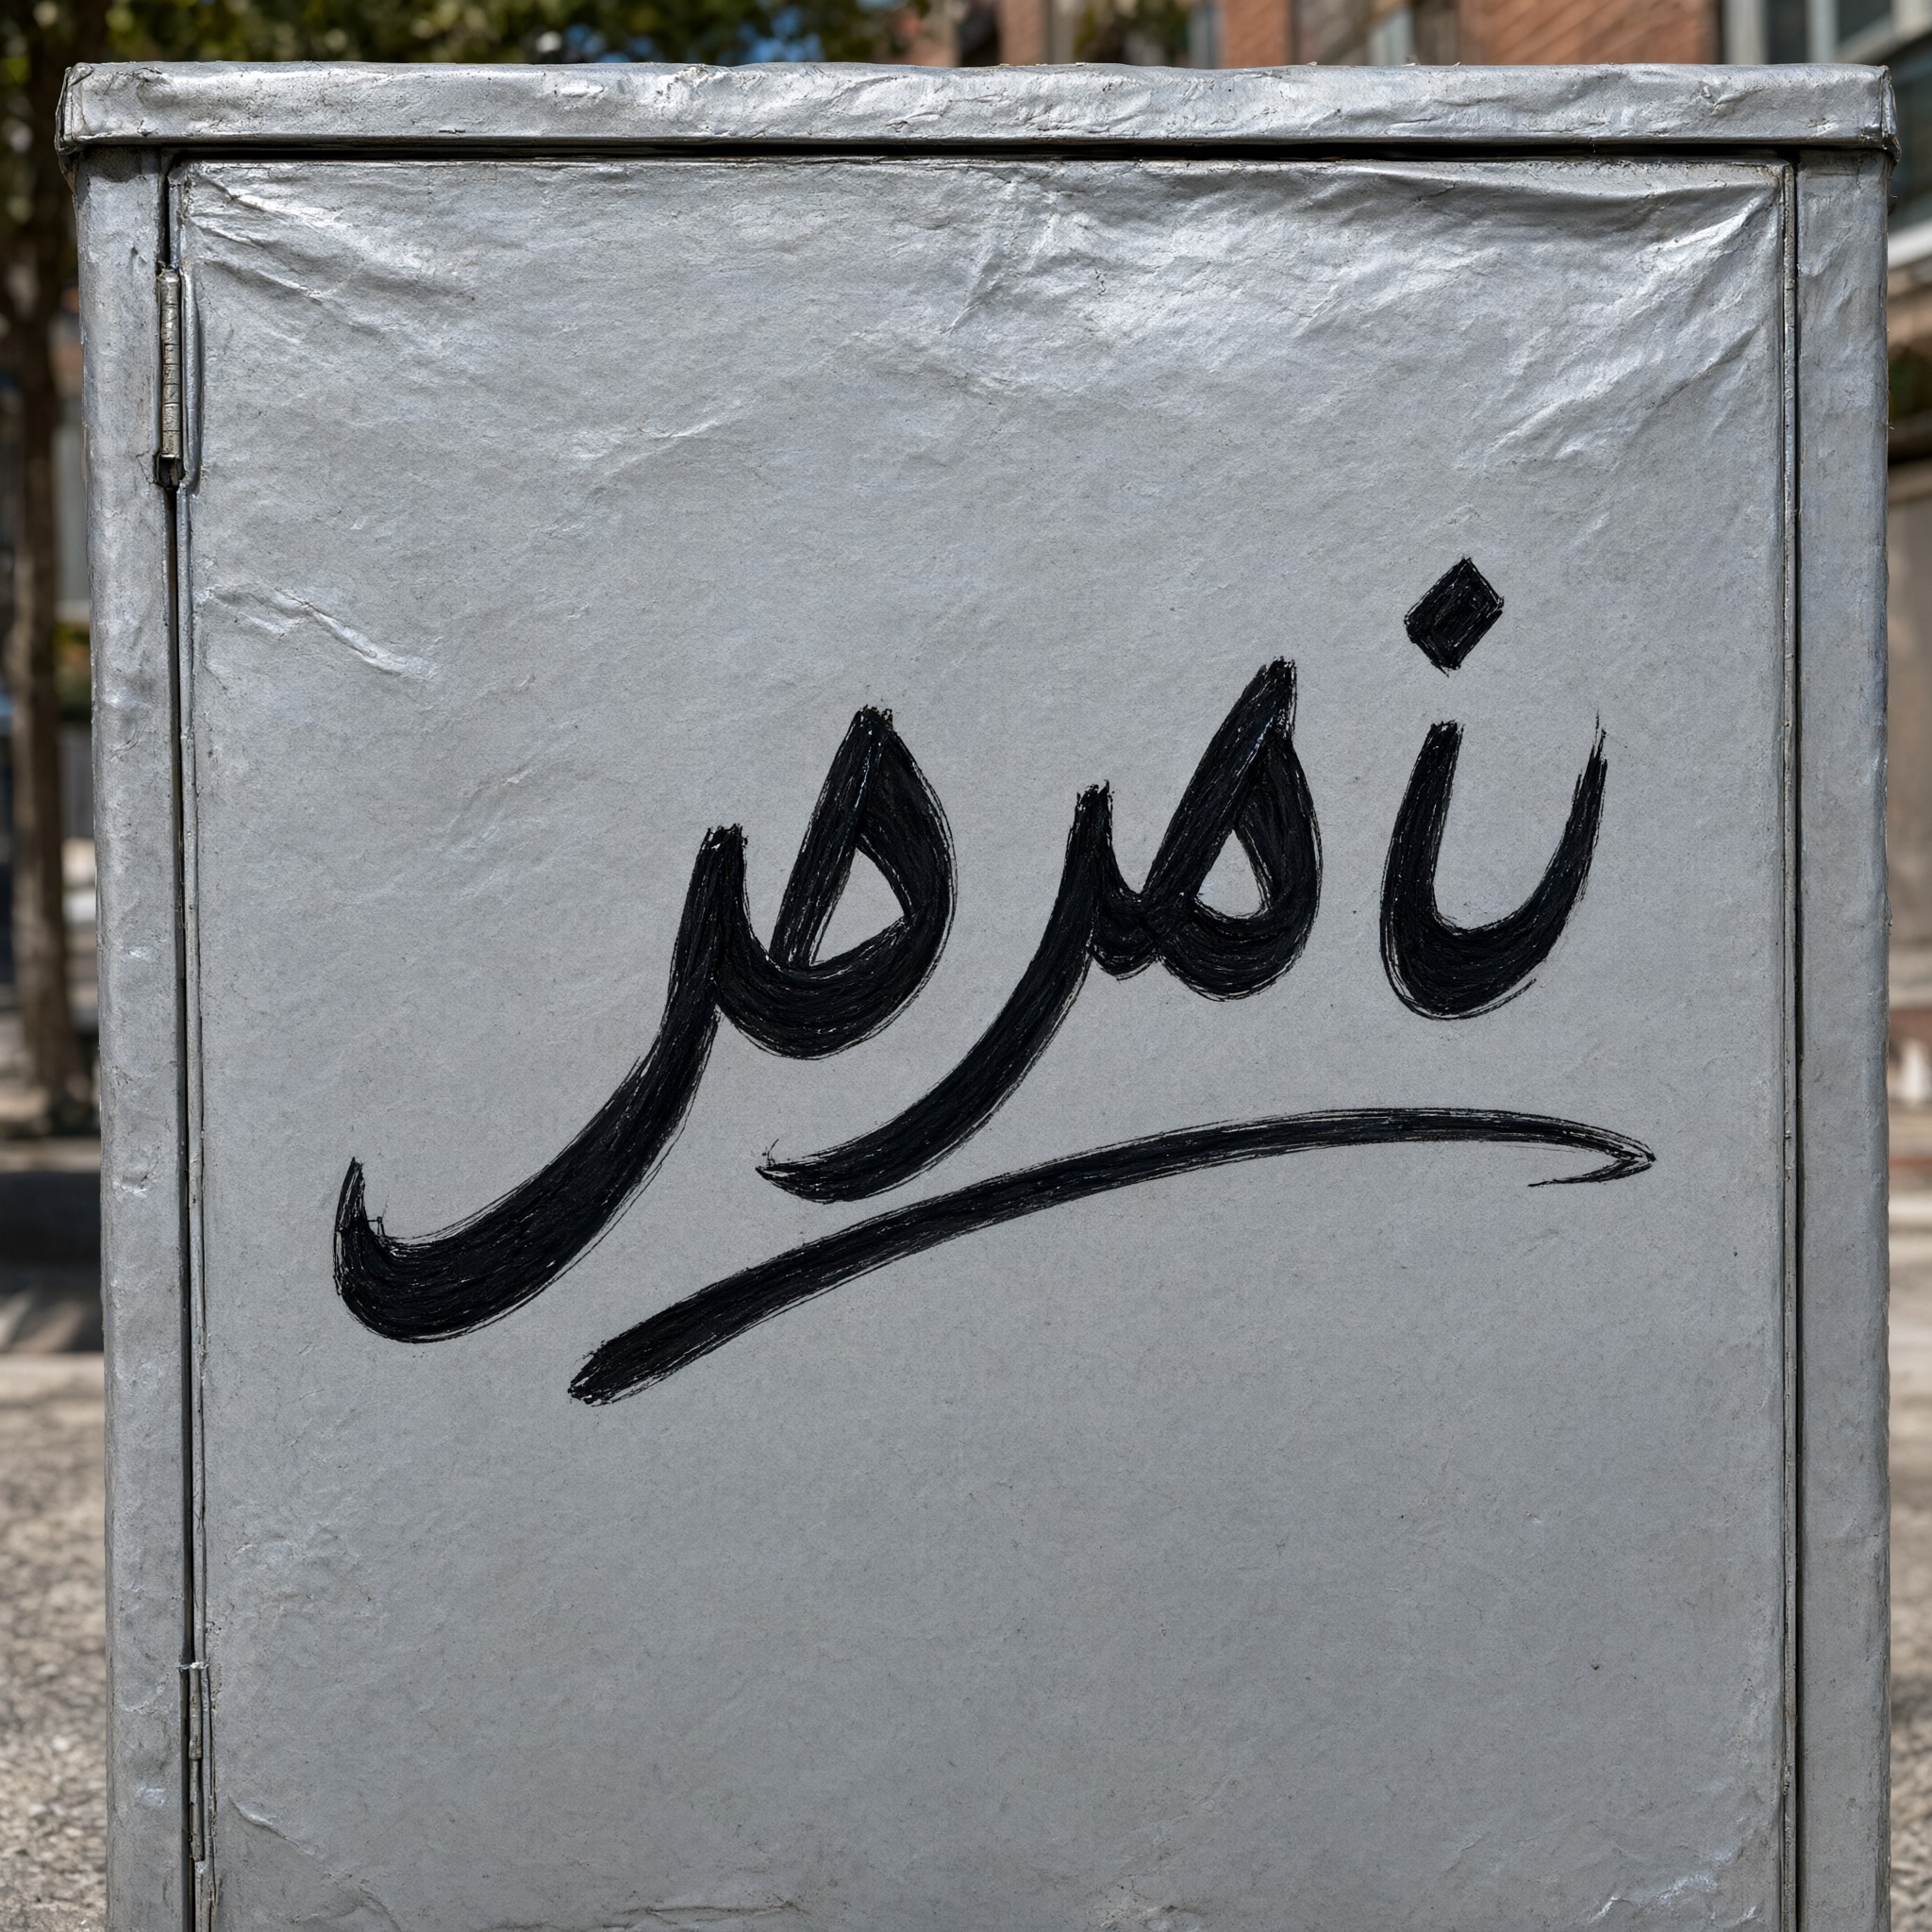
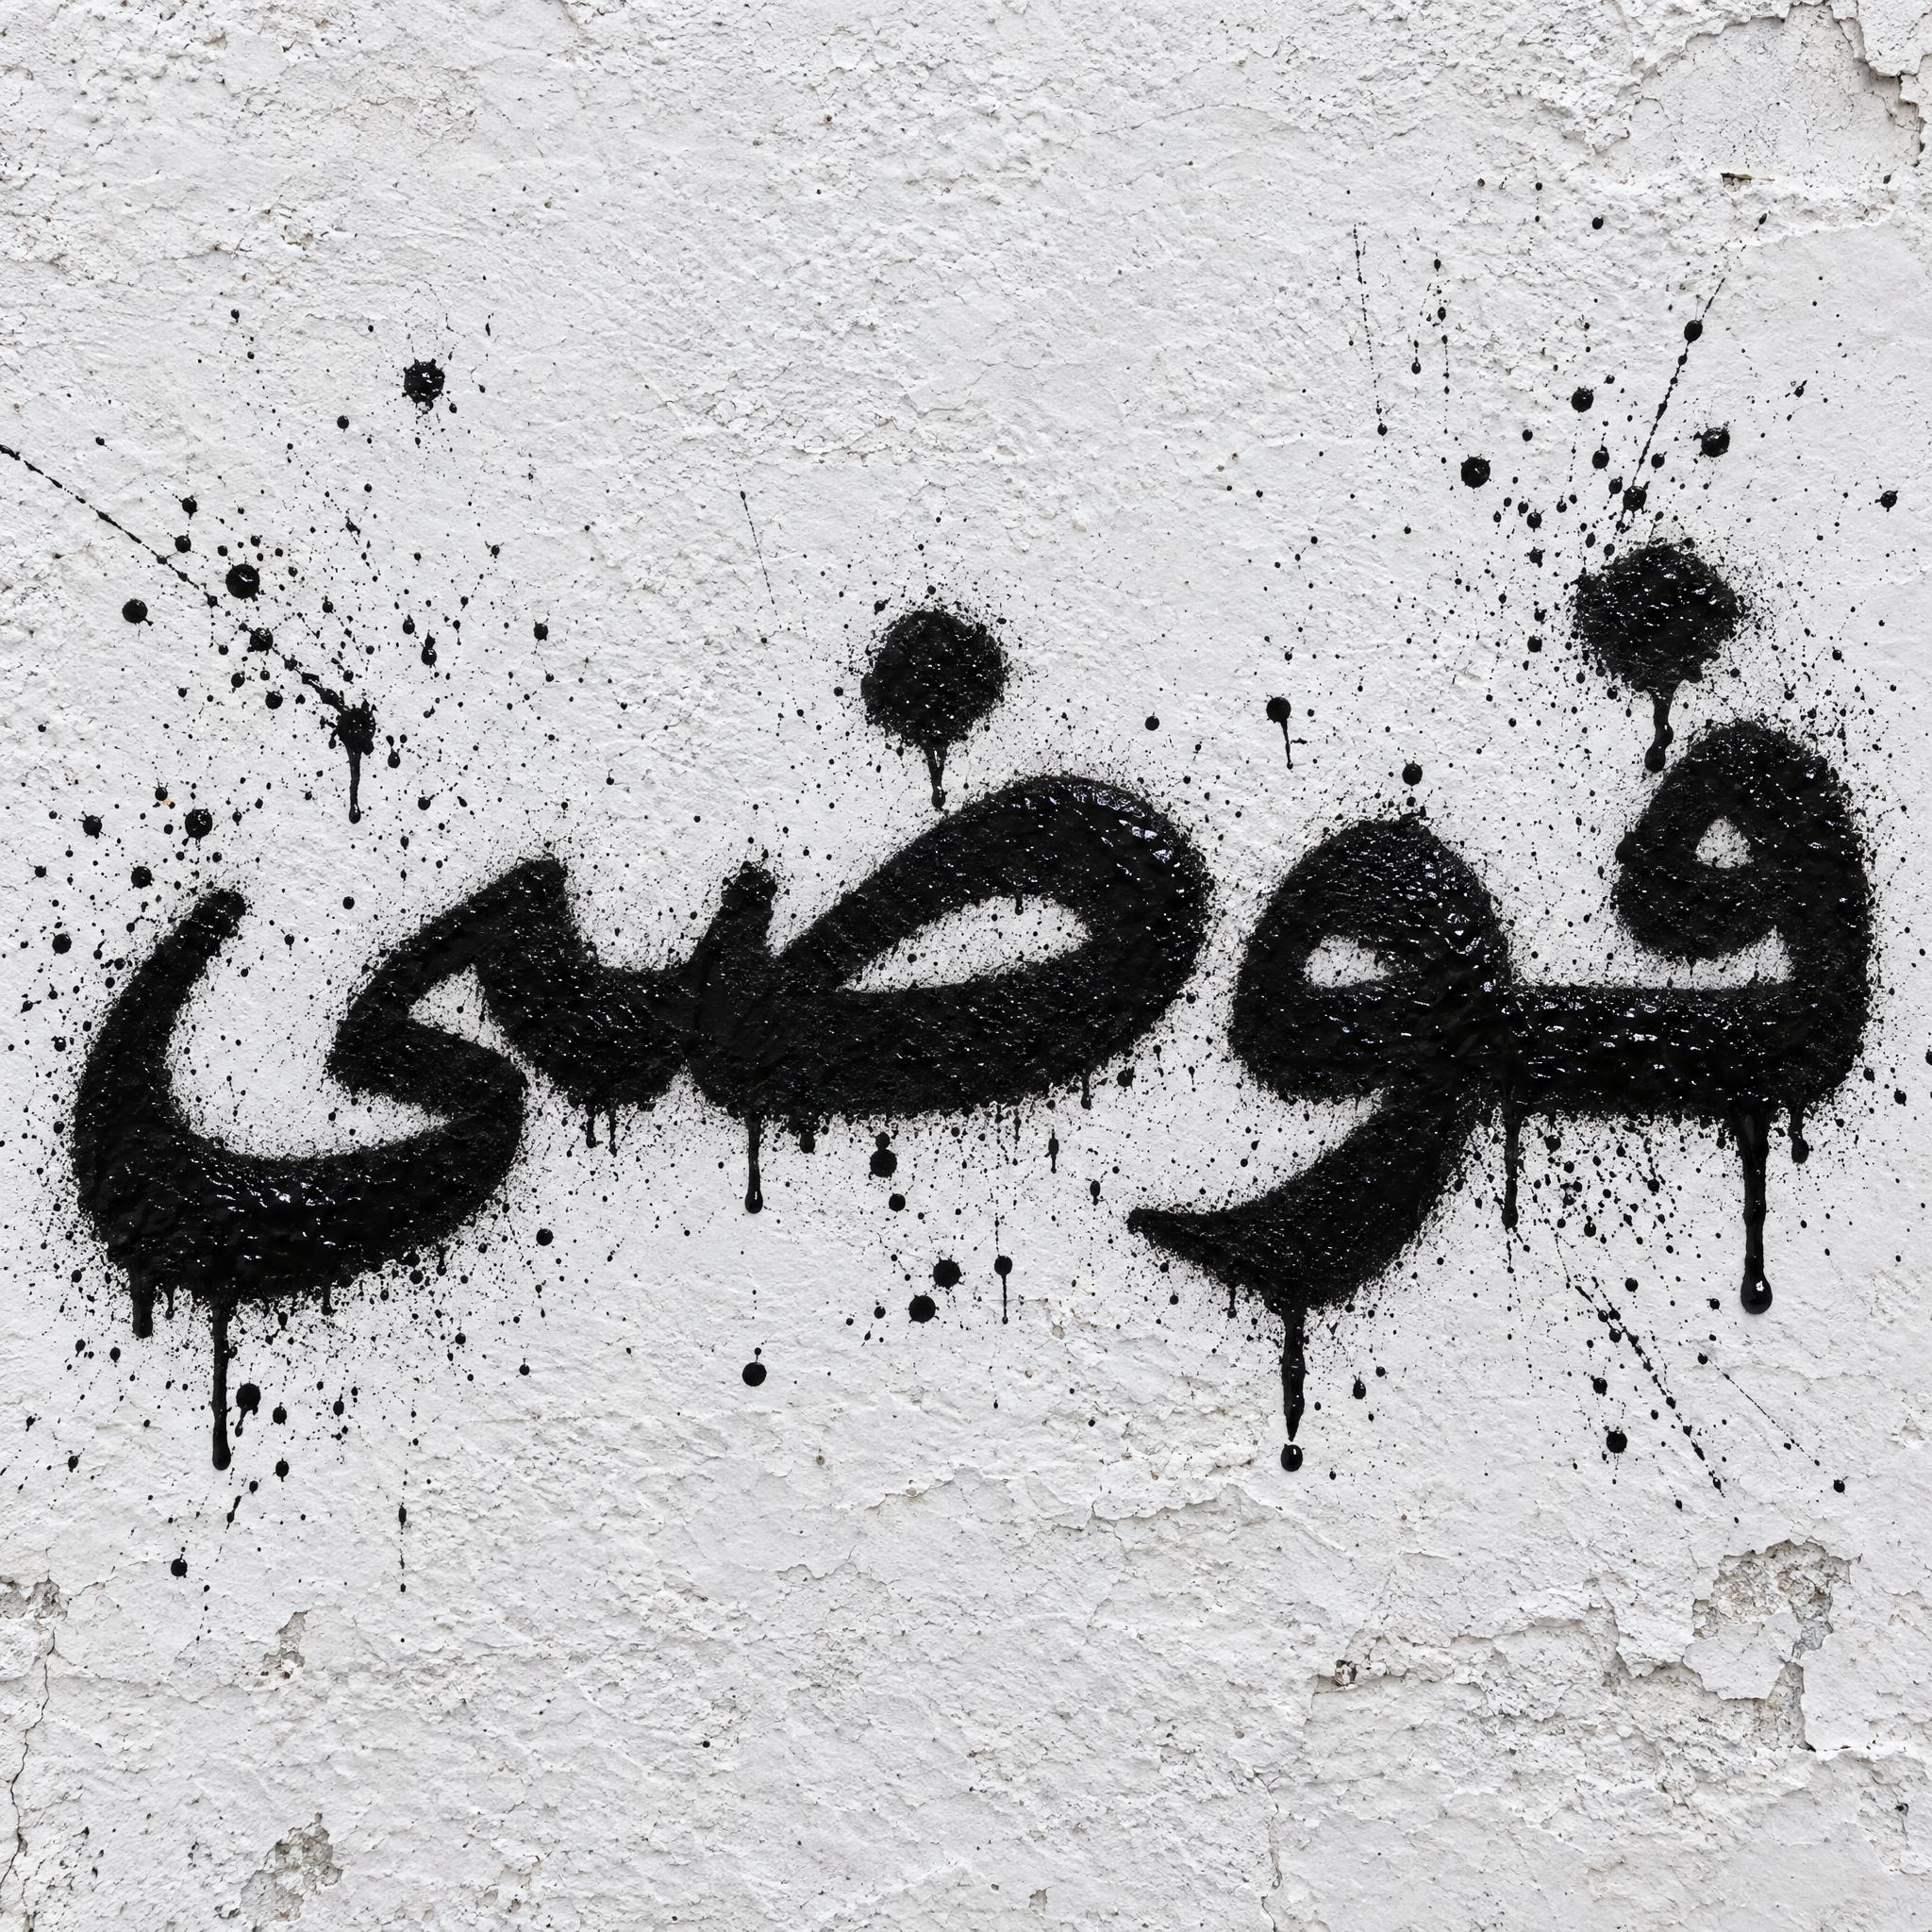
يخسر Grok Imagine و Seedream نقاطهما في العربية بسبب النقاط والحروف الزائدة. من أخطاء Grok الـ14 في العربية، 6 نقطة ناقصة أو زائدة أو في غير موضعها، و5 حرف زائد؛ ومن أخطاء Seedream الـ20، 9 في النقاط و7 حروف زائدة. في موجّه خبز الزنجبيل، نثر النموذجان قطع بسكويت مستديرة فوق كلمة كعك وحولها، فصارت تُقرأ نقاطًا زائدة.
مشكلة Qwen-Image في العربية من نوع آخر. نادرًا ما يكتب الكلمة المطلوبة أصلًا؛ بل يكتب سطرًا من حروف عربية أخرى حولها أو مكانها.
أرقام العربية تحمل تحفّظًا. لا أحد من مراجعينا يقرأ العربية بوصفها لغته الأم، واستبعدنا 41 صورة اختلف فيها حكم الذكاء الاصطناعي عن حكم الإنسان. نحن واثقون من الترتيب، لأن الفارق بين 96% و11% أكبر بكثير من أي خطأ في المراجعة. أما النسب الدقيقة فقد تتغيّر حين يصحّح قرّاء أصليون مجموعة البيانات.
حتى المتصدّرون يخطئون
أخطاء GPT Image الثلاثة: VENON بدلًا من VENOM على قميص ديث ميتال، وكلمتان عربيتان، إحداهما بحرف أخير خاطئ (تحيئ بدلًا من تحية) والأخرى بحرف ساقط (فتة بدلًا من فتنة).
وخطآ Nano Banana: كلمة يابانية فيها حرف واحد مشوّه، وصورة صينية لعيد الهالوين أضافت ثلاث لافتات صغيرة كُتب عليها «PARTY!» حول الكلمة المطلوبة 南瓜. الكلمة نفسها كانت صحيحة؛ لكن النص الزائد خالف قاعدتنا.
هل تفيد إعادة التشغيل؟
جزئيًّا، وبحسب النموذج. أحصينا الحالات التي كانت فيها الصورة الأولى خاطئة، وتحققنا مما إذا كانت محاولة إضافية واحدة قد أصلحتها.
| الصورة الأولى خاطئة | صُحّحت بمحاولة إضافية واحدة | |
|---|---|---|
| GPT Image | 3 | 1 |
| Nano Banana | 2 | 2 |
| Grok Imagine | 28 | 13 |
| Seedream | 36 | 18 |
| Qwen-Image | 86 | 10 |
يرتكب Grok Imagine و Seedream أخطاء في التفاصيل، نقطة أو جرّة قلم، ويختفي نحو نصفها في المحاولة الثانية. أما عادة Qwen-Image في إضافة النص فتصمد أمام الإعادة: لم يُصلَح سوى 10 من 86. إذا ظل النموذج يضيف نصًّا، فإعادة صياغة الموجّه تفيد أكثر من إعادة تشغيله.
أي نموذج لتوليد الصور بالذكاء الاصطناعي تستخدم للنصوص؟
- أي لغة، ومحاولة واحدة: GPT Image أو Nano Banana. اختر بحسب الأسلوب البصري. دقة النص ليست سببًا لتفضيل أحدهما على الآخر.
- الإنجليزية أو الصينية فقط: النماذج الخمسة كلها تصلح. Grok Imagine و Seedream خياران جيدان إن أعجبك أسلوبهما؛ راجع النتيجة قبل الطباعة.
- اليابانية: GPT Image أو Nano Banana. وإلا فاقرأ كل حرف كانا وتحقق من الداكوتين.
- العربية: GPT Image أو Nano Banana. لن ننشر نصًّا عربيًّا من النماذج الثلاثة الأخرى من دون أن يراجعه قارئ عربي أصلي.
- Qwen-Image: اجعل كلمة العرض قصيرة، وافحص الصورة كلها بحثًا عن حروف زائدة، لا الكلمة التي طلبتها فقط.
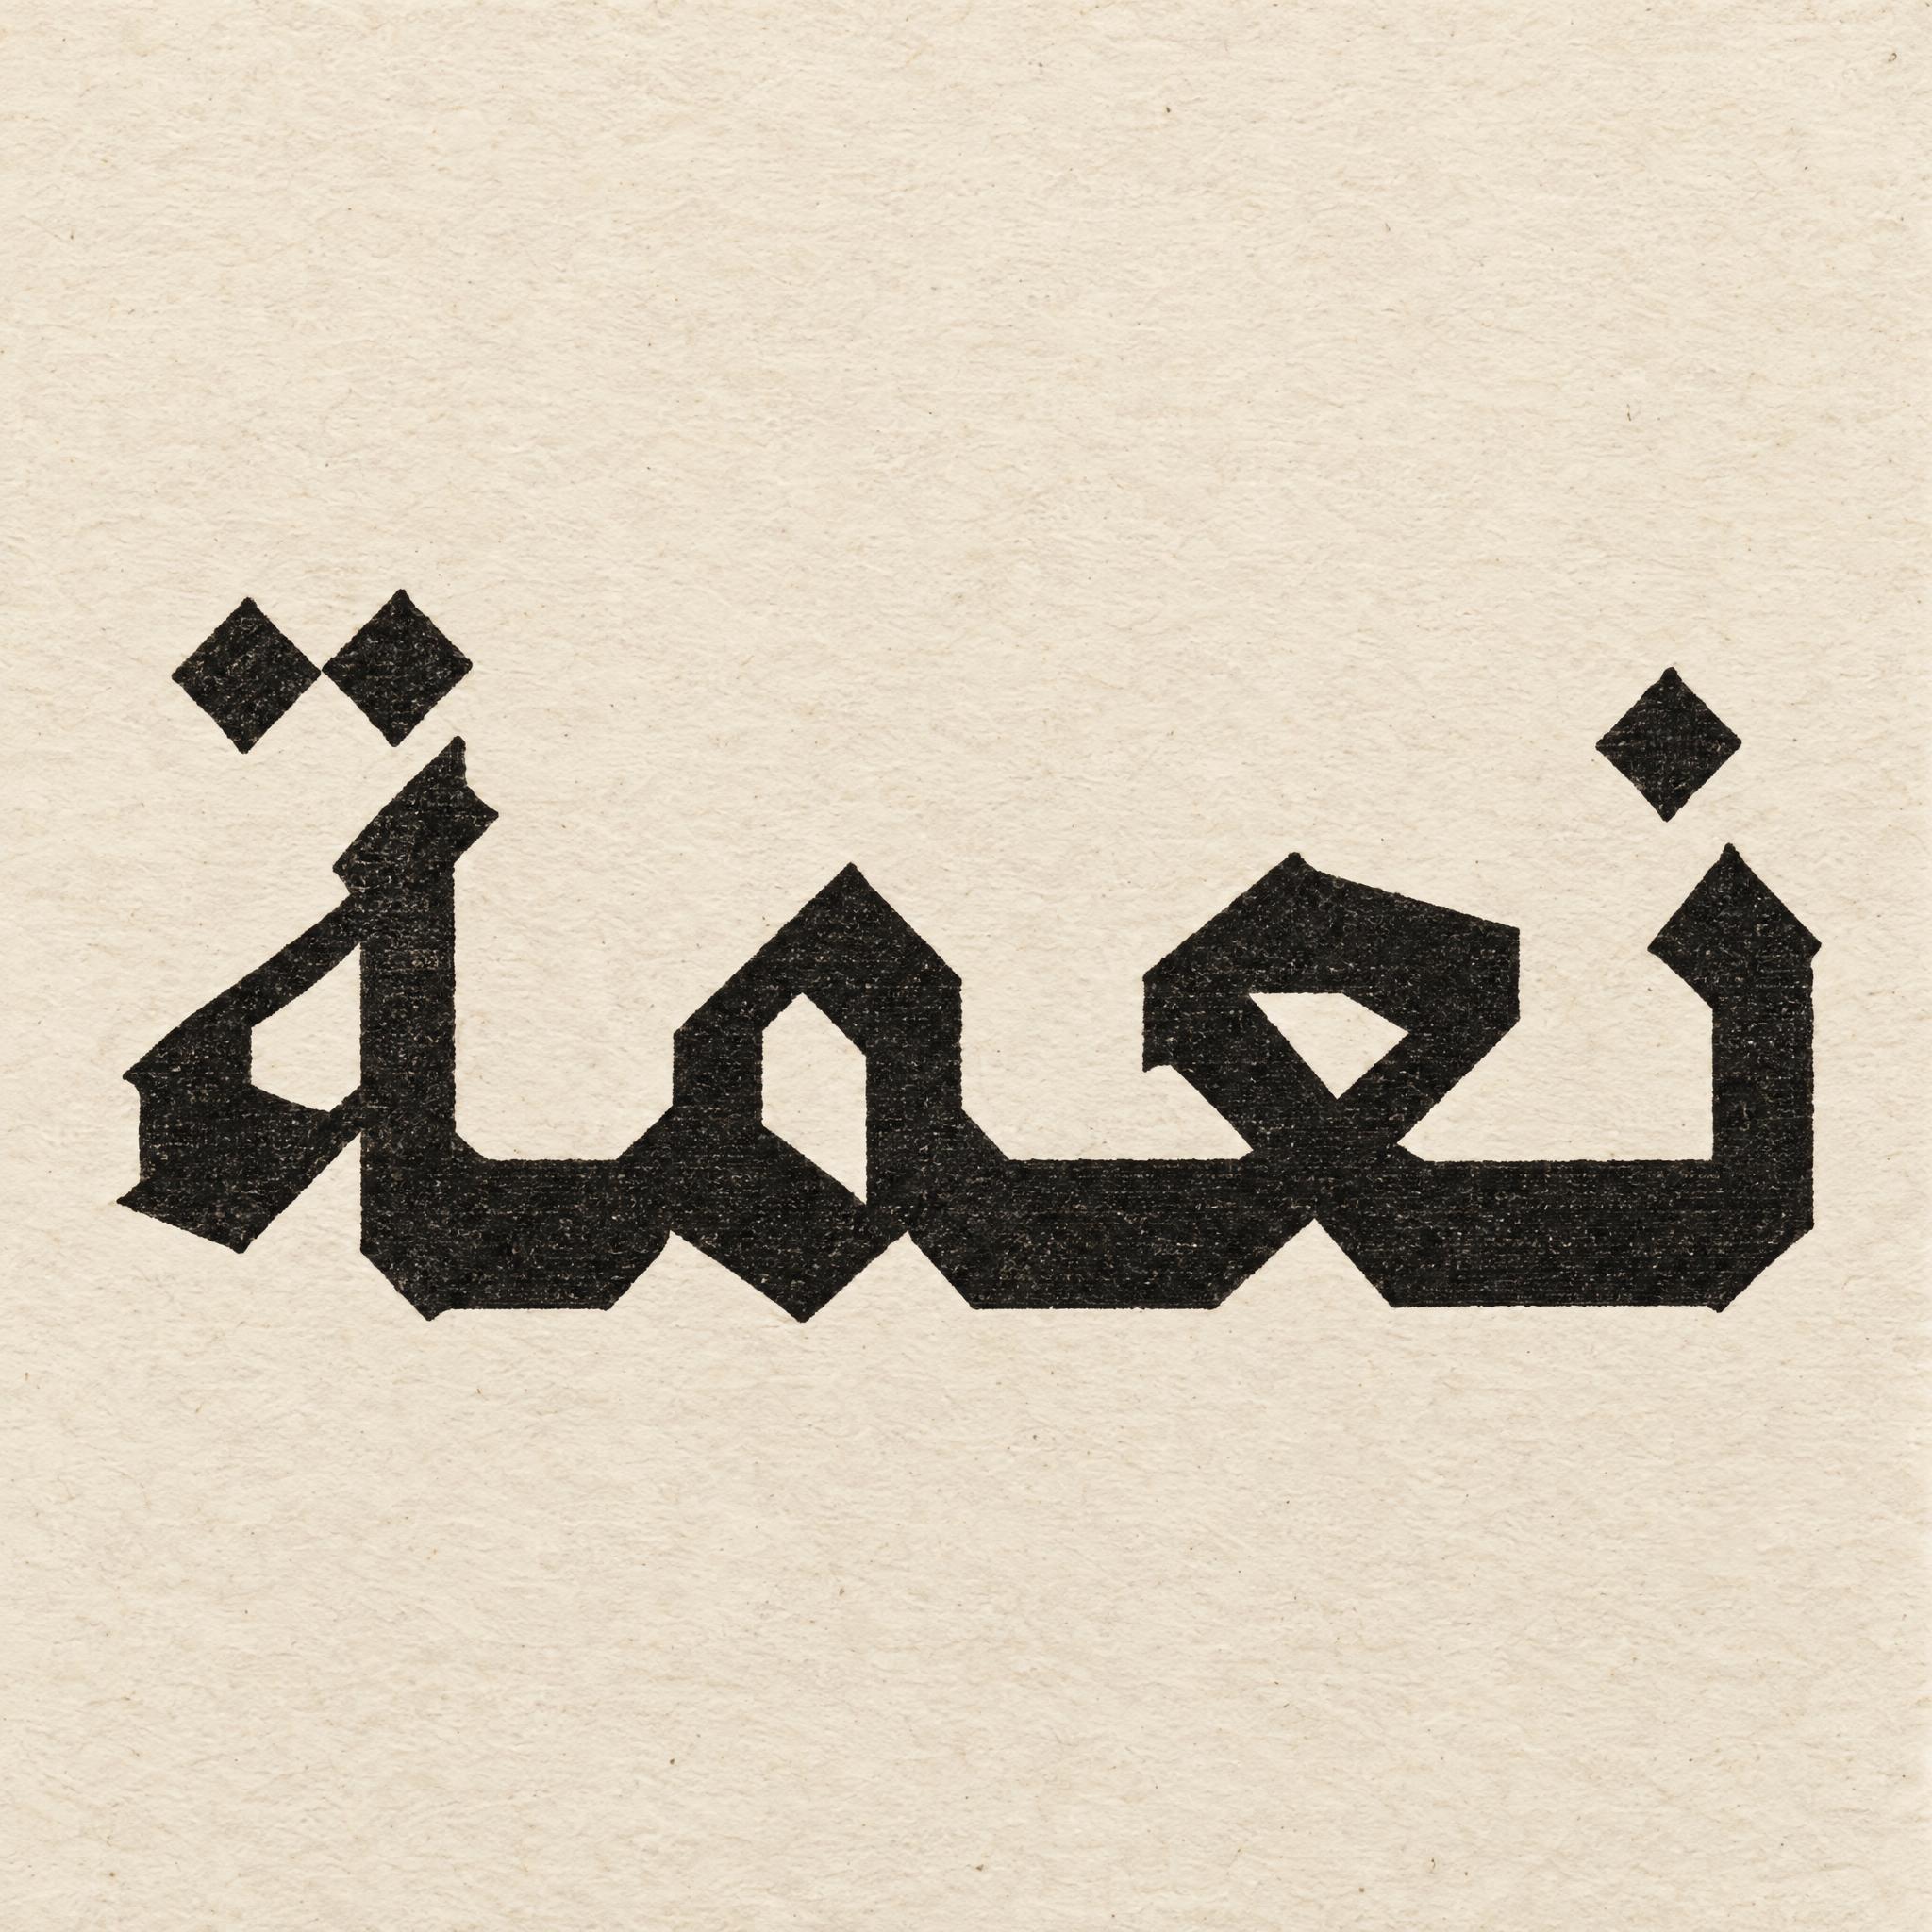
تعرض كل صفحة خط على AIFont نتائج النماذج الخمسة في كل لغة، فترى كيف يبدو النمط مكتوبًا قبل أن تنسخ موجّهه. ومجموعتا الخط القوطي وحروف الغرافيتي مكان مناسب لمقارنتها جنبًا إلى جنب.
البيانات مفتوحة
كل الصور الـ2,495 في مجموعة البيانات، مع الموجّهات والأحكام وملاحظات المراجعة، منشورة للعموم بترخيص CC BY 4.0: مجموعة بيانات AIFont لعرض النصوص على GitHub، ومؤرشفة على Zenodo (DOI 10.5281/zenodo.23815210). إذا كنت تقرأ العربية أو اليابانية أو أي لغة أخرى فيها ووجدت حكمًا خاطئًا، فافتح issue. تدخل التصحيحات في الإصدار التالي وفي هذا الجدول.
سنعيد إجراء المقارنة كلما صدرت أنماط ولغات جديدة، وعندما تتحدّث النماذج.
الأسئلة الشائعة
ما أفضل نموذج لتوليد الصور بالذكاء الاصطناعي لكتابة النصوص في 2026؟
في اختبارنا على 2,016 صورة، تعادل GPT Image 2.5 و Nano Banana 2.1 في الصدارة، فكتبا 401 و402 كلمة صحيحة من 404. الفرق بينهما صورة واحدة، فنعدّه تعادلًا. وبقي كلاهما فوق 95% في كل نظام كتابة اختبرناه، ومنها العربية.
أي نموذج لتوليد الصور بالذكاء الاصطناعي هو الأفضل للنص الياباني أو العربي؟
GPT Image و Nano Banana. في اليابانية كتب كلٌّ منهما 58 أو 59 كلمة صحيحة من 59، مقابل 45 إلى 52 للنماذج الثلاثة الأخرى. وفي العربية سجّلا 96% و100%، بينما سجّل Grok Imagine 71% و Seedream 57% و Qwen-Image 11%.
لماذا يخطئ Qwen-Image في كتابة النصوص؟
غالبًا لأنه يضيف نصًّا لم يطلبه أحد. في 40 من أخطائه كتب Qwen-Image الكلمة المطلوبة صحيحة، ثم ملأ الصورة بفقرة من الحروف الزائدة، كثيرًا ما تكون نسخة مشوّشة من الموجّه نفسه. وإعادة تشغيل الموجّه نفسه نادرًا ما تصلح ذلك.
هل بيانات الاختبار متاحة للعموم؟
نعم. كل صورة وموجّه وحكم وملاحظة مراجعة موجودة في مجموعة بيانات AIFont لعرض النصوص على GitHub و Zenodo بترخيص CC BY 4.0، ويمكن لأي شخص تقديم تصحيح.
انسخ الموجّه والصقه في ChatGPT أو Gemini أو أي نموذج صور، ثم ضع نصّك مكان النص.
تصفّح كل خطوط الذكاء الاصطناعي